
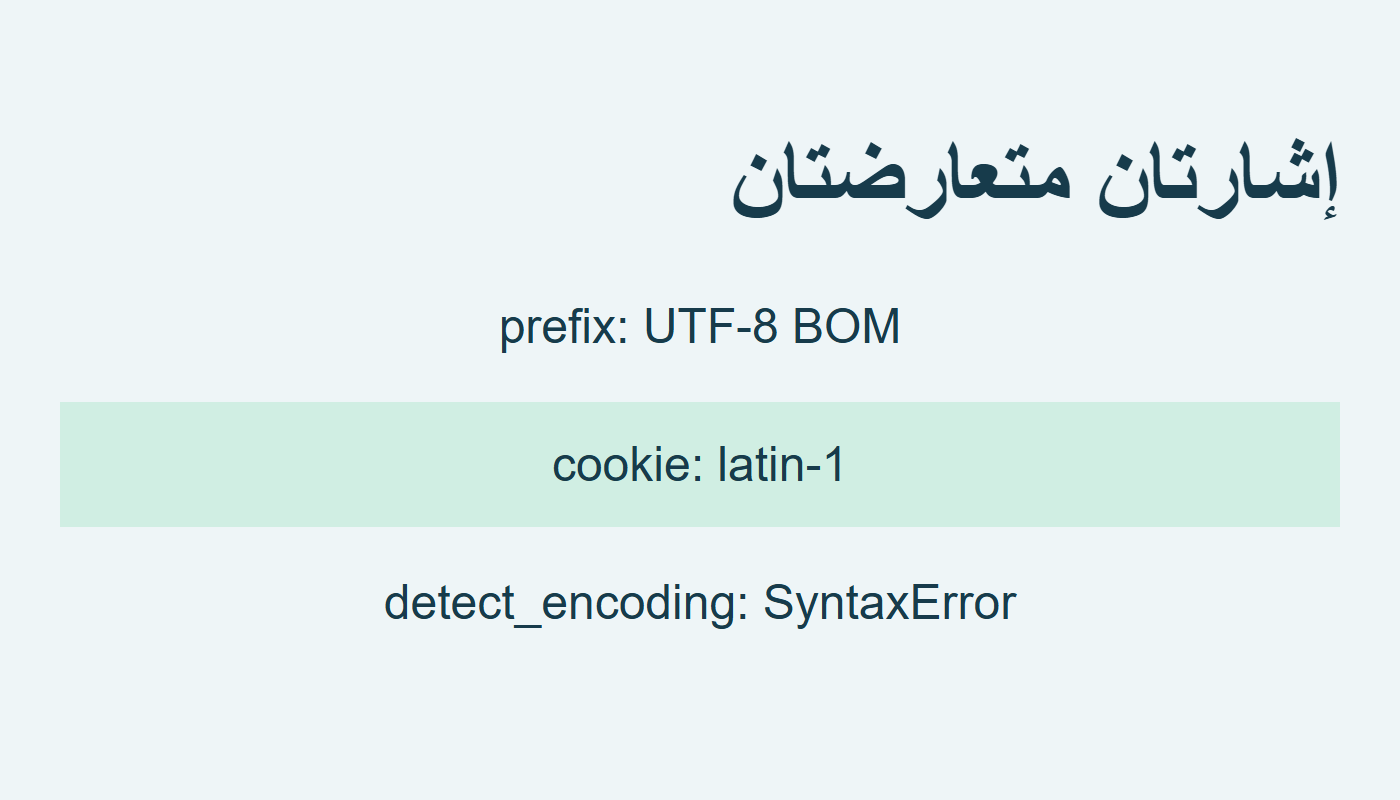
طابق إشارتَي الترميز قبل قراءة المصدر. [1] [2]
الخلاصة السريعة
المثال
from tokenize import detect_encoding
from io import BytesIO
from codecs import BOM_UTF8
p=b"# coding: latin-1\nx=7\n"
for b in (BOM_UTF8+p,p):
 try:
  r=detect_encoding(
   BytesIO(b).readline)
  print(r[0])
 except SyntaxError:
print("SyntaxError")رفض التعارض
المصدر يفحص العلامة ثم التعليق؛ لا يستبدل ترميزًا بآخر عند التعارض. المخرجان SyntaxError ثم iso-8859-1. يتعرف latin-1 بهذا الاسم المطبّع. [1] [2]
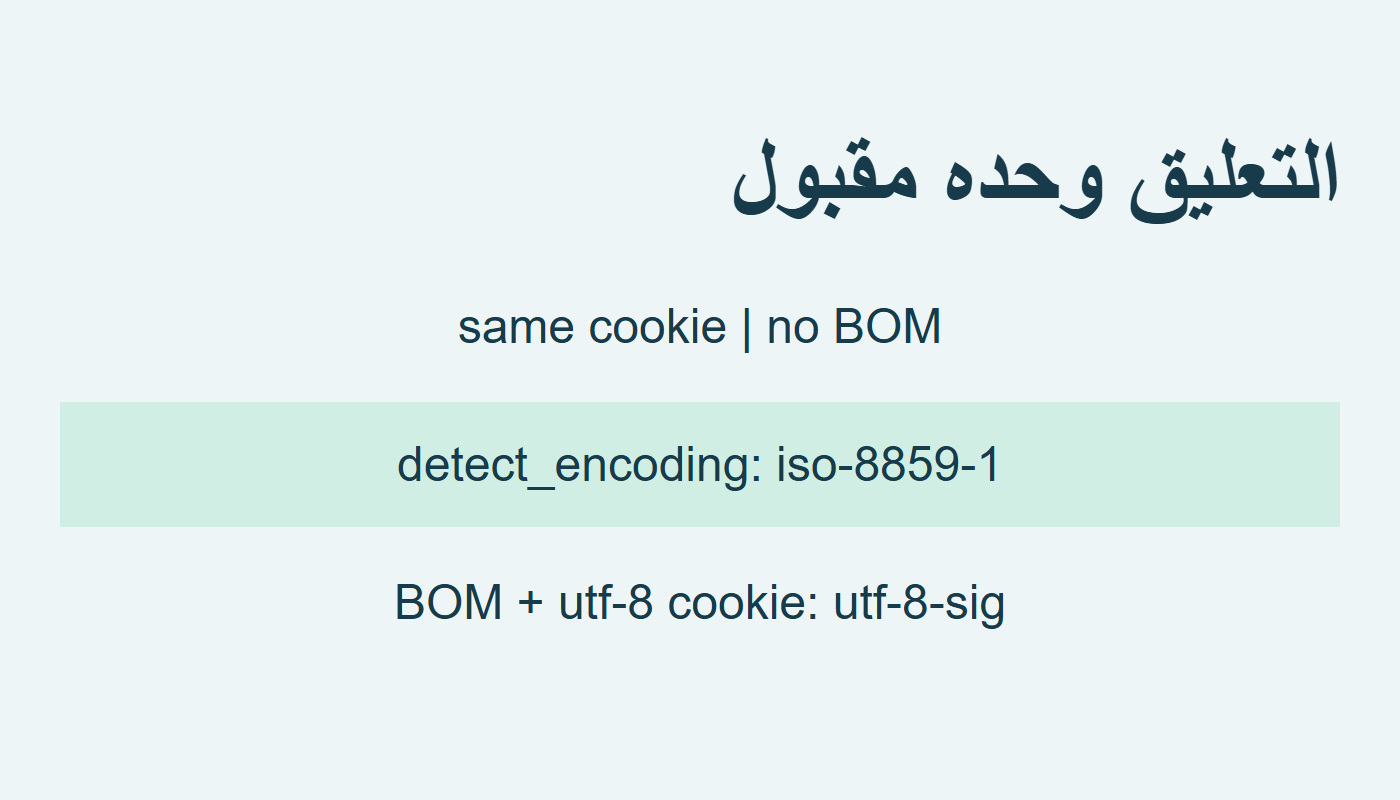
ضبط متوافق
استبدلنا latin-1 بـutf-8 في ضبط مستقل: أعطى utf-8-sig مع العلامة، وutf-8 دونها. هذه نتيجة كشف الترميز؛ لا تثبت صحة بقية الشيفرة. [1] [2]
المراجع
- Python 3.12: detect_encoding
- CPython 3.12.14: BOM and cookie checks
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.