
نماذج التجميع مع فئات نادرة قد تغير عينة كل عضو لتوازن حضور الفئات. يصف توثيق BalancedRandomForestClassifier سحب أمثلة من الفئة الأقل عددًا مع الإرجاع، وسحب العدد نفسه من الفئة الأكثر عددًا مع الإرجاع. [1]
الخلاصة السريعة
التوازن هنا في عينة بناء الشجرة، لا في نسبة الفئات التي تصل لاحقًا. السحب مع الإرجاع قد يكرر السجل؛ تكراره ليس حالة مستقلة جديدة، ولا يضمن نجاح المجموعة مع الفئة النادرة.
- حدد آلية المعاينة وإعداداتها صراحة؛ التوازن عبر سحب أمثلة يختلف عن إعطاء أوزان للفئات. [1]
- قد تحتوي عينة متوازنة على سجل نادر مكرر وسجل نادر غائب؛ توازن العدد لا يعني رؤية كل حالة نادرة.
- في مثالنا، تغيرت قائمة السجلات الشائعة بين شجرتين، بينما بقي العدد اثنين لكل فئة؛ ليست تجربة تحسين مقاسة.
- لا تصبح نسبة الفئة النادرة 50% في التشغيل لأننا وازنا عينة التدريب؛ افحص نتائج الفئة وأخطاء الإنذار على بيانات الاستخدام.
ما الذي تغيره المعاينة داخل المجموعة؟
يتيح التنفيذ تحديد sampling_strategy وreplacement، ويذكر أن المعاينة الداخلية تتولى الإرجاع عند replacement=True؛ bootstrap=False لا ينفي هذا الإرجاع الداخلي. [1]
نختار للمثال فئتين وإعدادات صريحة: sampling_strategy="all" وreplacement=True وbootstrap=False. لا نعتمد على حفظ قيم افتراضية من إصدار قديم. ونتابع قائمة السجلات التي تصل إلى كل عضو، بدل الاكتفاء بقول إن البيانات أصبحت متوازنة.
أما class_weight فخيار للأوزان في الواجهة. لا تساوِ تعديل الوزن بتغيير قائمة الحالات المسحوبة؛ هما قراران مختلفان، ويحتاج استعمالهما معًا إلى توثيق. [1]
التكرار لا يخلق حالة نادرة جديدة
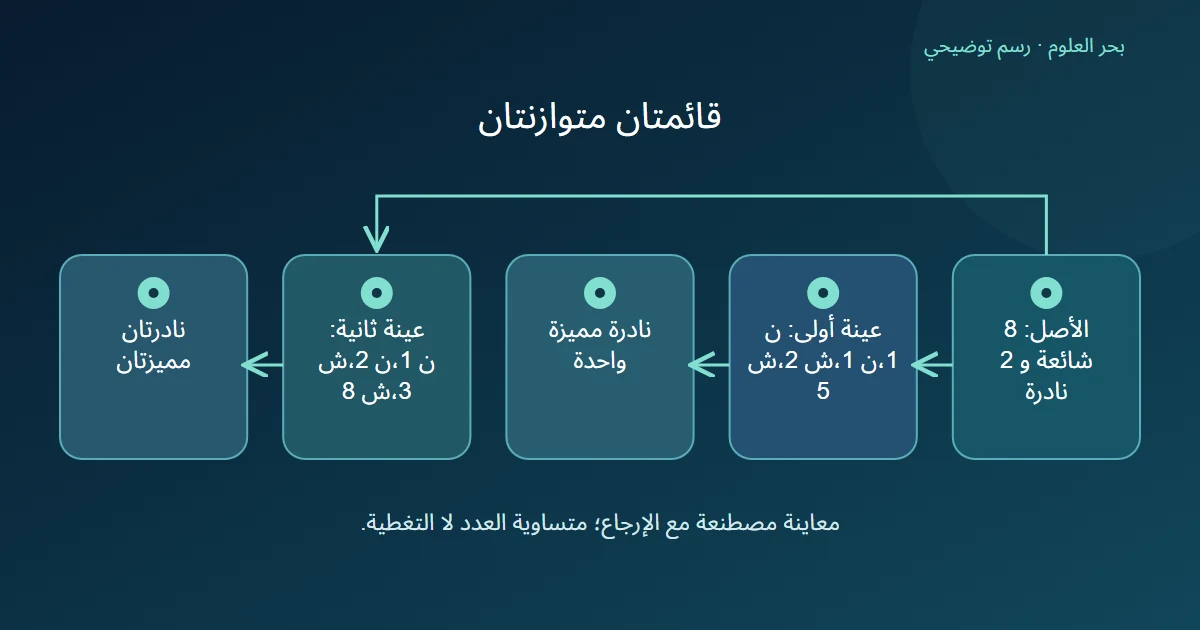
ننشئ عشرة سجلات: ثمانية من الفئة الشائعة نسميها ش 1 إلىش 8، واثنان من النادرة نسميهما ن 1 ون 2. افترض أن عينة الشجرة الأولى سحبت ن 1 ون 1، ومعهما ش 2 وش 5. عدد الأمثلة النادرة اثنان، لكن عدد السجلات النادرة المميزة واحد فقط.
لم تر الشجرة ن 2 في القائمة المفترضة، مع أنها متوازنة من حيث العدد: اثنان مقابل اثنين. لذلك لا يجيز توازن الأعداد الادعاء بأن كل مثال نادر ممثل في كل شجرة. ولا يعوض نسخ ن 1 غياب خصائص ن 2 إذا اختلفت الحالتان. هذا استنتاج من قائمتنا لا نتيجة دقة.
ماذا تتغير رؤيته عبر الأشجار؟
نفرض للشجرة الثانية قائمة ن 1 ون 2 وش 3 وش 8. صارت رؤيتها للسجلات مختلفة مع بقاء أربعة أمثلة موزعة بالتساوي. نقارن القائمتين في الجدول؛ اختيرتا للتوضيح، ولا نزعم أن تشغيلًا حقيقيًا أنتجهما.
هذه القوائم لا تثبت أن جميع السجلات الشائعة ستظهر عبر أي عدد محدود من الأشجار. كما لا تحدد تنبؤ الأوراق؛ لم نبنها أصلًا. التغيير الذي نستطيع الجزم به في المثال هو مادة التدريب المتاحة لكل شجرة وعدد السجلات المميزة فيها.
| العضو | النادرة المسحوبة | الشائعة المسحوبة | عدد النادرة المميزة |
|---|---|---|---|
| الأول | ن 1، ن 1 | ش 2، ش 5 | 1 |
| الثاني | ن 1، ن 2 | ش 3، ش 8 | 2 |
توازن التدريب لا يغير الواقع
في المجموعة الأصلية المصطنعة، النادرة 2 من 10، أي 20%. وفي كل قائمة بناء افترضناها، عددها 2 من 4، أي 50%. هذان مقامان مختلفان. لا نستنتج أن نسبة النادرة لدى مستخدمي النموذج تغيرت أو أن كل رقم احتمالي يخرجه سيكون معايرًا للنسبة الأصلية.
قيّم على حالات تمثل المهمة الفعلية، وافصل ما يصيبه النموذج من الفئة النادرة وما يعطيه من إنذارات خاطئة. لا تجعل نجاحه في عينة متوازنة تدريبًا دليلًا نهائيًا. احتفظ بإعدادات المعاينة والإصدار مع النتائج، لأن وصف «غابة متوازنة» وحده لا يكفي لإعادة معرفة قوائم البناء أو جودة المخرج.
المصادر ومتابعة القراءة
- imbalanced-learn: BalancedRandomForestClassifier (يفتح في نافذة جديدة)imbalanced-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.