
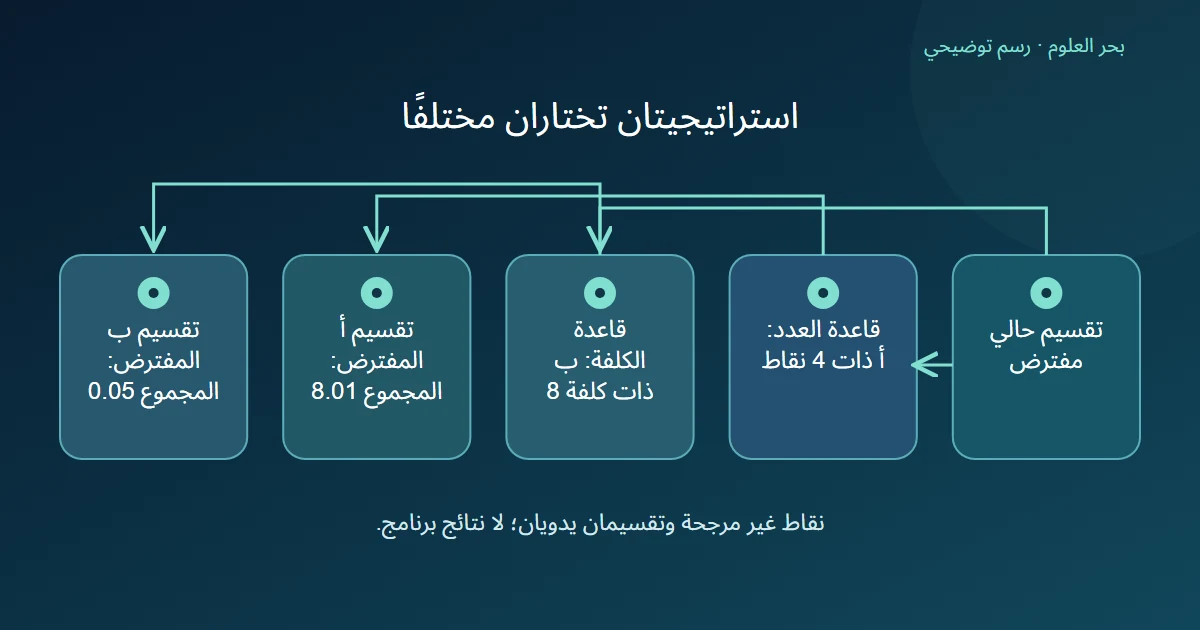
توثق BisectingKMeans استراتيجيتين لاختيار المجموعة التي ستقسم: أكبر عدد نقاط أو أكبر مجموع مربعات أخطاء. الافتراضية هي الثانية، biggest_inertia. [1]
الخلاصة السريعة
المجموعة الأكبر عددًا ليست دائمًا الأعلى كلفة. حدد استراتيجية اختيار المجموعة أولًا، ثم افحص كيف قسمتها الخطوة الداخلية إلى مجموعتين.
- largest_cluster تختار الأكبر عددًا، وbiggest_inertia تختار الأعلى كلفة مربعة؛ هذه الأخيرة الافتراضية في الواجهة المقروءة. [1]
- في التقسيم الحالي المفترض وغير المرجح، أ={0، 0.1، 0.2، 0.3} عددها 4 وكلفتها 0.05، وب={4، 8} عددها 2 وكلفتها 8.
- تقسيم أ إلى الزوجين المتجاورين يعطي كلفة كلية 8.01، وتقسيم ب إلى مفردتين يعطي 0.05؛ نفترض التقسيمين ولا ندعي أن المكتبة نفذتهما.
- اختيار المجموعة وتقسيمها الداخلي مرحلتان مختلفتان؛ الحساب المحدد لا يثبت أن استراتيجية تحقق أفضل نتيجة في كل ملف.
ما معنى «الأكبر»؟
تتيح الواجهة اختيار مجموعة وفق عدد النقاط أو وفق مجموع مربعات الخطأ، مع biggest_inertia افتراضيًا. [1] لذلك لا تكفي عبارة «تقسم أكبر مجموعة» دون ذكر مقياس الكبر.
نبدأ من تقسيم قائم افترضناه، وليس من الجذر أو من بيانات لائمناها. المجموعة أ فيها أربع قيم متقاربة، والمجموعة ب فيها قيمتان متباعدتان. ندرس قرار اختيار المجموعة للخطوة التالية.
يمكن تسجيل عمود للعدد وعمود للكلفة بجانب اسم كل مجموعة. قراءة العمود المناسب قبل اختيار الاسم تمنع تحويل قاعدة العدد إلى قاعدة تشتت دون قصد؛ ولا تحتاج هذه المقارنة إلى حكم على المعنى الحقيقي للمجموعات.
أكثر نقاط وأقل تشتت
قيم أ هي 0 و 0.1 و 0.2 و 0.3؛ مركزها 0.15. مربعات البعد 0.0225 و 0.0025 و 0.0025 و 0.0225، ومجموعها 0.05.
قيم ب هي أربعة وثمانية؛ مركزها ستة. مربعا البعد أربعة وأربعة، والكلفة ثمانية. نفترض أوزانًا متساوية ومسافة إقليدية على خط عددي؛ لا نضيف أي عقوبة لحجم المجموعة.
من ثم تختار قاعدة العدد أ، بينما تختار قاعدة الكلفة ب. إجمالي الكلفة الحالية 8.05، لكن هذا المجموع لا يحول عدد أ إلى كلفة؛ كل عمود يحتفظ بوحدته وطريقة حسابه.
ماذا يحدث تحت تقسيمين محددين؟
نفترض تقسيم أ إلى {0، 0.1} و{0.2، 0.3}. مركزا الزوجين 0.05 و 0.25، وكلفة كل زوج 0.005. تبقى ب كما هي بكلفة ثمانية، فيصبح المجموع 8.01.
في بديل آخر، نفترض تقسيم ب إلى مجموعتين مفردتين {4} و{8}. كلفتهما صفر، وتبقى أ بكلفة 0.05. صار المجموع 0.05. في الحالتين لدينا ثلاث مجموعات بعد الخطوة.
الحساب يقارن هذين التقسيمين بعينهما، لا نواتج تشغيل. لم نحدد بذور التهيئة أو نشغل الحل الداخلي، ولا نستنتج من المثال أن كل مجموعة أكبر كلفة ستنقسم بالمقدار نفسه.
قرار الاختيار لا يحدد جودة كل تشغيل
توضح الواجهة أن كل عملية تنصيف تستخدم تقسيمًا إلى اثنين، وأن n_init يحدد محاولات البداية الداخلية التي يقارنها التنفيذ. [1]
لهذا افصل سجل «أي مجموعة اخترنا» عن سجل «كيف قسمت». قد يكون اختيار ب واضحًا وفق الكلفة الحالية، بينما تبقى تفاصيل الحل الداخلي غير معروفة دون تشغيل محدد.
إذا عرضت المثال لقارئ، أبقِ كلمة «مفترض» بجانب التقسيمين والأوزان. التحسن هنا نتيجة القيم التي اخترناها، وليس قياس زمن أو دليل تفوق عام. المقارنة المفيدة تبدأ بمعيار واضح ومخرج قابل للمراجعة، ثم تربط النتيجة بالمهمة التي تريد إنجازها.
المصادر ومتابعة القراءة
- scikit-learn: BisectingKMeans (يفتح في نافذة جديدة)scikit-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.