
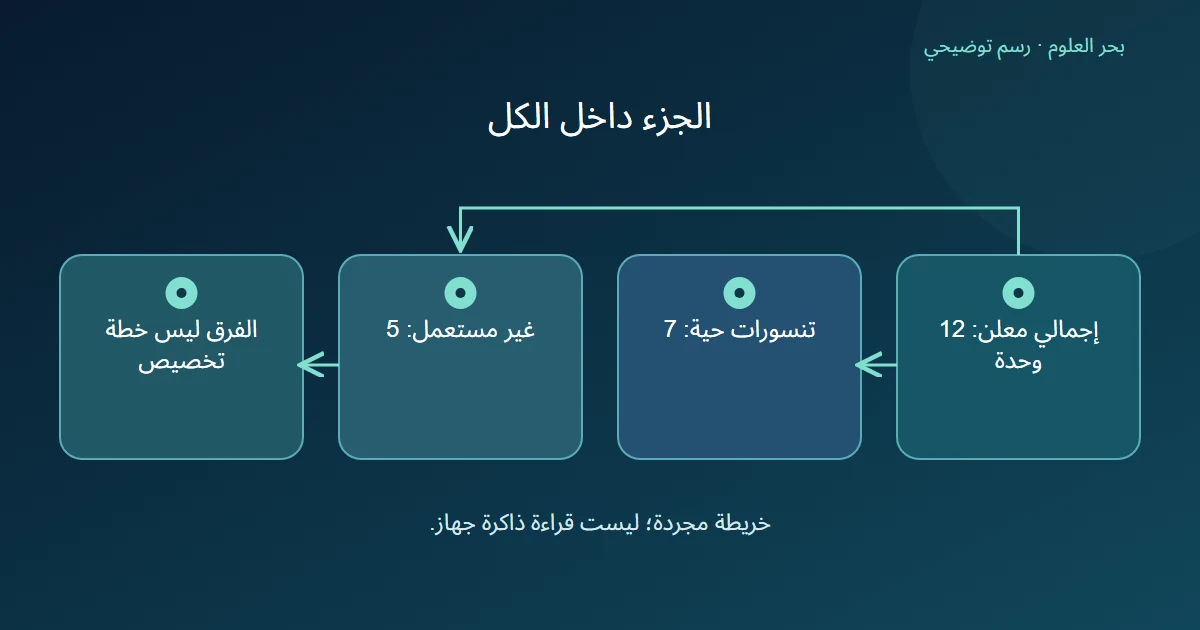
ذاكرة CUDA المحجوزة والمستخدمة تحتاج إلى تعريف الحقل قبل تشخيص رقم كبير. توثق PyTorch مراقبة ذاكرة التنسورات عبر memory_allocated وإجمالي ما يديره مخصص التخزين المؤقت عبر memory_reserved. [1] نضع بطاقات حسابية محدودة.
الخلاصة السريعة
لا؛ رقم المحجوزة يخص إجمالي يديره المخصص، وليس بالضرورة كله بيانات تنسورات حية. ولا يكفي الفرق لتقرير قبول تخصيص جديد أو حجم دفعة.
- تفرق الوثيقة بين ذاكرة تشغلها التنسورات وإجمالي يديره مخصص التخزين المؤقت. [1] سجل الحقل والجهاز واللحظة، ولا تسميهما الرقم نفسه.
- نعلن بطاقة محجوزة 12 وحدة وتنسورات حية 7؛ الفرق 5 في هذه الورقة. لا نضاعف السبعة فوق الاثنتي عشرة كأنهما مخزنان منفصلان.
- empty_cache يحرر الذاكرة المؤقتة غير المستعملة، ولا يحرر ذاكرة التنسورات المشغولة. [1] في فرعنا المعلن لا يحول إجراء على غير المستعمل السبعة إلى صفر.
- خمس وحدات إجمالية لا تصف توزيع المساحة أو قبول طلب متصل من أربع؛ المثال ليس قياس GPU أو اختبار نفاد ذاكرة، وبعض إحصاءات المخصص لها شروط خلفية تنفيذ. [1]
أي نطاق يغطيه كل اسم؟
تذكر PyTorch مخصصا ذا تخزين مؤقت، وتربط memory_allocated بما تشغله التنسورات وmemory_reserved بإجمالي ما يديره المخصص. [1]
نراجع الاسم واللحظة والجهاز قبل مقارنة قراءتين. لا نجمع رقما من جهاز مع آخر من جهاز مختلف ونفسر الفرق كأنه فراغ في مساحة واحدة. كذلك لا ننسب رقم المخصص تلقائيا إلى إجمالي كل ما يحتاجه النظام.
هذا درس في حدود الحقول، وليس في عد العناصر المنطقية داخل عروض تشترك في مخزن واحد. قد يحتاج التقرير إلى الدرسين، لكن معرفة مشاركة عرضين لا تعطينا وحدها قراءة مخصص CUDA أو ذروة استخدام نموذج.
اثنتا عشرة تشمل سبعًا في عقدنا
نؤلف بطاقة ذاكرة بوحدات مجردة: يدير المخصص 12، وتشغل التنسورات الحية 7 داخل هذه الاثنتي عشرة. نفترض أن الخمس الباقية غير مستعملة في البطاقة الحالية، ولا توجد فئة ثالثة داخل تقسيم الورقة.
الفرق 12 ناقص 7 يساوي 5. لم يصبح المجموع 19؛ فالسبع جزء من الاثنتي عشرة وليست مساحة مستقلة نضيفها إليها. هذه علاقة شمول أعلنّاها لشرح القراءة، لا قيما أعدتها دوال مكتبة.
ولا نسمي الخمس مساحة كل الجهاز المتاحة؛ خارج بطاقة المخصص لم نحدد أي استهلاك أو سعة. ولم نعلن أن المخصص يمكنه قبول أي حجم جديد أصغر من خمسة، لأن توزيعها وشروط الطلب لم يدخلا الحساب بعد.
ما الذي يخصه تفريغ التخزين المؤقت؟
توضح الوثيقة أن empty_cache يحرر الذاكرة المؤقتة غير المستعملة، أما ذاكرة GPU التي تشغلها التنسورات فلا تتحرر بهذا الاستدعاء. [1]
في فرع افتراضي نفترض تحرير الخمس غير المستعملة كلها من بطاقة المخصص مع بقاء التنسورات نفسها. تبقى مساحة التنسورات سبعا في هذا الفرع. لا نعلن أن تنفيذ الدالة على جهاز يعيد حتما مقدار خمسة أو يجعل كل مؤشر نظام ينخفض بخمس.
لو احتجنا إلى إنهاء حياة تنسور، فذلك سؤال مختلف عن تفريغ غير المستعمل. لا نقترح حذف بيانات لازمة لمهمة أو نستنتج عدم حاجتها من رقم ذاكرة كبير. المطلوب حفظ معنى العملية قبل اعتبارها إصلاحا.
هل يكفي الفرق لطلب جديد؟
نؤلف مخزنا مجردا غير تنفيذي توزعت فيه الخمس الفارغة إلى كتلتين منفصلتين بحجمين 2 و 3، ونعلن أن طلبا جديدا يحتاج كتلة واحدة من 4 ولا يسمح بضم الكتلتين. يفشل هذا الطلب تحت القاعدة المؤلفة، رغم أن مجموع الفراغ خمسة.
هذا ليس وصفا لخوارزمية مخصص PyTorch أو نتيجة OutOfMemoryError. يبين فقط أن المجموع وحده لا يحدد توزيع المساحة أو قاعدة القبول. لا نستنتج من البطاقة أن دفعة أكبر ستنجح أو أن هناك تسربا.
وتنبه الوثيقة إلى أن بعض الإحصاءات تخص backend:native ولا تكون ذات معنى مع cudaMallocAsync. [1] احفظ الخلفية والحقول الفعلية قبل تفسير تقرير. لم نخصص ذاكرة أو نشغل CUDA؛ الرسم يوضح حدود رقمين ونطاق ما لم نحسبه.
المصادر ومتابعة القراءة
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.