
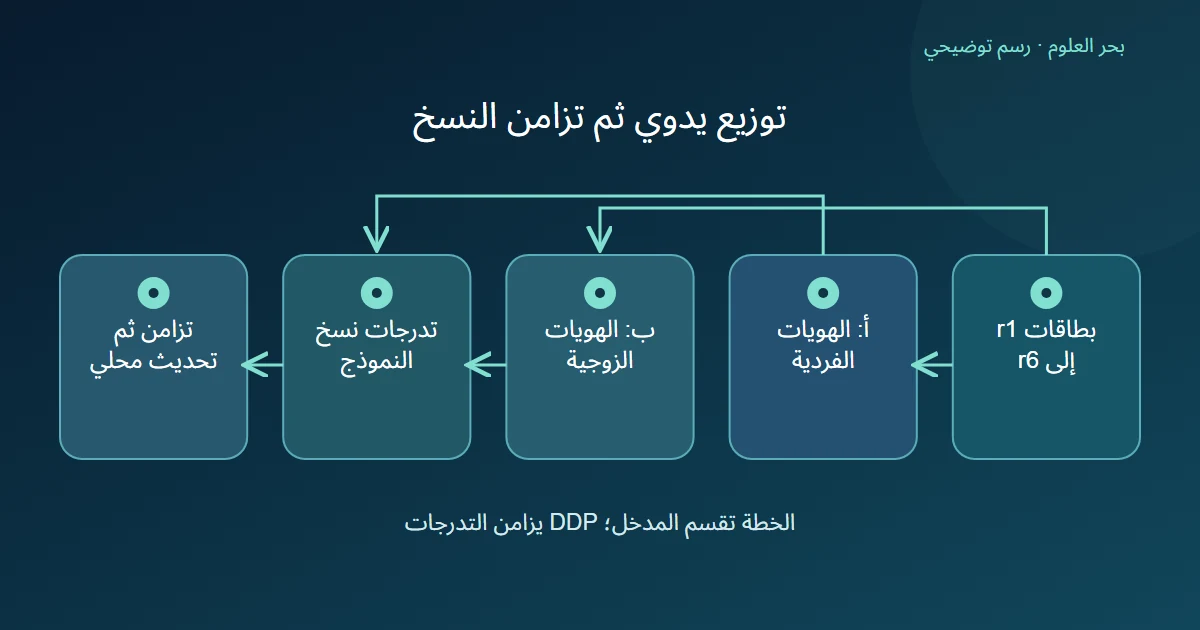
DDP وتقسيم المدخلات ليسا وعدًا واحدًا. تصف PyTorch الحاوية بأنها تزامن تدرجات نسخ النموذج، وتنبه إلى أنها لا تجزئ المدخل عبر الأجهزة بنفسها؛ يحدد المستخدم توزيع البيانات، مثل اختيار موزع مناسب. [1]
الخلاصة السريعة
حدد توزيع السجلات مستقلًا عن تزامن النسخ؛ وجود نسختين متزامنتين لا يثبت أن كل سجل عولج مرة واحدة أو أن البيانات قسمت كما أردت.
- تزامن DDP التدرجات بين النسخ، ويترك تقسيم المدخلات للمستخدم؛ إنشاء الحاوية يحتاج إلى تهيئة مجموعة العمليات. [1]
- في توزيعنا اليدوي لست بطاقات، أ تأخذ r1 وr3 وr5، وب تأخذ r2 وr4 وr6؛ الأجزاء لا تتداخل وتغطي السجلات الستة وفق هذا الاختيار فقط.
- إذا قرأت العمليتان القائمة كلها مرة واحدة، نحصل على 12 موضع معالجة لست هويات مختلفة؛ لا نكتب أن مجرد التزامن خلق 12 سجلًا مستقلًا.
- يصف التنفيذ خفضًا جماعيًا للتدرجات ويفترض تطبيق المحسن بالطريقة نفسها في العمليات؛ راجع توافق النموذج والخطوات، دون ضمان سرعة أو نجاح من الرسم. [1]
الحاوية لا تختار سجلات كل عملية
يوثق الإصدار المحدد تزامن التدرجات بين نسخ النموذج، وعدم تجزئة المدخل عبر الأجهزة؛ طريقة توزيع البيانات مسؤولية المستخدم. كما يلزم إنشاء مجموعة العمليات قبل الحاوية. [1]
نرسم عمليتين لهما نسختان من نموذج، ثم نسأل عن قائمة المدخلات التي ستقرأها كل منهما. هذا سؤال إعداد مستقل عن وجود آلية تزامن. لا نفترض أن تكرار غلاف حول نموذج واحد يغير قائمة ملفات البيانات تلقائيًا.
ولا نعد عدد الأجهزة دليلًا على خلو التدريب من تكرار الأمثلة. لتقييم التغطية نسجل هوية البطاقة وموضع استعمالها في كل عملية؛ أسماء الأجهزة لا تجيب عن هذين الحقلين.
وزع ست هويات بقاعدة معلنة
نختار بطاقات r1 إلى r6. في المثال اليدوي، العملية أ تقرأ الهويات ذات الأرقام الفردية، وب تقرأ الزوجية. كل قائمة تضم ثلاث بطاقات، ولا تشترك القائمتان في هوية؛ اتحادهما يغطي القائمة الأصلية.
سمينا هذه قاعدة يدوية اخترناها، وليست وعدًا بأن كل إعداد DistributedSampler يعطي أجزاء بلا تكرار في كل حجم بيانات. عند استعمال أداة فعلية نقرأ سياسة تقسيمها وأي إكمال أو إسقاط، ثم نفحص السجلات التي نتجت فعلًا.
لم نشغل عمليتين أو ننقل بطاقة. الجدول وصف خطة صغيرة يمكن مراجعتها، لا قياس معدل معالجة أو إثبات أن كل بطاقة ستدخل حساب خسارة ناجحًا.
| العملية | الهويات في خطتنا | العدد |
|---|---|---|
| أ | r1، r3، r5 | 3 |
| ب | r2، r4، r6 | 3 |
تكرار القائمة ليس زيادة الهويات
نفترض بديلًا واضحًا: كل عملية تقرأ البطاقات الست كاملة مرة واحدة في المرور نفسه. مجموع مواضع المعالجة 6 + 6 = 12، لكن عدد الهويات المختلفة يبقى 6. تكرر استعمال كل هوية مرتين وفق هذه الخطة.
هذا الفرق يؤثر في وصف التجربة قبل أي حديث عن جودة النموذج. لو كتب التقرير «اثنا عشر مثالًا مختلفًا» فقد خلط مرات الاستعمال بالبيانات المتميزة؛ إضافة مسار تزامن لا تصحح تسمية الأعداد.
ولأننا لم نعرف خسارة أو تدرجات للبطاقات، لا نحسب من التكرار وحده تغييرًا عدديًا في الوزن. المقارنة تعزل التوزيع والتغطية فقط، وتترك أثر الخسارة والتحديث لشروط أخرى يجب تعريفها.
التوافق أثناء التحديث سؤال آخر
يصف المصدر خفضًا جماعيًا للتدرجات، ويفترض تعديل المحسن للمعاملات بالطريقة نفسها عبر العمليات؛ ويحذر من اختلاف النموذج أو ترتيب تسجيل المعاملات. [1]
نراجع لذلك خطة المدخل وخطة النسخ معًا، دون دمجهما في ضمان واحد. نجاح توزيع الهويات لا يثبت توافق النماذج، وتوافق النسخ لا يثبت أن كل قائمة مدخل صحيحة أو كاملة.
لم نهيئ مجموعة عمليات أو نختبر تزامنًا أو سرعة. إذا طبق القارئ خطة فعلية، يحتاج إلى فحص ما قرأته كل عملية وما حدث في الخطوات. الرسم يحدد المسؤوليتين وأماكن التحقق، ولا يقدم نتيجة تشغيل موزع.
المصادر ومتابعة القراءة
- PyTorch 2.8: DistributedDataParallel documentation in source (يفتح في نافذة جديدة)raw.githubusercontent.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.