
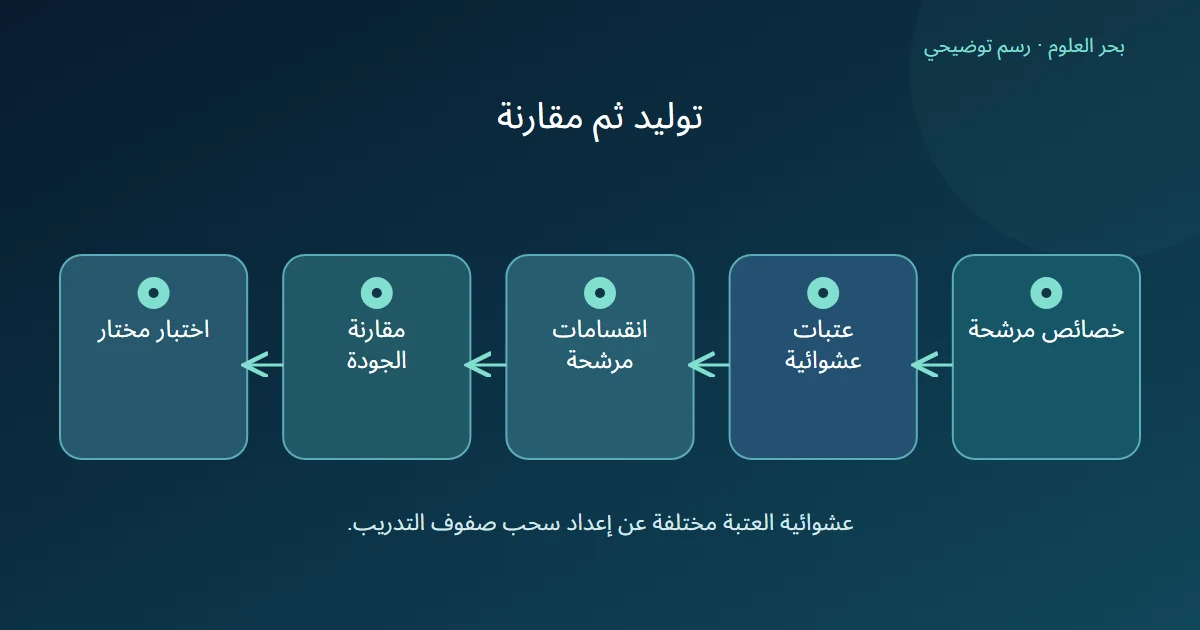
في Extra Trees والعتبات العشوائية لا يقتصر الاختلاف على اختيار خصائص مرشحة. يدخل الاختيار العشوائي في عتبة الاختبار أيضًا، ثم تقارن الخوارزمية الانقسامات المرشحة وفق معيارها. [1]
الخلاصة السريعة
ميز بين اختيار المرشحين واختيار أفضل انقسام من بينهم. العتبات العشوائية لا تعني تجاهل جودة التقسيم، ولا تعني بالضرورة تدريب كل شجرة على عينة مسحوبة مع الإرجاع. [1]
- توثق ExtraTreesClassifier اختيار عتبة عشوائية لكل خاصية معتبرة، ثم اختيار أفضل انقسام من المرشحين. [1]
- المثال يقارن سؤالين بعتبتين مصطنعتين؛ اختيار الأفضل بينهما لا يعني فحص كل عتبة ممكنة.
- في هذا التنفيذ يكون bootstrap=False افتراضيًا فتستخدم كل شجرة البيانات كلها؛ يمكن تغيير الإعداد. [1]
- قارن الجودة والتكلفة فعلًا؛ كلمة عشوائي لا تكفي للحكم على تفوق النموذج أو ضعفه.
أي جزء أصبح عشوائيًا؟
يشرح توثيق ExtraTreesClassifier اختيار عتبة عشوائية للخاصية، وتكرار ذلك للخصائص المعتبرة، ثم اختيار أفضل تقسيم ضمنها. [1]
تخيل عقدة تنظر إلى الطول والسمك لبطاقات مصطنعة. نضع للتوضيح سؤالًا عن الطول أكبر من 6، وسؤالًا عن السمك أكبر من 2. العتبتان هنا مفروضتان لشرح آلية المرشحين، ولا ندعي أنهما خرجتا من مولد عشوائي نفذناه. بعد تكوين السؤالين نقارن نتيجتي التقسيم بالمعيار المعتمد.
العشوائية لا تلغي المقارنة
إذا حصل السؤال الأول على تحسن مصطنع 0.08 والثاني على 0.13 وفق معيار نريد تعظيم تحسنه، نختار الثاني في هذا المثال. الأرقام من إعداد المقال. الاختيار مقيد بالمرشحين المعروضين، ولا يثبت أن العتبة 2 أفضل من كل عتبة أخرى يمكن تصورها.
لفهم الفرق، افصل مرحلتين في سجل العقدة: كيف تولدت الأسئلة المرشحة، وكيف اختير السؤال منها. قد تكون مرحلة التوليد عشوائية وتظل مرحلة المقارنة قائمة على الجودة. تسمية العملية كلها «قرارًا عشوائيًا» تجعل القارئ يظن أن البرنامج يتجاهل البيانات، وهو ما لا تصفه الآلية التي قرأناها.
هل تتغير عينات الصفوف أيضًا؟
في ExtraTreesClassifier يكون bootstrap=False افتراضيًا، وعند False تستخدم البيانات كلها لبناء كل شجرة. هذا إعداد مسمى، لا تعريف لكل برنامج يحمل اسم Extra Trees. [1]
أما RandomForestClassifier فيوثق bootstrap=True افتراضيًا. [2]
العشوائية في العتبة تختلف عن عشوائية سحب الصفوف. يمكن وصف تجربة بعبارتين: «عتبات عشوائية، ودون سحب مع الإرجاع»، أو تغيير إعداد العينات إذا كان التنفيذ يدعم ذلك. لا تستنتج وجود بطاقات غائبة عن كل شجرة من اسم الخوارزمية وحده؛ راجع الإعداد الفعلي ومعرفات العينات إن احتجت إليها.
ما المقارنة المفيدة؟
قارن النماذج على مهمة واحدة بمقياس واضح، وسجل الوقت والذاكرة وعدد الأشجار وتعقيدها. هذه خطوات مقترحة للقراءة والمقارنة، ولم نختبرها هنا. اجعل الفرق بين توليد العتبات وطريقة أخذ العينات ظاهرًا، حتى لا تنسب أي تغير إلى عامل غير معلوم.
قد يكون وصف سؤال واحد سهلًا بينما تبقى نتيجة المجموعة بحاجة إلى تحقق. لا تثبت الأرقام المصطنعة دقة Extra Trees ولا سرعة تدريبها. يوضح المثال فقط كيف يجتمع توليد أسئلة عشوائية مع اختيار مرشح مفيد، ولماذا تحتاج إعدادات التنفيذ إلى قراءة تتجاوز اسم النموذج.
المصادر ومتابعة القراءة
- scikit-learn: ExtraTreesClassifier (يفتح في نافذة جديدة)scikit-learn.org
- scikit-learn: RandomForestClassifier (يفتح في نافذة جديدة)scikit-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.