
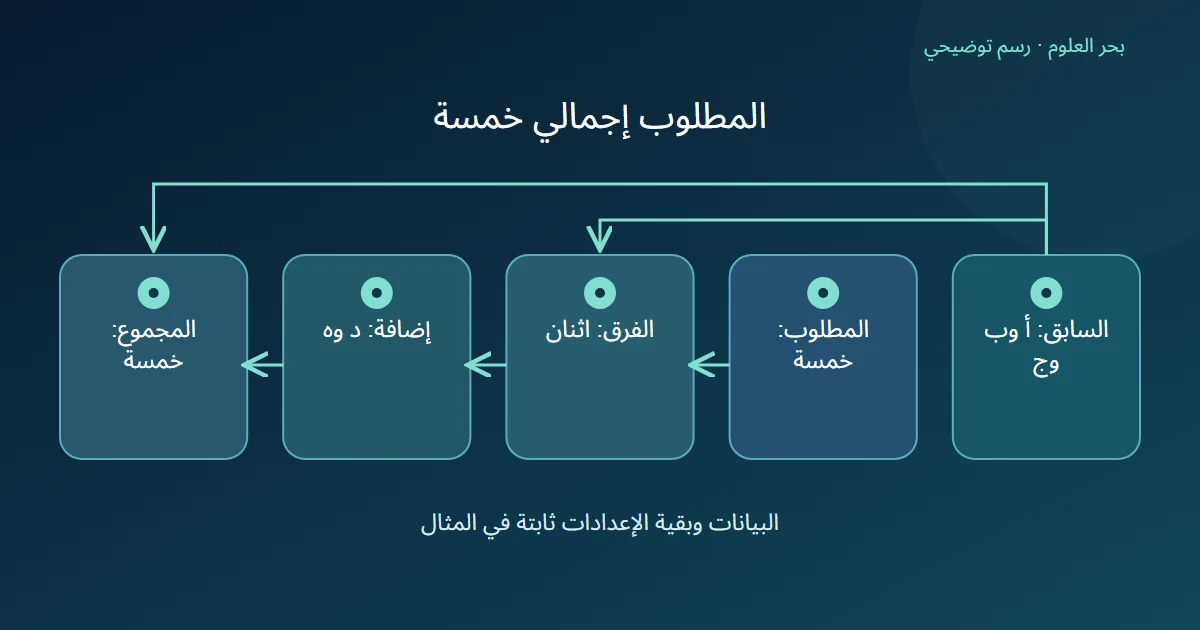
عند مراجعة زيادة أشجار الغابة مع warm_start، اسأل عن هوية الأشجار القديمة، لا عن العدد النهائي وحده. خمسة أسماء في قائمة قد تعني ثلاثة محفوظة واثنين جديدين، أو مجموعة جديدة كاملة. نقرأ الخيار ومسار الشيفرة ثم نحسب مثالًا معلنًا دون تدريب غابة.
الخلاصة السريعة
في خيار الاستمرار نبني المقارنة على ما بقي وما أضيف؛ زيادة العدد لا تعني إعادة بناء كل شجرة محفوظة.
- warm_start يبقي السابق ويضيف أشجارا. [1] بياناتنا وبقية الإعدادات ثابتة.
- إذا كان المحفوظ ثلاثة والمطلوب خمسة، فالفرق اثنان؛ نحتفظ بهويات أ وب وج، ونضيف د وه، لا خمس إضافات.
- في شيفرة 1.7.2 يصدر تحذير دون أشجار جديدة عند فرق صفر، وخطأ عند فرق سالب؛ الإضافة توسع القائمة السابقة. [2]
- بدون الاستمرار تعاد تهيئة قائمة الأشجار في الشيفرة. [2] احتفاظنا بالسابق لا يثبت تحديثه ببيانات جديدة أو تحسن التنبؤ؛ لم نشغل تدريبًا.
ماذا نثبت في مقارنة الزيادة؟
بدونه تدرب غابة جديدة. [1]
نعلن غابة تعليمية بنيت بالفعل في تصورنا، وفيها ثلاث أشجار نسميها أ وب وج. تثبيت البيانات وترتيبها ومعاني فئاتها وبقية الإعدادات جزء من مقارنة اخترناها لعزل العدد. لا نزعم أن كل تغيير آخر آمن لأن خيار الاستمرار موجود.
نسجل قبل العملية القائمة الحالية والعدد المطلوب والخيار الذي اخترناه. كلمة «استكمال» في اسم مجلد لا تحل محل الإعداد الفعلي، واسم الشجرة هنا رمز لهوية مفترضة لا بصمة ملف وجدناه. غرضنا قراءة حالة معلنة، وليس استعادة مشروع قائم.
كم شجرة تضيف حين تطلب خمسة؟
في مثالنا نطلب خمسة مع الإبقاء على الثلاث السابقة. خمسة ناقص ثلاثة يساوي اثنين. نسمي الإضافتين د وه؛ تكون القائمة بعد الإضافة أ وب وج ود وه. العدد خمسة إجمالًا، ولا نكتب ثمانية لأن المطلوب وصف الحجم النهائي.
أما وصف «غابة جديدة من خمسة» فله هويات أخرى نفرضها ن ور وز وح وط. قد يتساوى العدد في المسارين دون أن تتساوى المكونات. ولا نفترض أن الأشجار الجديدة مختلفة القيم حتما؛ الهوية المقصودة علاقة البقاء والإضافة، لا اختبار اختلاف التنبؤات.
يمكن عرض عمود للمحفوظ وعمود للمضاف ثم المجموع. حتى إذا اتفقت إجابة الغابتين على بطاقة واحدة، لا يجعل الاتفاق القائمة الجديدة استمرارًا للقائمة الأولى. لم نقدم أصلًا بطاقة تنبؤ أو درجات تسمح بمقارنة الجودة.
ماذا يحدث إذا لم يكبر المطلوب؟
تحسب شيفرة الإصدار 1.7.2 الفرق بين n_estimators وطول estimators_. الفرق السالب يرفع خطأ، والصفر يصدر تحذيرًا دون تدريب أشجار جديدة؛ ثم تلحق الأشجار الجديدة بالقائمة في فرع الزيادة. [2]
بعد وصول مثالنا إلى خمسة، طلب خمسة مرة أخرى يترك فرقًا صفرًا في هذا الحساب. طلب أربعة يعطي سالب واحد. لا نصف الطلب الأصغر بأنه تقليم شجرة واحدة، ولا نحول التحذير إلى خبر تدريب مجموعة جديدة. هذه قراءة للفروع الموثقة، وليست رسائل التقطناها من تنفيذ.
كذلك لا نستنتج أن عدم إضافة شجرة يعني أن كل جزء من استدعاء fit لا يفعل أي عمل. حد كلامنا هو بناء أشجار جديدة في هذا الفرع. الفحص والتحقق وحقول أخرى أسئلة منفصلة إذا أردنا مراجعة تنفيذ كامل.
ما الذي لا تثبته الأشجار المحفوظة؟
عند تعطيل warm_start أو غياب القائمة السابقة، تبدأ الشيفرة بقائمة estimators_ خالية. [2]
في مسارنا المعلن، بقاء أ وب وج ليس تصريحًا بأنها تعلمت صفوفًا أضفناها لاحقًا. لم نغير البيانات في المقارنة، ولا نقدم هذه الآلية بديلًا تلقائيًا لتحديث كل شجرة أو لتعلم دفعة جديدة. لو تغير تعريف الفئات أو الأعمدة، نراجع عقدًا جديدًا بدل إسقاط المثال عليه.
قبل عمل فعلي، نوثق الإصدار ومصدر البيانات والقائمة قبل الزيادة وبعدها، ثم نقيس ما نريد من دقة وتكلفة فعلًا. الرسم يوضح ثلاث هويات محفوظة وإضافتين، ولا يثبت أفضل عدد أو نجاح التدريب أو تطابق البذور عبر بيئات مختلفة.
المصادر ومتابعة القراءة
- scikit-learn: RandomForestClassifier (يفتح في نافذة جديدة)scikit-learn.org
- scikit-learn1.7.2: forest fit implementation (يفتح في نافذة جديدة)raw.githubusercontent.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.