
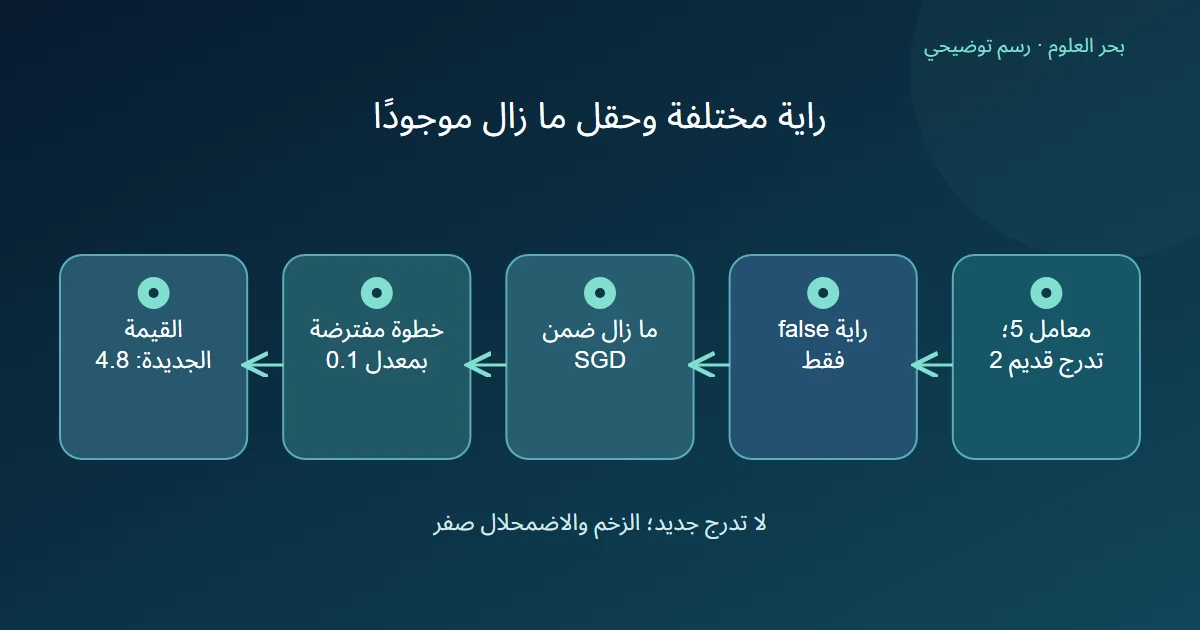
requires_grad والتدرج المخزن ليسا حقلًا واحدًا. في PyTorch 2.8، يغير ضبط راية التدرج الراية، بينما يحتفظ وصف الحالة بحقل grad منفصل. ويختار SGD المعاملات ذات التدرج غير None للتحديث. [1][2]
الخلاصة السريعة
عند تجميد معامل بعد حساب تدرجه، افحص التدرج المتبقي وعضويته في المحسن وإعداد التحديث؛ تغيير الراية وحده ليس وصفًا كاملًا للحالة التي سيقرأها المحسن.
- يبين التنفيذ حالة راية requires_grad وحقل grad المنفصل؛ تغيير الراية لا يتضمن محو ذلك الحقل في المسار الموثق. [1]
- نفترض معاملًا ورقيًا عاديًا قيمته 5 بقي في مجموعة SGD، وتدرجه القديم 2؛ بعد تعطيل الراية فقط، معدل 0.1 بلا زخم أو اضمحلال يعطي 4.8 إن نفذت الخطوة بهذا التدرج.
- في SGD الموثق، None يستبعد المعامل من الخطوة؛ أما تدرج صفر فقد يسمح بتأثير اضمحلال الوزن إذا كان مفعّلًا. [2]
- راجع توقيت التجميد والتدرج وعضوية المحسن قبل وبعد الخطوة؛ لا نستنتج من راية واحدة غياب كل تغير أو سلوك جميع المحسنات.
راية التدرج وحقل التدرج السابق
تعرض البنية grad_ منفصلًا عن requires_grad_؛ دالة ضبط الراية تسند قيمتها ولا تمحو grad_. هذه قراءة لشفرة الإصدار المحدد، لا نتيجة تجربة عامة على أي امتداد مخصص. [1]
نختار معاملًا ورقيًا عاديًا حقيقي النوع، سبق أن خزن تدرجًا من مرور سابق. ثم نغير الراية إلى false. لا نحسب backward جديدًا في هذا المثال، فلا نقول إن التعطيل أنتج تدرجًا جديدًا.
السؤال أدق: ما الذي بقي في الحقل قبل أن يقرأه المحسن؟ نميز إيقاف حساب لاحق من إزالة معلومة موجودة بالفعل. وقت ضبط الراية جزء من السيناريو، فلا ننقله إلى بداية دورة نظيفة ونحتفظ بالنتيجة نفسها دون فحص.
الخطوة قد تقرأ أثر المرور السابق
نختار SGD للتقليل، بمعدل 0.1 وزخم صفر واضمحلال وزن صفر، ومعاملًا قيمته 5 وتدرجًا مخزنًا 2. نفترض أنه ما زال عضوًا في مجموعة المحسن ولم يتغير هذا الحقل بعد تعطيل الراية.
الشفرة تجمع المعامل عندما يكون grad غير None؛ ثم يطرح التحديث معدل التعلم مضروبًا في التدرج. [2]
في هذه الحالة اليدوية، 5 − 0.1 × 2 = 4.8. التغير جاء من تدرج متبقٍ افترضنا وجوده، لا من عملية تفاضل بعد التجميد. ولم نشغل Tensor أو optimizer؛ تابعنا قاعدة منشورة تحت إعدادات صريحة.
الصفر ليس غياب التدرج
نكرر المقارنة بمعامل يبدأ من 5، مع الزخم صفر. لو كان grad=None يتجاوزه المسار الموثق، فلا يطرح منه شيئًا في هذه الخطوة. أما قيمة صفر فهي تدرج موجود يمر بشرط عدم None. [2]
نختار الآن اضمحلال وزن 0.1، ومعدل 0.1، وتدرجًا صفريًا. يضاف إلى التدرج 0.1 × 5 = 0.5، ثم يطرح 0.05 من المعامل، فيصبح 4.95. شرط انعدام الاضمحلال في المقارنة السابقة كان مؤثرًا.
هذه مقارنة لثلاث حالات محددة، ولا تعني أن None والصفر يتصرفان بهذه الصورة في كل خوارزمية أو أن تنظيف التدرج وحده يصحح أي خطة تجميد.
| حالة grad | الاضمحلال المختار | القيمة بعد الخطوة المفترضة |
|---|---|---|
| 2 متبقٍ | 0 | 4.8 |
| None | 0.1 | 5؛ متجاوز |
| صفر | 0.1 | 4.95 |
اكتب خطة التجميد كاملة
في مراجعة تطبيق فعلي، حدد أي معاملات ستتعلم وأيها ستبقى ثابتة، ومتى تغير الرايات، وماذا حدث لتدرجات سبق حسابها. ثم افحص المجموعة التي سيمر عليها المحسن وإعداداته، بدل الاكتفاء بصورة لراية false.
إذا كان المطلوب ثبات قيمة، قارنها قبل الخطوة وبعدها مع توثيق الحقول المقروءة. لا يكفي أن نرى غياب تدرج جديد، ولا أن تدرجًا كان صفرًا في لحظة، لننسب الثبات إلى كل إجراء لاحق.
لم نجمد نموذجًا أو نقس ذاكرة أو سرعة أو جودة تعلم. المقال يحدد حالة حدية قد تخفيها كلمة «تجميد»، ويترك تحقق التنفيذ الفعلي وإعداد المحسن للبيانات والشفرة الموجودة في المشروع.
المصادر ومتابعة القراءة
- PyTorch 2.8: AutogradMeta gradient and requires_grad fields (يفتح في نافذة جديدة)raw.githubusercontent.com
- PyTorch 2.8: SGD gradient membership and scalar update (يفتح في نافذة جديدة)raw.githubusercontent.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.