
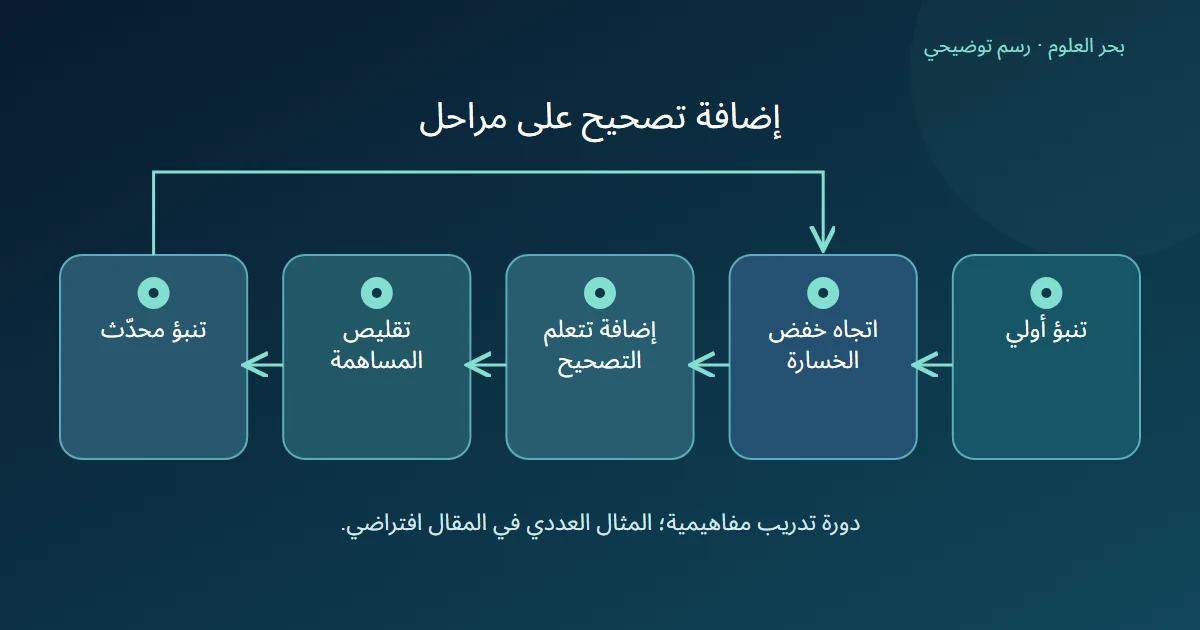
التعزيز التدريجي، أو تعزيز التدرج، يبني نموذجًا بإضافة نماذج صغيرة بالتتابع لتحسين التنبؤ. تعتمد الإضافة الجديدة على أداء المجموعة السابقة، وغالبًا تكون النماذج المضافة أشجار قرار. [1]
الخلاصة السريعة
يضيف التعزيز التدريجي تصحيحات متتابعة لتقليل دالة خسارة، لكن تحسن التدريب لا يضمن تحسن الأداء على بيانات جديدة. [1]
- يبدأ التدريب بتنبؤ أولي ثم يبني إضافات تعتمد على المجموعة السابقة، بدل تدريب كل الأشجار استقلاليًا. [1]
- تستهدف الإضافة اتجاه خفض الخسارة؛ تطابق التصحيح مع المتبقيات يرتبط بالخسارة. [2]
- يقلص معدل التعلم مساهمة الإضافة الجديدة؛ المثال العددي يوضح هذه الفكرة دون تجربة مدربة. [1]
- زيادة المراحل قد تسبب فرط التخصيص؛ يساعد تتبع بيانات التحقق على تحديد التوقف. [3]
ما الفرق بين الإضافات المتتابعة وجمع الأصوات؟
كل مرحلة في التعزيز تبني على المجموعة المتاحة قبلها. لذلك ليست الفكرة عدّ أصوات أشجار مستقلة. مجموعة التصحيحات تصبح نموذجًا واحدًا يستخدم إضافاتها عند التنبؤ. [1]
لتصوّر الفرق، تخيل فريقًا يقدّم تقديرات مستقلة، وفريقًا يراجع مسودة تقدير مشتركة على مراحل. في الفريق الثاني يسأل المراجع: ما الجزء الذي ما زال يحتاج تعديلًا؟ التشبيه يشرح ترتيب العمل فقط؛ لا يجعل الخوارزمية قارئًا يفهم أسباب الخطأ بلغة بشرية.
هل تتعلم الشجرة الخطأ العددي نفسه دائمًا؟
يتعلق الهدف باتجاه خفض الخسارة، أي التدرج السالب. ومع الخسارة التربيعية يرتبط هذا الاتجاه بالمتبقيات: القيمة الفعلية ناقص التنبؤ. [2]
لا تختصر عبارة «تصحيح الأخطاء» إلى إعادة تسمية الأمثلة الخاطئة فقط. السؤال الذي ينبغي طرحه على أي تنفيذ هو: ما الخسارة التي يحاول تقليلها؟ معرفة الاسم تمنع استعمال مثال طرح بسيط لشرح جميع طرق التصنيف والانحدار. [1]
مثال: تعديل تقدير بمساهمة محدودة
في مثال حسابي من إعداد المقال، لدينا تقدير أولي مقداره 10 وحدات، بينما القيمة المطلوبة في المثال 14 وحدة. المتبقي هو 14 − 10 = 4 وحدات. لنفترض أن إضافة جديدة تقترح تصحيحًا مقداره 4، وأن معدل التعلم 0.25؛ تصبح مساهمتها 0.25 × 4 = وحدة واحدة، فيرتفع التقدير إلى 11.
المثال لا يثبت أن شجرة حقيقية ستتعلم التصحيح أربعة بدقة. افترضنا ذلك لعزل أثر معدل التعلم، وهو مقدار مساهمة الإضافة لا نسبة دقة النموذج. يتبقى فرق قدره ثلاث وحدات في هذه الحالة، لكن لا يجوز حساب كل المراحل التالية بالطريقة نفسها دون معرفة ما ستتعلمه الإضافات اللاحقة.
إذا قرأت جدول تجربة، فصل بين عمود التنبؤ السابق وعمود التصحيح المقترح وعمود التنبؤ الجديد. هذا الترتيب يكشف هل أضيف التصحيح كاملًا أم تقلص، ويساعدك على اكتشاف الخلط بين قيمة الخطأ وقيمة التنبؤ النهائي.
متى تتحول المراحل الإضافية إلى عبء؟
يحدد معدل التعلم مساهمة الأشجار. عدد أكبر من المراحل أو أشجار أكثر تعقيدًا قد يزيد فرط التخصيص. [1] يساعد الإيقاف المبكر بمراقبة أداء التحقق، لا نجاح التدريب وحده. [3]
قبل المقارنة، اكتب قاعدة التوقف ومقياس النجاح الذي يهم المهمة. فإذا اخترت النموذج لمجرد أنه جعل خطأ التدريب أصغر، لم تجب بعد عن سؤال القارئ: هل سيتنبأ بصورة أفضل بحالات لم يرها؟ احتفظ أيضًا بزمن التنبؤ في المقارنة، لأن الإصدار الذي يخدم الهدف يجب أن يفي بمتطلبات التشغيل المحددة.
المصادر ومتابعة القراءة
- IBM: Gradient boosting (يفتح في نافذة جديدة)ibm.com
- scikit-learn: Gradient-boosted trees (يفتح في نافذة جديدة)scikit-learn.org
- scikit-learn: GradientBoostingRegressor — early stopping (يفتح في نافذة جديدة)scikit-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.