
في التعزيز والبيانات الشاذة، لا يكفي عد الأخطاء؛ شكل الخسارة يحدد كلفتها. عندما تكون الفجوتان 1 و 6، ينتج التربيع 1 و 36، بينما ينتج أخذ المقدار المطلق 1 و 6. لذلك نحتاج فهم ما يطلب النموذج تقليله.
الخلاصة السريعة
يتيح GradientBoostingRegressor خسائر squared_error وabsolute_error وhuber. المطلقة موصوفة بأنها متينة، وHuber تجمع سلوكًا تربيعيًا وخطيًا؛ لا يعني ذلك انعدام أثر الأخطاء الكبيرة. [1] [2]
- الخطأ الكبير يأخذ كلفة أسرع نموًا عند التربيع؛ مثال 1 و 6 يبين فرقًا حسابيًا، ولا يثبت أن السجل الكبير خطأ في البيانات.
- الخسارة المطلقة خيار متين في النموذج الموثق، لكنها لا تعطي الخطأ الكبير كلفة صفرية. [1]
- تكون Huber تربيعية داخل عتبة delta وخطية خارجها. عتبة مثالنا ليست معامل alpha في GradientBoostingRegressor. [1] [2]
- راجع هدف التقدير والحالات الكبيرة فعلًا؛ خفض أثرها لا يثبت صحة تنبؤات المجموعة أو ضرورة حذف سجلات.
التضخم الحسابي لا يشخص السجل
لنستعمل توقعات زمنية مصطنعة، ونفترض خطأ بمقدار دقيقة في حالة وست دقائق في أخرى. إذا حسبنا مربعيهما دون عامل نصف، نحصل على 1 و 36. حاصل النسبة 36، مع أن نسبة مقدار الخطأ الأصلي 6. هذه مقارنة حسابية أنشأناها وليست نتيجة تدريب.
لا تكفي فجوة الست دقائق لتسميتها خطأ إدخال. ربما كان التقدير ضعيفًا، وربما كانت الحالة استثنائية صحيحة، وربما أخطأنا وحدة الوقت. تغيير الخسارة يغير كلفة الفجوة؛ لا يجيب وحده عن سببها. افصل سؤال تأثيرها في الهدف عن سؤال موثوقية سجلها.
ماذا يتغير مع المقدار المطلق؟
يصف مرجع GradientBoostingRegressor خسارة absolute_error بأنها متينة للانحدار. [1]
في الحالتين نفسهما، الكلفتان المطلقتان 1 و 6. ما زالت الثانية أكبر؛ لذلك عبارة «لا يتأثر بالقيم الشاذة» أوسع من هذا الحساب. الفرق الذي أثبتناه أن التربيع لم يعد يضاعف حجمها بهذه الطريقة، لا أن السجل اختفى من المسألة.
إذا أضفنا عشر حالات أخرى أو غيرنا موازنة الحالات، نحتاج إعادة حساب الهدف الكامل. لا ننقل مقارنة فجوتين إلى حكم شامل على تنبؤ المجموعة. وقد يكون الاهتمام الشديد بالأخطاء الكبيرة مطلوبًا في المهمة؛ يجب شرح ما نعده خسارة قبل تفضيل رقم أقل.
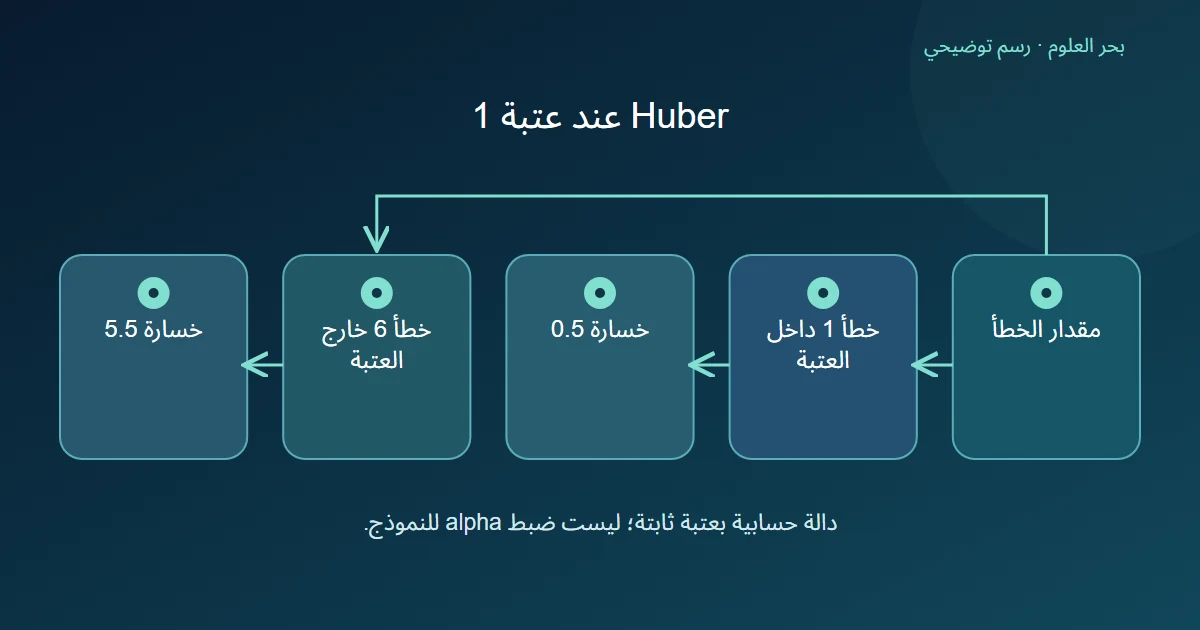
خسارة Huber بعتبة واضحة
تعرف SciPy دالة Huber بأنها نصف مربع الخطأ داخل delta، وdelta مضروبة في مقدار الخطأ ناقص نصف delta خارجها. [2]
اختر delta=1 للتوضيح. عند خطأ 1 تكون الخسارة 0.5×1²=0.5. وعند خطأ 6 تصبح 1×(6-0.5)=5.5. لو تضاعف الخطأ الكبير إلى 12، تصبح 11.5 وفق العتبة نفسها. هذا انتقال في شكل النمو، لا حذف لأثر الحالات الكبيرة.
أما واجهة التعزيز المذكورة فتستخدم alpha المرتبط بكمية خسارة Huber. لا نساوي هذا الخيار بعتبة delta الثابتة التي افترضناها للحساب. [1]
اختيار الخسارة يبدأ من المطلوب
اكتب سببًا واضحًا للمقارنة: هل تريد ألا تستحوذ فجوة كبيرة واحدة على الحساب، أم تريد معاقبة التأخر الكبير بقوة؟ ثم افحص أمثلة فعلية من النوع الذي يهمك. اسم «متينة» لا يغني عن تعريف تكلفة الخطأ بالنسبة إلى المهمة.
عند تجربة خسائر مختلفة، احتفظ بسجل الحالات الكبيرة ونتائجها، إضافة إلى المتوسط الإجمالي. إذا تحسن المتوسط وبقيت تلك الحالات سيئة، فهذا جزء من التقرير. ولا تستنتج وجوب حذفها من تغيير الخسارة وحده؛ إبقاؤها للمراجعة يساعدك على فهم ما تغير فعلًا.
المصادر ومتابعة القراءة
- scikit-learn: GradientBoostingRegressor loss and alpha (يفتح في نافذة جديدة)scikit-learn.org
- SciPy: scipy.special.huber (يفتح في نافذة جديدة)docs.scipy.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.