
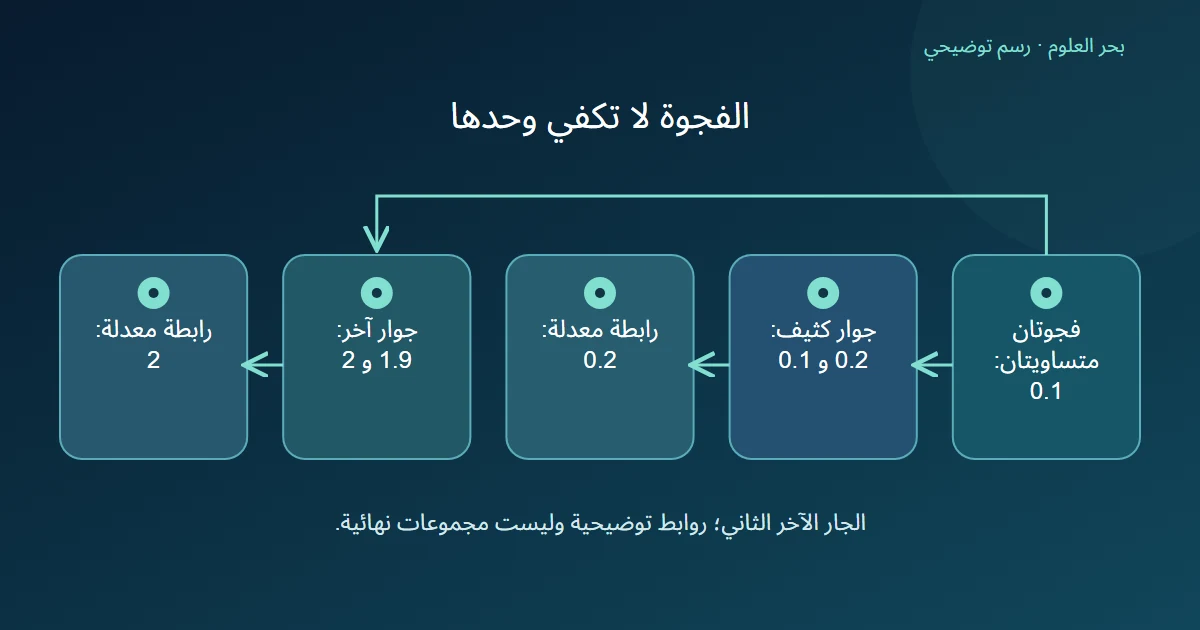
تبني HDBSCAN تسلسلًا للكثافة باستخدام مسافة الوصول المتبادل، ثم تكثف شجرة المجموعات وتستخرج مجموعات مستقرة وفق إعداداتها. [1]
الخلاصة السريعة
HDBSCAN لا تنظر إلى الفجوة بين نقطتين وحدها؛ المسافة المعدلة تتأثر بكثافة الجوار. هذه الرابطة خطوة في التحليل، وليست حكمًا نهائيًا على المجموعة.
- نقيس الجوار في المثال إلى الجار الآخر الثاني؛ والمسافة المعدلة أكبر قيم مسافتي الجوار والمسافة بين النقطتين. [1]
- باستعمال الجار الآخر الثاني في المثال، فجوة 0.1 تصبح رابطة 0.2 في الزوج الكثيف ورابطة 2 في الزوج الأبعد عن البقية.
- يتبع تعديل الروابط بناء التسلسل وتكثيفه؛ min_cluster_size يحدد حدًا لحجم المجموعة، ولا نستخرج تسميات من رابطتين فقط. [1] [2]
- يختلف عد الجيران بين تنفيذ scikit-learn ومكتبة hdbscan؛ الأول يشمل النقطة نفسها في min_samples. [2]
مسافة الجوار الأساسية قبل مقارنة الزوج
نفترض نقاطًا على خط عددي عند −0.1 و 0 و 0.1 و 2 و 2.1. نعرف في مثالنا مسافة الجوار الأساسية بأنها البعد إلى الجار الآخر الثاني، مع استبعاد النقطة نفسها من العد.
عند −0.1، الجاران الأقرب هما صفر و 0.1 بمسافتين 0.1 و 0.2، فالقيمة الأساسية 0.2. عند صفر، يقع الجاران على بعد 0.1، فالقيمة الأساسية 0.1.
عند 2، الجار الأقرب 2.1، والثاني 0.1 على بعد 1.9. وعند 2.1، الجار الثاني 0.1 على بعد اثنين. قرب النقطتين من بعضهما لا يمنحهما تلقائيًا جوارًا كثيفًا مماثلًا للثلاث الأولى.
الفجوة واحدة والروابط مختلفة
في الزوج −0.1 وصفر، الفجوة 0.1. نأخذ أكبر القيم 0.2 و 0.1 و 0.1؛ الرابطة المعدلة 0.2. في الزوج 2 و 2.1، نأخذ أكبر القيم 1.9 و 2 و 0.1؛ النتيجة اثنان.
إذن الزوجان لهما الفجوة العددية نفسها، لكن الرابطة الثانية أكبر بعشرة أمثال. نستطيع مراجعة السبب في قيم الجوار، بدل تفسير الفرق على أنه تعديل عشوائي لمسافة إحدى النقطتين.
هذه روابط حسبناها يدويًا وفق تعريف المثال. لم نشغل HDBSCAN، ولا يثبت الرقم اثنان أن النقطتين ستعدان ضوضاء. التسميات تتطلب بقية الروابط وخطوات الاستخراج، لا النظر إلى هذا الزوج وحده.
من الروابط إلى شجرة ثم مجموعات
تمر الطريقة الموصوفة ببناء شجرة وصل من الروابط المعدلة، ثم تسلسل للمجموعات، وتكثيف مرتبط بالحجم، واختيار الاستقرار. [1]
يحدد min_cluster_size أدنى حجم للمجموعات في الواجهة الموثقة. [2]
يمكن تخيل دفتر يحتفظ بما يبقى متصلًا عند مستويات مختلفة، ثم يختار من هذا الدفتر وفق قواعد محددة. هذا تشبيه لتنظيم الخطوات، لا قائمة التسميات النهائية لنقاطنا. ولم نحسب شجرة كاملة أو درجات استقرار.
إذا سألك القارئ أين تقع المجموعة، أشر إلى خطوة الاستخراج والإعدادات التي ما زالت ناقصة. لا تجعل غياب نصف قطر واحد ثابت معناه غياب اختيارات تؤثر في النتيجة.
أي جار يحتسبه التنفيذ؟
يشمل min_samples في scikit-learn النقطة نفسها، بينما لا يشملها تنفيذ hdbscan المقارن في الوثائق؛ القيم المتكافئة تختلف بواحد. [2]
لتمثيل جارنا الآخر الثاني، نحتاج إلى عد ثلاثة مع تضمين النقطة نفسها، أو اثنين عند استبعادها. إدخال الرقم اثنين في البرنامجين دون قراءة هذه القاعدة لا يحفظ تعريف المسافة الذي حسبناه.
سجل اسم المكتبة ومقياس المسافة وطريقة العد إلى جانب المثال. بذلك تفسر اختلاف رابطة محسوبة بدل نسبته إلى البيانات فورًا، وتحافظ على الفرق بين إعداد يؤثر في الجوار وآخر يحدد حجم المجموعة المختارة.
المصادر ومتابعة القراءة
- HDBSCAN documentation: How HDBSCAN works (يفتح في نافذة جديدة)hdbscan.readthedocs.io
- scikit-learn: HDBSCAN (يفتح في نافذة جديدة)scikit-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.