
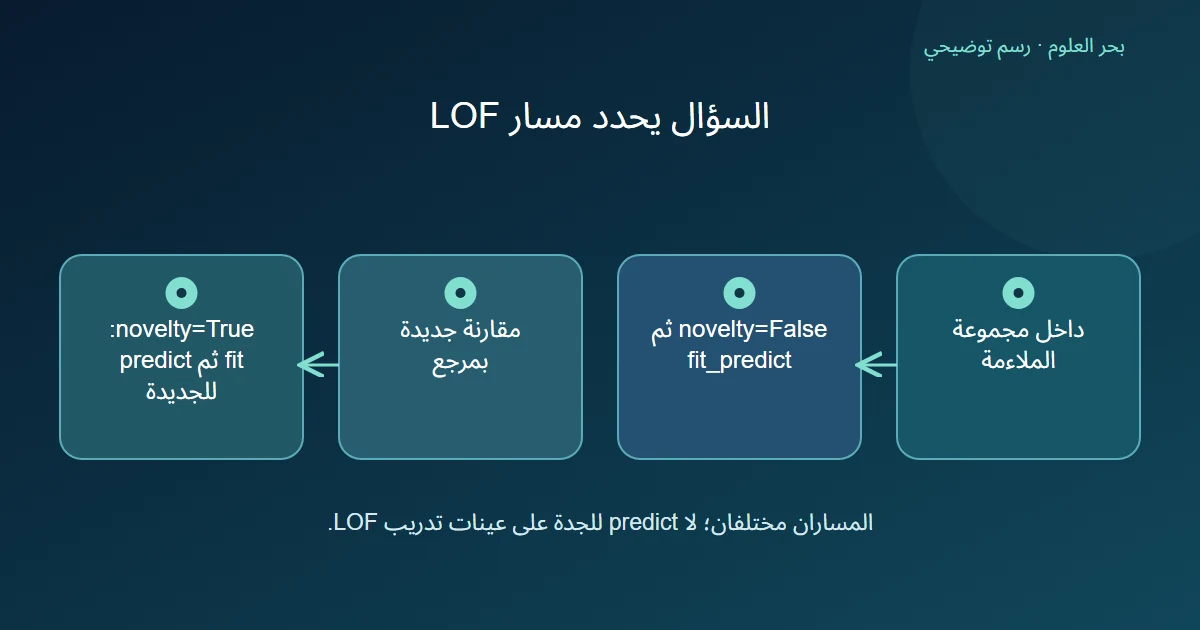
يفصل دليل scikit-learn بين كشف الشذوذ في تدريب قد يحوي حالات شاذة، وكشف الجدة بمقارنة بيانات جديدة بمرجع يفترض خلوه منها. [1]
الخلاصة السريعة
حدد أولًا هل تبحث داخل بيانات الملاءمة أم تقارن ملاحظات جديدة بمرجع؛ في LOF يحدد هذا السؤال الإعداد والطريقة الصحيحة.
- كشف الشذوذ ينظر إلى مجموعة التدريب التي قد تكون ملوثة؛ كشف الجدة ينطلق من مرجع يفترض خلوه من الحالات الشاذة. [1]
- في الوضع الافتراضي novelty=False، يستخدم LOF المسار fit_predict لاكتشاف الحالات داخل مجموعة الملاءمة. [2]
- مع novelty=True، يلائم LOF المرجع ثم يستعمل predict أو decision_function لبيانات جديدة، ولا يتيح fit_predict. [2]
- لا تطبق تنبؤ الجدة على عينات تدريب LOF؛ وقد تكون الحالات الجديدة متقاربة بعضها من بعض مع بقائها خارج وصف المرجع. [1] [2]
سؤالان يبدوان متشابهين
نسجل أزمنة افتراضية لعملية ثابتة. قد يكون سؤالنا الأول: هل تتضمن هذه السجلات حالات تختلف عن محيطها؟ وقد يكون الثاني: هل تختلف سجلات لاحقة عن المرجع الذي اخترناه؟ الفارق هو دور المجموعة في السؤال.
يسمي الدليل الأول كشف الشذوذ، حيث قد يحوي التدريب حالات شاذة. وفي كشف الجدة يفترض المرجع غير ملوث، ثم يفحص أمثلة لم تشاهد في الملاءمة. [1]
تسمية ملف «مرجع» لا تثبت أنه مناسب. في قصتنا نحتاج إلى وصف ظروف تسجيل الأزمنة، حتى نعرف ما الذي نقارنه لاحقًا. إذا خلطنا تشغيلين مختلفين بلا تصريح، غيّرنا المرجع قبل حساب أي درجة.
حين تكون الحالات داخل المجموعة
في الوضع الافتراضي novelty=False، يتيح LOF استعمال fit_predict على مجموعة الملاءمة. [2] لذلك يستطيع الكاتب توضيح المسار بعبارة: نلائم المجموعة المختلطة، ثم نقرأ إسنادات عيناتها.
نفترض أن مجموعة السجلات الأولى تحتوي قراءات نريد مراجعتها داخل تلك المجموعة نفسها. لا نستخدم اسم «جديدة» لكل قراءة لأنها وصلت اليوم؛ الجديدة هنا بالنسبة إلى الملاءمة، وليس بالنسبة إلى تاريخ إدخال الملف.
لم ننفذ هذا المسار، فلا نعطي قائمة نتائج مفترضة على أنها مخرجاته. يكفي توثيق أي عينات دخلت fit_predict وما السؤال الذي يجيب عنه؛ اختيار الاسم الصحيح يمنع نقل أحكامها إلى مجموعة أخرى دون حساب.
حين نقارن بيانات لاحقة بالمرجع
إذا اخترنا novelty=True، يلائم LOF المرجع ثم يتيح predict ودالة القرار للأمثلة الجديدة، ولا يتيح fit_predict في هذا الوضع. [2]
نضع في المرجع قيمًا توضيحية 0 و 0.1 و 0.2 و 0.3، ثم تظهر لاحقًا قيم 10 و 10.1 و 10.2. المجموعة اللاحقة متقاربة داخليًا، لكنها بعيدة عن مجال القيم المرجعية في هذه القصة.
هذا مثال على اختلاف التقارب الداخلي عن التشابه مع المرجع، وليس حسابًا لدرجات LOF أو تنبؤاته. لم نثبت عدد الجيران أو ننفذ نموذجًا. لذلك لا نزعم أن المكتبة أخرجت إسنادًا بعينه لتلك الأرقام.
لماذا لا نختبر المرجع بالطريقة نفسها؟
تحذر الوثائق من استعمال تنبؤ الجدة أو دالة قراره على عينات التدريب؛ النتائج تختلف عن مسار كشف الشذوذ الافتراضي. [1] [2]
في القصة، إعطاء القيم المرجعية الأربع مرة أخرى إلى predict بعد ملاءمة وضع الجدة ليس بديلًا عن fit_predict في الوضع الافتراضي. نحتاج إلى الفصل بين الطريقتين في سجل العمل، حتى لو حملتا اسم الخوارزمية نفسه.
اكتب سؤال المهمة، ومصدر المرجع، وقيمة novelty، وأسماء العينات التي دخلت الملاءمة والتي دخلت التنبؤ. وإذا تقاربت مجموعة جديدة، فلا يكفي هذا وحده لنفي الجدة؛ المقارنة المطلوبة مع المرجع، وتفسير سبب الاختلاف يحتاج إلى سياق مستقل.
المصادر ومتابعة القراءة
- scikit-learn: novelty and outlier detection (يفتح في نافذة جديدة)scikit-learn.org
- scikit-learn: LocalOutlierFactor (يفتح في نافذة جديدة)scikit-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.