
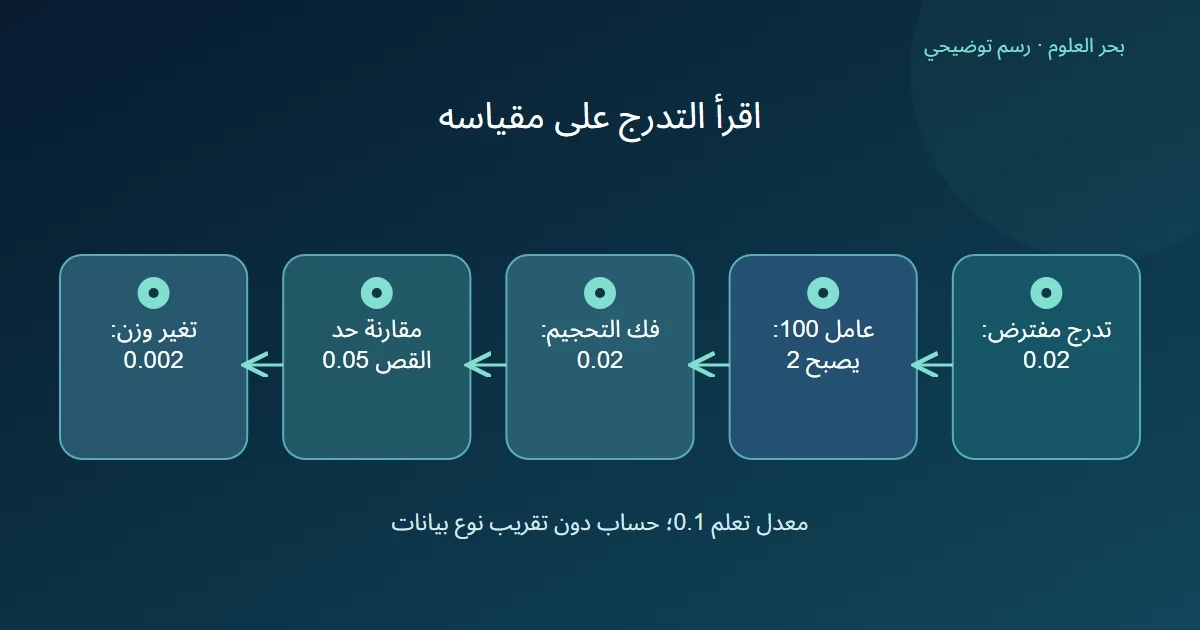
تحجيم الخسارة وفك تحجيم التدرج مرحلتان لا نستبدل إحداهما بالأخرى. توضح أمثلة PyTorch أن backward بعد تحجيم الخسارة ينتج تدرجات محجمة، وأن فحصها أو قصها يحتاج إلى فك التحجيم أولًا. [1]
الخلاصة السريعة
اعرف هل التدرج الذي تقرأه محجم أم مفكوك التحجيم؛ مقارنة حد قص أو تنفيذ تحديث على المقياس الخطأ تغير الحساب الذي قصدته.
- تدرجات scaler.scale(loss).backward() محجمة؛ المثال الموثق يفكها قبل قصها حتى يبقى حد القص على المقياس المقصود. [1]
- في حساب يدوي على الأعداد الحقيقية، دون تقريب نوع بيانات، تدرج 0.02 وعامل موجب ثابت 100 يعطيان 2؛ بعد القسمة على 100، معدل تعلم 0.1 يعطي تغيرًا 0.002 لا 0.2.
- مع حد قص مفترض 0.05 على التدرج الأصلي، يبقى 0.02 كما هو؛ قص العدد المحجم 2 إلى 0.05 ثم قسمته على 100 يعطي 0.0005، وهو حساب مختلف.
- توثق PyTorch فك التحجيم مرة واحدة لكل محسن بين الخطوات وبعد اكتمال تراكم تدرجاته؛ scaler.step(optimizer) تتجاوز تحديث المحسن عند وجود inf أو NaN. [1]
ميز المقياس قبل قراءة المقدار
توضح الأمثلة أن GradScaler يحجم الخسارة والتدرجات، وأن autocast يختار دقة عمليات مناطق محددة؛ الوظيفتان منفصلتان. [1]
نختار عاملًا موجبًا ثابتًا 100 في تمرين حسابي فقط، لا قيمة افتراضية وعدنا أن أداة ستستعملها. إذا ضربنا خسارة دالة في ثابت، تضرب مشتقتها بالثابت نفسه. لذلك لا نسمي التدرج الجديد دليلًا على خطأ أكبر في البيانات أو هدف مختلف اخترناه.
نفصل هنا حساب الأعداد الحقيقية من تمثيلها في الحاسوب. لم نحوّل قيمة إلى float16 أو نقس خسارة عددية أو زمنًا. الأرقام تختبر معنى المقياس، لا حدًا للتمثيل أو ضمانًا بأن تدريبًا معينًا صار أدق.
التحديث يحتاج إلى المقدار المقصود
نفترض تدرجًا أصليًا 0.02، فتحجيمه بعامل 100 يعطي 2. نريد تحديثًا بسيطًا يطرح معدل التعلم مضروبًا في التدرج من الوزن، ونختار المعدل 0.1، دون زخم أو اضمحلال وزن.
بعد فك التحجيم يعود التدرج 0.02؛ التغير المقصود 0.1 × 0.02 = 0.002. إذا استعملنا العدد 2 في التحديث نفسه، يصبح التغير 0.2، أي أكبر مئة مرة. عامل التحجيم لا يمنحنا إذنًا ضمنيًا بتغيير معدل التعلم.
لم نستخرج هذا التدرج من نموذج؛ فرضناه ليظهر خطأ الوحدات الحسابية. ولا نتوقع خسارة الخطوة المقبلة أو جودة الناتج من مقارنة التغيرين وحدها.
ترتيب القص والقسمة يغير النتيجة
نحدد حدًا افتراضيًا 0.05 لمقدار تدرج واحد على المقياس الأصلي. العدد 0.02 أصغر منه، فلا يحتاج إلى تقليص. أما 2 في المقياس المحجم فيبدو أكبر من الحد، مع أنه يمثل التدرج نفسه قبل فك التحجيم.
إذا قصصنا 2 إلى 0.05 ثم قسمنا على 100، أصبح المقدار 0.0005. هذا أصغر أربعين مرة من 0.02. تغيرت قاعدة القص لأننا قارنا مقادير بمقياسين مختلفين، لا لأن التدرج الأصلي تجاوز الحد.
لذلك نكتب في بطاقة الإعداد هل الحد يخص القيم المفكوكة. الجدول مقارنة يدوية لترتيبين، وليس تشغيلًا لأداة قص أو برهانًا أن حد 0.05 مناسب لأي شبكة.
| الترتيب في المثال | المقدار بعد الإجراء |
|---|---|
| فك التحجيم ثم المقارنة بالحد | 0.02 |
| قص 2 إلى 0.05 ثم القسمة على 100 | 0.0005 |
حدود الخطوة جزء من استعمال الأداة
يبين التوثيق أن scaler.step يفك التحجيم عند الحاجة ثم ينفذ خطوة المحسن إذا خلت التدرجات من inf وNaN، ويتجاوزها خلاف ذلك؛ unscale_ مرة واحدة لكل محسن قبل خطوته وبعد اكتمال تراكم تدرجاته. [1]
لا نضيف دفعة ذات تدرج محجم إلى أخرى فككنا تحجيمها ضمن الجمع نفسه. نحتفظ بخطة واضحة لنهاية التراكم والفحص والتحديث. تغيير عامل أثناء جمع المقادير يستلزم معرفة المقياس الفعلي لكل مساهمة، بدل جمع أرقام تبدو متشابهة.
لم ننفذ دورة دقة مختلطة أو نرصد قيمة غير منتهية. راجع ترتيب الأداة وإعدادها في مشروعك، ثم تحقق من نتيجة فعلية؛ مقالنا يوضح خطأ المقياس وترتيب الإجراءات فقط.
المصادر ومتابعة القراءة
- PyTorch 2.8: Automatic Mixed Precision examples (يفتح في نافذة جديدة)raw.githubusercontent.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.