
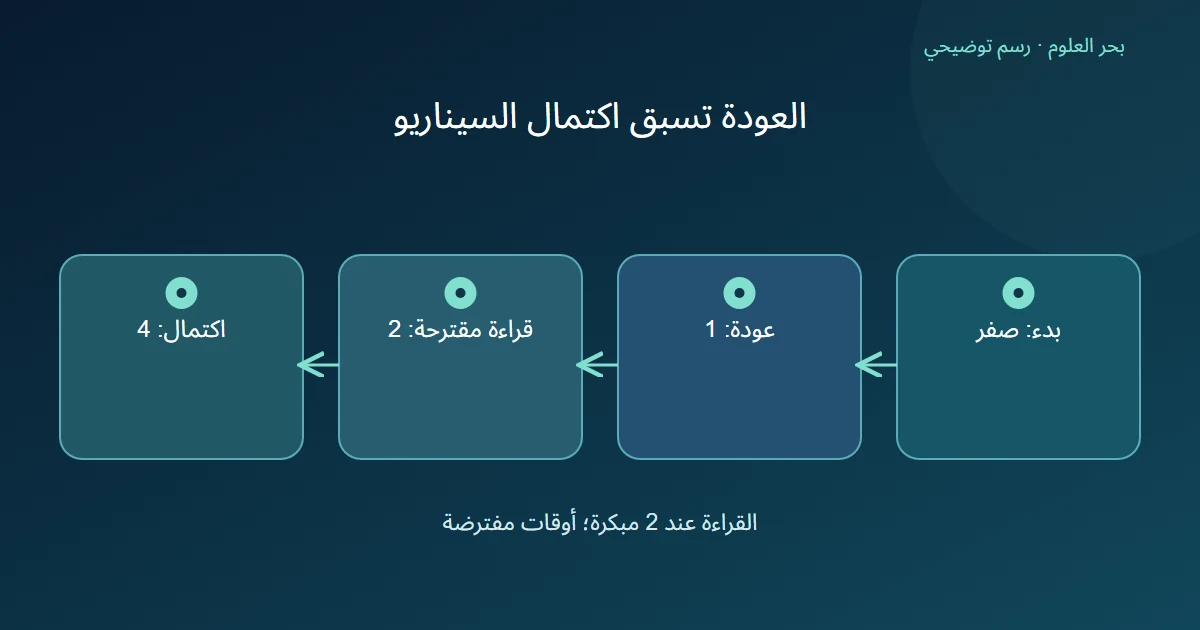
عودة النسخ غير الحاجب وجاهزية البيانات حدثان يجب فصلهما. يبين دليل PyTorch أن النقل غير الحاجب من CUDA إلى CPU يحتاج إلى تزامن قبل استعمال البيانات. [1] نوضح ذلك بأوقات مؤلفة، لا بقياس جهاز.
الخلاصة السريعة
لا تجعل عودة الاستدعاء وحدها دليلا على جاهزية الوجهة؛ في نقل CUDA إلى CPU غير الحاجب، يلزم التأكد من اكتمال العمل قبل قراءتها.
- يعرض الدليل نقل CUDA إلى CPU مع non_blocking=True، ثم التزامن قبل القراءة الموثوقة. [1] لا نعمم الحكم على كل اتجاه أو نوع ذاكرة.
- في خطنا المفترض بدأ النقل عند صفر وعاد الاستدعاء عند 1 واكتمل النسخ عند 4؛ العودة تسبق الاكتمال بثلاث وحدات زمن.
- قراءة الوجهة عند 2 تقع قبل اكتمال النسخ المعلن؛ لا نعتمد قيمها جوابا كاملا. الانتظار حتى اكتمال العمل المعني يختلف عن نوم اعتباطي ثابت.
- احفظ اتجاه النقل وحدوده ودليل اكتماله، وافصل جاهزية النسخة عن صحة التنبؤ نفسه؛ أوقاتنا ليست نتيجة GPU أو إثبات تسريع.
أي اتجاه نقل نناقشه؟
يعرض دليل PyTorch أن النقل غير الحاجب من CUDA إلى CPU لا يعطي قراءة موثوقة دون التزامن قبل الوصول إلى البيانات. [1]
نثبت هذا الاتجاه في السؤال. لا نجمع كل انتقال بين الذاكرات في حكم واحد، ولا نفترض أن خيار non_blocking يضمن تداخلا أو سرعة محددة في كل جهاز. معنى عودة استدعاء على جانب المضيف لا يكفي وحده لتحديد متى اكتملت البيانات المطلوبة.
في بطاقة المراجعة نفرق حدث تقديم العمل وحدث عودة الاستدعاء وحدث اكتمال النسخ. قد تكون الحدود قريبة أو بعيدة؛ ما يهم القراءة التالية معرفة الحد المناسب، لا اختيار الكلمة التي تبدو أكثر تفاؤلا.
ثلاثة حدود على خط واحد
نعلن خطا زمنيا مؤلفا بوحدة حسابية، لا بالثواني أو الميكروثواني. يبدأ النقل عند صفر، ويعود الاستدعاء إلى صاحبه عند 1، ويكتمل النسخ الذي نناقشه عند 4. جميع الأوقات على المرجع نفسه.
زمن البدء إلى العودة هو وحدة واحدة، بينما زمن البدء إلى الاكتمال أربع وحدات. بقي بعد العودة 4 − 1 = 3 وحدات في السيناريو. لا نستبدل الأربع بالواحدة عندما نسأل عن جاهزية البيانات؛ الحدثان مختلفان في فرضنا.
ولا نستخرج من الخط معدل نقل أو حجم بيانات. لم نعط عدد بايتات أو سرعة جهاز أو سجل تنفيذ. اختيار الأرقام يفصل الأحداث فقط، ولا يثبت أنه خط PyTorch المعتاد أو أسوأ زمن له.
متى تقع قراءة غير مكتملة؟
نضيف طلب قراءة الوجهة عند الوقت 2. نعرف من عقدنا أنه قبل 4، فلا نقرر أن البيانات المقروءة عنده نسخة كاملة. لا نخترع الأرقام التي ستظهر؛ لم نحدد كيف توزعت الكتابات بين عناصر الوجهة.
ونضيف فرعا ينتظر اكتمال النقل المعني ثم يقرأ. هذا يحفظ ترتيب «اكتمال قبل قراءة» في الورقة. لا نساوي الانتظار بمضي مدة ثابتة اختيرت مسبقا؛ لو تغير زمن النسخ إلى 6، لم تعد قراءة عند 4 بعد الاكتمال.
حتى عند اكتمال نسخة نراجع صحة استعمالها للمهمة على نحو مستقل. وصول الأرقام كاملة لا يخبر هل المدخل مناسب أو هل جواب نموذج صحيح. درسنا عن جاهزية حمولة نقل، لا عن تقييم التنبؤ.
ما الذي يجب أن يبينه سجل التنفيذ؟
نقترح تسجيل المصدر والوجهة وخيار النقل ودليل اكتمال العمل قبل القراءة. إذا عرض سجل عودة الاستدعاء فقط، نترك وقت اكتمال النسخ مجهولا؛ لا نملأه بوقت العودة لمجرد أنه الرقم الوحيد.
كذلك لا يعني الانتظار على عمل آخر إثبات اكتمال هذا النقل. نربط دليل الاكتمال بالعمل الذي ستستعمل بياناته، ونسجل ما إذا كانت مادة المراجعة تكفي لتحديد تلك العلاقة. لا نقدم هنا وصفة تزامن عامة لجميع الأجهزة والمسارات.
الرسم يضع القراءة عند 2 بين العودة عند 1 والاكتمال عند 4. لم ننقل تنسورا أو نشغل CUDA. فائدته أن يمنع اعتبار «غير حاجب» وعدا ببيانات جاهزة، وأن يفصل توقيت العودة من شرط الاستخدام التالي.
المصادر ومتابعة القراءة
- PyTorch: A guide on good usage of non_blocking and pin_memory() (يفتح في نافذة جديدة)docs.pytorch.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.