
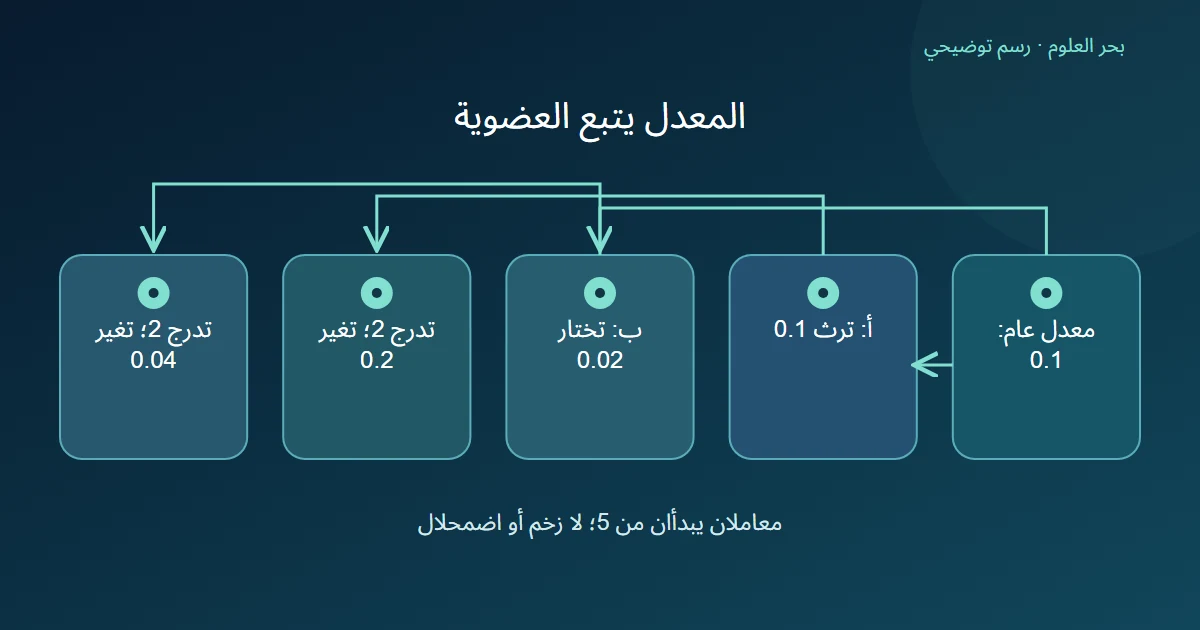
مجموعات المعاملات ومعدل التعلم تحتاج إلى قائمة عضوية واضحة: ما المعامل الذي ينتمي إلى كل مجموعة، وأي إعداد تجاوز القيمة العامة؟ ليست تسمية «قاعدة» و«رأس» كافية لتحديد الأرقام التي يقرأها المحسن في خطوته.
الخلاصة السريعة
اقرأ عضوية كل مجموعة ومعدلها الفعلي، ثم احسب أثر التدرج والإعدادات؛ نسبة معدلي التعلم ليست ضمانًا لنسبة حركة المعاملات أو سرعة تحسنها.
- تقبل محسنات PyTorch مجموعات يحدد params عضويتها، وتخصها خيارات مثل lr؛ القيم العامة افتراضات للمجموعات التي لا تتجاوزها. [1]
- في تمرين SGD بلا زخم أو اضمحلال، معاملان يبدأان من 5 وتدرجا كل منهما 2؛ المعدل 0.1 يعطي 4.8، والمعدل الخاص 0.02 يعطي 4.96.
- إذا صار التدرج الثاني 10 مع بقاء معدله 0.02، يصبح تغيره 0.2 مثل الأول؛ المعدل الأصغر خمس مرات لا يثبت خطوة أصغر دائمًا.
- راجع العضوية الفعلية والخيارات الموروثة والهدف؛ نقل معامل إلى مجموعة أخرى يغير الإعداد الذي نطبقه، لكنه لا يثبت تحسن المهمة أو تساوي سلوك المحسنات.
العضوية والإعداد الموروث معلومتان
يوثق torch.optim مجموعات من قواميس، يحدد params معاملات المجموعة، وتعين المفاتيح الأخرى خياراتها؛ الخيارات العامة تبقى افتراضات لما لم تتجاوزه المجموعة. [1]
نتخيل مجموعتين نسميهما «أ» و«ب». نضبط المعدل العام 0.1، ولا نضع معدلًا محليًا للمجموعة أ، بينما نحدد 0.02 للمجموعة ب. بهذه الخطة يصبح المعدل الفعلي لأ 0.1 ولب 0.02؛ لم نترك القيمة الناقصة لغزًا.
هذا وصف للعضوية والخيارات، لا ادعاء أن الاسم أ يعني طبقة أولى أو أن ب تضم مخرجات النموذج بالضرورة. عندما يضم مشروع طبقات عديدة، نطلب أسماء المعاملات الفعلية بدل تخمينها من اسم المجموعة.
نفس التدرج يبرز اختلاف المعدلين
نختار خطوة SGD للتقليل بلا زخم أو اضمحلال وزن؛ صيغتها طرح المعدل مضروبًا في التدرج من المعامل. [2]
في مثالنا اليدوي، قيمتا المعاملين 5، وتدرج كل منهما 2. للمجموعة أ نطرح 0.1 × 2 = 0.2، فتصير القيمة 4.8. للمجموعة ب نطرح 0.02 × 2 = 0.04، فتصير 4.96.
إذا وضعنا المعامل الأول في ب والثاني في أ، تنعكس القيم تحت الشروط نفسها. لم يتغير اسم التدرج أو تعريف الخطوة؛ تغير ارتباط المعامل بالمعدل. لم نكتب برنامج مجموعات أو ننفذ تدريبًا.
| المجموعة | المعدل الفعلي | التدرج المفترض | القيمة التالية |
|---|---|---|---|
| أ؛ معدل عام | 0.1 | 2 | 4.8 |
| ب؛ تجاوز محلي | 0.02 | 2 | 4.96 |
هل المعدل الأصغر يعني حركة أصغر دائمًا؟
نبقي المثال الأول كما هو، ثم نجعل تدرج المعامل الثاني 10 بدل 2. يبقى معدل ب 0.02، فيصبح التغير 0.02 × 10 = 0.2. صار مقدار الحركة مساويًا لحركة أ، رغم اختلاف المعدلين بنسبة خمسة إلى واحد.
النسبة بين المعدلات كانت عاملًا في الحساب؛ لم تكن النتيجة كاملة. لو غيرنا الزخم أو الاضمحلال أو اخترنا محسنًا آخر، لاحتجنا إلى قراءة القاعدة الجديدة قبل استنتاج مقدار الحركة.
كذلك لا نساوي مقدار الحركة بسرعة التعلم أو جودة المخرج. لا يحتوي تمريننا على بيانات أو خسارة بعد التحديث، لذلك لا يحدد المجموعة الأفضل أو المعدل الأنسب لمهمة فعلية.
راجع قائمة المعاملات قبل تفسير السجل
نقترح جدول مراجعة فيه اسم كل معامل ومجموعته ومعدلها الفعلي والتدرج الذي قرئ والإعدادات الأخرى. إذا كان الاسم موجودًا في المجموعة الخاطئة، فلن يصحح رقم معدل معلن في عنوان التجربة هذا الاختلاف.
وعند مراجعة سجل، لا ننسب المعدل العام تلقائيًا إلى مجموعة تجاوزته. اكتب أيضًا وقت تغيير الخيارات إذا كانت هناك خطة تتغير أثناء التدريب؛ جدولنا يخص خطوة ذات معدلات ثابتة فقط.
لم نقارن مهام أو نقس زمنًا أو نعدل محسنًا حيًا. القراءة الدقيقة للمجموعات تمنع خلط إعداد اختير لمعامل بقرار يخص كل النموذج، وتحدد الحساب الذي يستحق تحققًا مستقلًا في مشروع القارئ.
المصادر ومتابعة القراءة
- PyTorch 2.14: torch.optim per-parameter options (يفتح في نافذة جديدة)docs.pytorch.org
- PyTorch 2.8: plain SGD scalar update (يفتح في نافذة جديدة)raw.githubusercontent.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.