
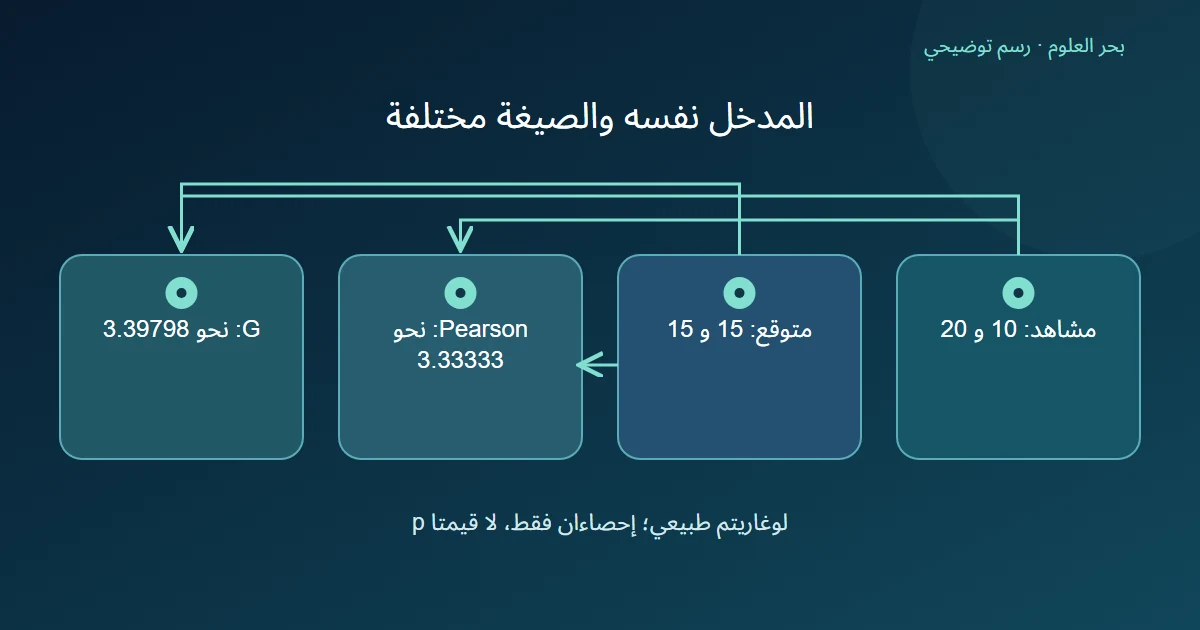
اختيار الإحصاء في power_divergence يحدد كيف يلخص مساعد تحليل البيانات الفرق بين أعداد مشاهدة ومتوقعة. بقاء الجدول نفسه لا يضمن بقاء الرقم إذا تغيرت العائلة الحسابية. نثبت فئتين ومتوقعًا معلنًا، ونحسب Pearson ونسبة الاحتمالية يدويًا؛ المقارنة تخص الإحصاء، لا اختيار النتيجة التي نريدها.
الخلاصة السريعة
تتيح power_divergence الاختيار pearson بمعامل 1 وlog-likelihood بمعامل 0. [1] اختلاف الصيغ قد يغير الإحصاء على الأعداد نفسها.
- اختيار pearson هو إحصاء كاي تربيع Pearson، وlog-likelihood هو G-test. [1] نثبت المشاهد والمتوقع قبل مقارنة الاختيارين.
- بصيغة مجموع مربعات الفروق مقسومة على المتوقع، [2] أعدادنا 10 و 20 أمام 15 و 15 تعطي 10/3 ، نحو 3.33333.
- صيغة G تجمع ضعفي العدد المشاهد في اللوغاريتم الطبيعي لنسبته إلى المتوقع. [2] في المثال نفسه تعطي نحو 3.39798 ؛ حد منفرد سالب لا يجعل المجموع سالبًا.
- تحتاج صلاحية الاختبار توافق المجموعين وتكرارات مناسبة. [1] مجموع ورقتنا 30 في الجانبين؛ اختلاف الرقم لا يثبت أفضلية اختبار أو تغير البيانات، ولم نحسب قيمة p.
ما الخيار الذي ننسب إليه الرقم؟
يوثق power_divergence اسمي pearson بمعامل 1 وlog-likelihood بمعامل 0 ، والأخير يعرف أيضًا باسم G-test. [1]
نقصد عددًا يلخص اختلاف أعداد فئتين عن توقع معلن. نؤلف ثلاثين بطاقة علامات: عشر من نوع دائرة وعشرين من نوع مثلث. المتوقع الذي اخترناه للورقة خمسة عشر لكل نوع؛ مجموعا المشاهد والمتوقع متساويان.
لا نشتق المتوقع من قرار النموذج أو نغيره بين الحسابين. وإذا وصل جدول آخر بمتوقع مختلف، لا ننسب كل اختلاف الإحصاء إلى اسم الخيار قبل مراجعة المدخلين. الذي سنعزله هنا هو الصيغة وحدها.
كيف نحسب Pearson على القائمة؟
صيغة Pearson في التنفيذ تجمع مربع المشاهد ناقص المتوقع مقسومًا على المتوقع. [2]
الفروق في قائمتنا سالب خمسة وموجب خمسة. تربيعهما يعطي خمسة وعشرين في كل فئة؛ نقسم كل حد على خمسة عشر ثم نجمع. يصبح العدد خمسين÷خمسة عشر، أي 10/3 ونحو 3.33333.
لم نجمع الفروق الموقعة مباشرة، لأن جمع سالب خمسة وموجب خمسة يساوي صفرًا ويخفي الاختلاف بين الفئتين. كذلك لا نقسم الحدين على المشاهد عشرة وعشرين؛ المقام هنا العدد المتوقع الذي ثبّته السؤال. هذه حسابات أصلية، وليست مخرجات دالة شغلناها.
ماذا يغير اللوغاريتم في G؟
عند المعامل صفر تجمع الشيفرة ضعفي المشاهد مضروبًا في اللوغاريتم الطبيعي لنسبة المشاهد إلى المتوقع. [2]
نحسب الحد الأول 2 × 10 × ln(10/15)، نحو سالب 8.10930. والثاني 2 × 20 × ln(20/15)، نحو 11.50728. مجموعهما نحو 3.39798 ، مع الأعداد واللوغاريتم الطبيعي اللذين أعلنّاهما.
الحد الأول سالب لأن نسبته أقل من واحد. لا نستبدل إشارته بالموجب قبل الجمع؛ ذلك سينشئ رقمًا ثالثًا لا يمثل صيغة الورقة. كما لا نحول العدد 3.39798 إلى احتمال 339.798 ٪ أو عدد بطاقات خاطئة؛ دور الرقم إحصاء مقارنة تحت تعريفه.
ما الذي يبقى خارج المقارنة الحسابية؟
تنبه الوثائق إلى توافق مجموعي المشاهد والمتوقع وإلى عدم ملاءمة الاختبار عند تكرارات صغيرة جدًا. [1]
أعدادنا موجبة ومجموعها ثلاثون في كل جانب، لكننا لم نصمم أخذ عينة أو نراجع افتراضات بيانات فعلية، ولم نستخرج قيمة p أو نحدد قاعدة حكم. ورقة إحصاء لا تعني أن اختبارًا استدلاليًا اكتمل.
نقترح حفظ الفئات والمشاهد والمتوقع والخيار والإصدار مع أي نتيجة فعلية. لا ننتقي اسم الإحصاء لأن رقمه يلائم رسالة التقرير، ولا ننسب اختلاف الصيغ إلى تحسن نموذج ذكاء اصطناعي. الحسابان يثبتان أمرًا محددًا: البيانات ذاتها يمكن أن تحمل ملخصين عدديين مختلفين إذا تغير تعريف الملخص.
المصادر ومتابعة القراءة
- SciPy: power_divergence (يفتح في نافذة جديدة)docs.scipy.org
- SciPy v1.18.0 power divergence formulas (يفتح في نافذة جديدة)raw.githubusercontent.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.