
محاكاة التكميم وتحويل نموذج التدريب مرحلتان ينبغي تمييزهما. تصف TensorFlow التدريب مع مراعاة التكميم بأنه يحاكي التكميم وقت الاستدلال، ثم تستخدم أدوات لاحقة نموذجه لإنتاج نماذج مكممة فعليًا. [1]
الخلاصة السريعة
وجود محاكاة عددية في نموذج التدريب لا يثبت أن ملفه هو النموذج المكمم النهائي؛ راجع مرحلة التحويل وخصائص الناتج مستقلة.
- يحاكي المسار الموثق أثر التكميم في الاستدلال أثناء الإعداد للتدريب، ثم توجد مرحلة لاحقة لإنتاج النموذج المكمم فعليًا. [1]
- في تمرين معلن، وزن أصلي 0.62 يصبح 0.5 في محاكاة تقريب إلى أرباع؛ مع المدخل 4 يتغير الناتج من 2.48 إلى 2، دون إثبات نوع التخزين.
- يصرح دليل TensorFlow بأن النموذج الواعي بالتكميم ليس مكممًا فعليًا وأن إنشائه المكمم خطوة منفصلة. [2] سجل تدريب أو محاكاة لا يقوم مقام ناتج التحويل.
- قارن الإعداد والأثر الناتج ومهمة الاستخدام؛ المحاكاة وحدها لا تضمن الدقة أو دعم الجهاز، وحسابنا ليس تدريبًا أو تنفيذ تحويل.
ما وظيفة المحاكاة في هذا السؤال؟
يحاكي التدريب مع مراعاة التكميم في TensorFlow التكميم وقت الاستدلال، وينتج نموذجًا تستعمله أدوات لاحقة لإنشاء نماذج مكممة فعليًا. [1]
نستخدم كلمة «محاكاة» للدلالة على أن الحساب يأخذ أثر التمثيل المقصود في الاعتبار، ونفصلها عن وجود أثر نهائي جهزته أداة تحويل. لا نستخرج عدد البتات المخزن في ملف من تغير ناتج حساب فقط.
المقال لا يشرح طريقة حساب التدرج عبر التقريب أو يقدم قاعدة موحدة لكل مكتبات التدريب. نضيق السؤال إلى مرحلة الحساب ومرحلة إنشاء النموذج الذي سيستعمل لاحقًا. تسمية المرحلتين تمنع وصف ملف تدريب مجهول كما لو عرفنا مواصفات نشره.
افحص قيمة الحساب دون افتراض التخزين
نؤلف عملية خطية ذات وزن وحيد 0.62 ومدخل 4، دون ثابت مضاف. الحساب الأصلي يعطي 0.62 × 4 = 2.48. ونعلن محاكاة تعليمية تقرب الوزن إلى أقرب مضاعف لربع، فيصير 0.5 ويعطي 0.5 × 4 = 2.
قاعدة الأرباع من اختيارنا للشرح، وليست خرج TensorFlow أو إعدادًا افتراضيًا لها. كتبنا الوزن الأصلي والقيمة المستعملة في المحاكاة في حقلين مختلفين. ولم نحدد طريقة حفظ الحقلين أو نوعهما في جهاز.
تغير العدد في الحساب لا يثبت أننا خزنا الوزن برمز صحيح، ولا يقول هل حفظ ملف لاحق الوزن الأصلي أو القيمة المقربة أو معلومات إضافية. تلك أسئلة تحتاج قراءة الأثر الفعلي بدل استنتاجها من الرقم 2.
أي أثر يخص كل مرحلة؟
يوضح الدليل الشامل أن النموذج الواعي بالتكميم ليس مكممًا فعليًا؛ إنشاء النموذج المكمم خطوة منفصلة. ويعرض مثالًا لتحويل النموذج إلى TFLite. [2]
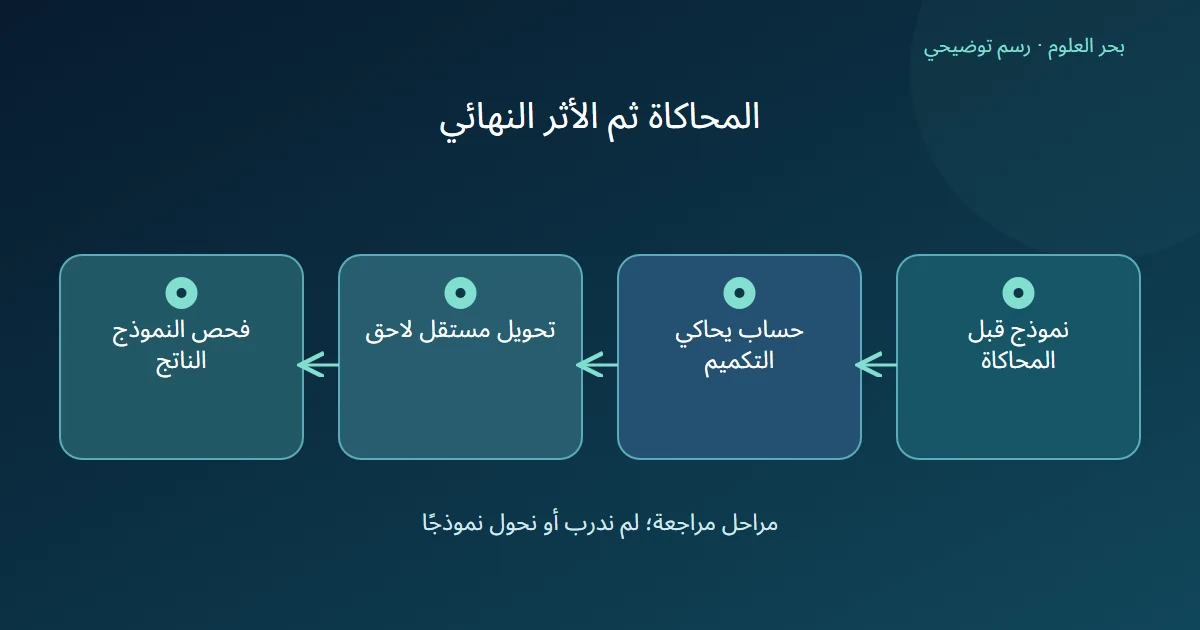
في سجل مؤلف نضع ثلاث خانات: وصف النموذج قبل المحاكاة، ووصف الحساب المعد للتدريب مع المحاكاة، وأثر التحويل المطلوب للاستخدام. إذا احتوت الخانتان الأوليان على معلومات والثالثة فارغة، لا نملأها بكلمة «تم» لأن الأولى تحمل اسم تكميم.
وحتى لو أعلن صاحب السجل تنفيذ التحويل، نسأل عن الناتج الذي حفظه ونسخة الإعداد التي أنتجته. لا يعني تشابه أسماء الملفات أن محتواها أو وظيفتها متطابقان. هذه خطة مراجعة للمراحل، لا تقرير تحويل قمنا به.
ما الذي تقارنه بعد الحصول على الناتج؟
نقترح مراجعة نوع البيانات والعمليات المدعومة وشروط الاستخدام في الأثر الفعلي، ثم تقييمه على المهمة المطلوبة. ليس لدينا في الورقة جهاز أو ملف لنجزم أن كل طبقة أصبحت صحيحة أو أن الزمن نقص.
كذلك فرق 0.48 بين ناتجي عمليتنا ليس نسبة خطأ شبكة أو حكمًا على نجاح التدريب. نحتاج إلى هدف ومقياس ومدخلات قبل ربط ذلك بجودة مهمة. ولم نجر تحديثًا للوزن أو نرصد كيف يتعلم النموذج تحت المحاكاة.
يبين الرسم تعاقب الإعداد والمحاكاة والتحويل وفحص الأثر. الحفاظ على هذه المراحل يجعل سؤال «هل اكتمل النموذج المكمم؟» مرتبطًا بملف وإعداد معروفين، بدل اختصاره في اسم أسلوب تدريب.
المصادر ومتابعة القراءة
- TensorFlow Model Optimization: Quantization aware training (يفتح في نافذة جديدة)tensorflow.org
- TensorFlow: Quantization aware training comprehensive guide (يفتح في نافذة جديدة)tensorflow.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.