
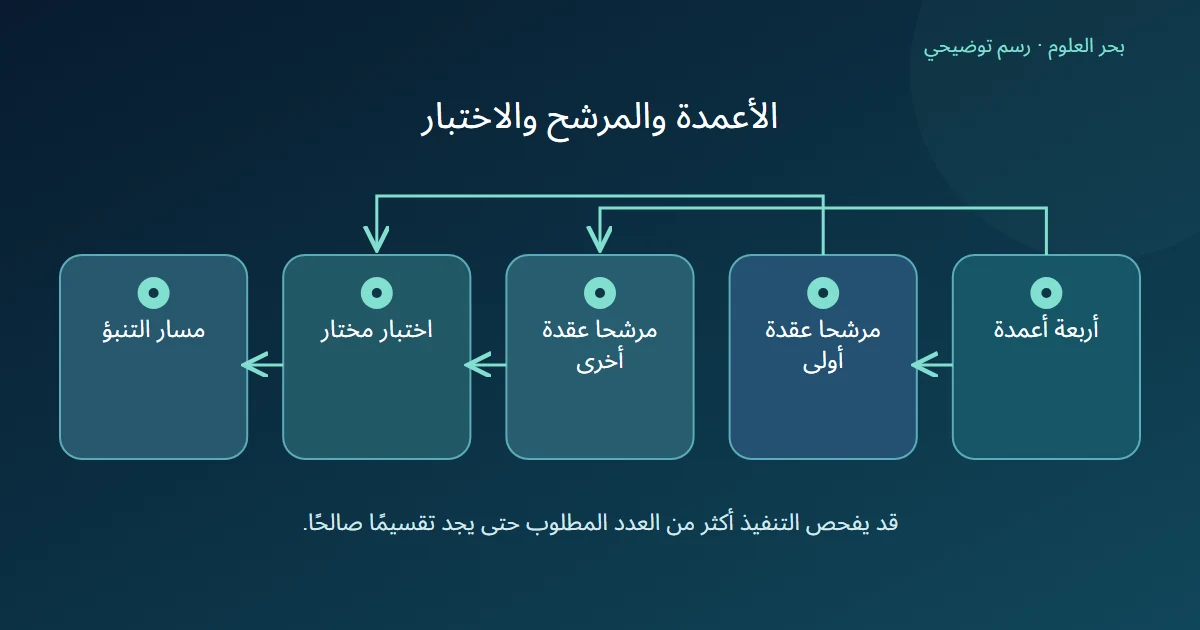
عدد الخصائص عند كل انقسام يحدد مجموعة المرشحين التي ينظر إليها بناء الشجرة عند البحث عن سؤال. يختلف ذلك عن حذف أعمدة من البيانات، أو فرض قائمة واحدة ثابتة على كل أشجار الغابة. [1]
الخلاصة السريعة
راجع إعداد max_features بوصفه تحكمًا في البحث داخل العقدة، ثم قارن أثره في المهمة. في التنفيذ الموثق قد يفحص البحث خصائص أكثر حتى يجد تقسيمًا صالحًا. [1]
- تأخذ الغابة مجموعة خصائص عشوائية عند كل عقدة؛ حجم المجموعة يختلف عن عدد أعمدة البيانات الأصلية. [2]
- في المثال، عقدة تنظر إلى اللون والحجم، وأخرى إلى السمك والرمز؛ القوائم مصطنعة وليست نتيجة تدريب.
- في RandomForestClassifier يكون الافتراضي sqrt؛ ولتسع خصائص يكون الجذر التربيعي 3. [1]
- قد يفحص التنفيذ أكثر من max_features لإيجاد تقسيم صالح؛ قارن الإعدادات ولا تعتبر العدد حدًا مطلقًا. [1]
أين يحصل الاختيار؟
تصف دراسة الغابات اختيار مجموعة صغيرة عشوائية من الخصائص عند كل عقدة للبحث عن الانقسام. [2]
نفترض أربع خصائص لبطاقات تعليمية: اللون والحجم والسمك والرمز. لو كان حجم المجموعة اثنتين، فقد ترى عقدة اللون والحجم، وترى عقدة أخرى السمك والرمز. من هذين المرشحين تختار قاعدة البناء سؤالها. لا نقول إن الخصائص الأخرى اختفت من جدول البيانات، أو إن كل شجرة ملزمة بالزوج الأول.
اكتب في وصف النموذج ثلاثة أشياء منفصلة: عدد أعمدة الإدخال، وعدد المرشحين في العقدة، والخاصية التي استعملها الاختبار المختار. مساواة هذه الأعداد أو الأسماء ببعضها تحجب معنى العشوائية التي نريد تفسيرها.
ليس حذفًا للأعمدة
إذا حذفت عمود السمك من المدخل أصلًا، فلن يستطيع أي اختبار استعماله. أما إذا بقي في المدخل لكنه لم يقع ضمن مرشحي عقدة معينة، فقد يظهر ضمن المرشحين في عقدة أخرى. هذا استنتاج من مثال الاختيار، وليس توصية بإبقاء عمود في كل مهمة.
يمكن أن تبدأ شجرتان بخاصيتين مختلفتين رغم أنهما تستقبلان أسماء الأعمدة نفسها. لا يعني ذلك تغير تعريف اللون أو السمك. اختلاف فرصة النظر إلى المرشحين يختلف عن تغيير بيانات البطاقة. ولتفسير حالة، ارجع إلى الاختبارات المختارة في مسارها، لا إلى الإعداد العددي وحده.
كيف نقرأ القيمة في البرنامج؟
توثق RandomForestClassifier القيم الصحيحة كعدد مرشحين، والكسور كنسبة، وsqrt للجذر التربيعي، وNone لكل الخصائص. الافتراضي الموثق حاليًا sqrt. [1]
مثال حسابي مستقل: إذا كانت لديك تسع خصائص، فالجذر التربيعي للتسعة يساوي ثلاثة. هذا يشرح تحويل القيمة فقط، ولا يثبت أن ثلاثة هو العدد الأفضل للمهمة. ولا تنقل إعدادًا افتراضيًا من مصنف إلى برنامج آخر دون قراءة توثيقه؛ اسم الإعداد المشترك لا يضمن تطابق كل تفاصيله.
ما الاستثناء الذي يهم؟
تنبه الوثائق إلى أن البحث يستمر حتى يجد تقسيمًا صالحًا، ولو تطلب ذلك فحص خصائص أكثر من max_features. [1]
لذلك لا تكتب في تقرير التنفيذ أن العدد سقف لا يتجاوزه أي بحث. وإذا قارنت حجم مجموعات مختلفًا، سجل أداء النموذج والتكلفة كما ظهرا فعلًا، واحتفظ ببقية إعدادات المقارنة. لا يوجد في المثال قياس يقرر أفضل عدد. الفائدة المقصودة هي تنويع فرص اختيار الأسئلة، مع التحقق من أن الأسئلة الناتجة تخدم المهمة.
المصادر ومتابعة القراءة
- scikit-learn: RandomForestClassifier (يفتح في نافذة جديدة)scikit-learn.org
- Breiman: Random Forests (يفتح في نافذة جديدة)stat.berkeley.edu
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.