
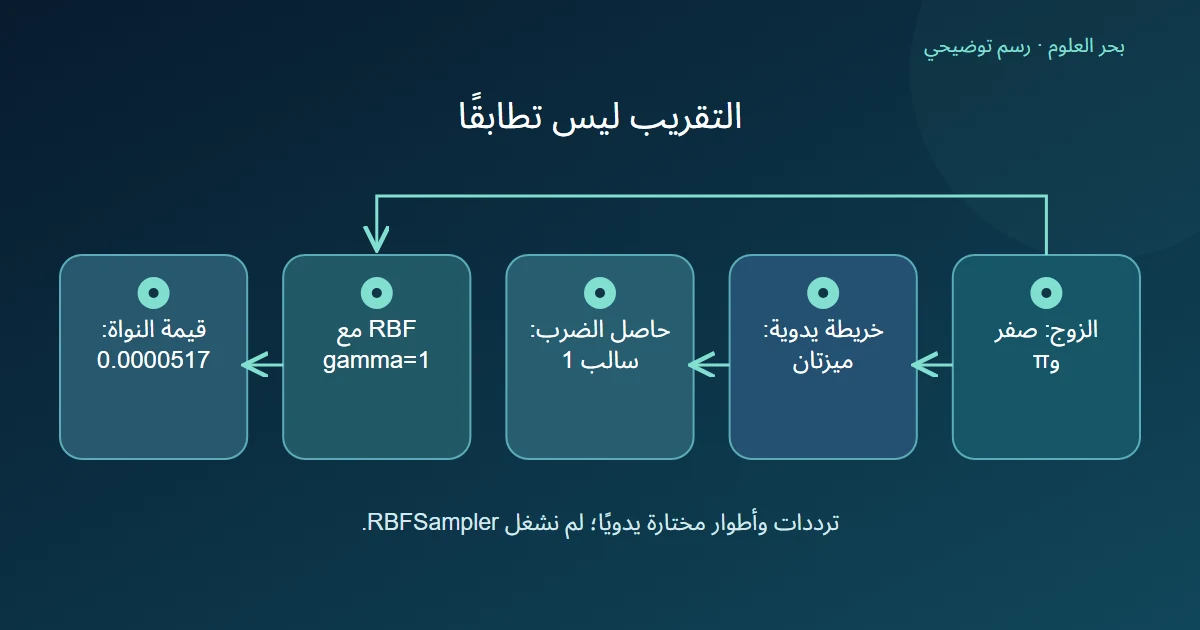
تعطي ميزات فورييه العشوائية تمثيلًا صريحًا يُقرب حاصل ضربه الداخلي نواة مناسبة، بدل حساب النواة الأصلية لكل زوج مباشرة. [1]
الخلاصة السريعة
التقريب يبني خريطة ميزات محدودة؛ حاصل الضرب الناتج ليس نسخة مطابقة للنواة لكل زوج. مثالنا الصغير المختار يدويًا يوضح الفرق، ولا يمثل نتيجة RBFSampler فعلية.
- تستعمل الطريقة ترددات وأطوارًا عشوائية بتوزيع مناسب للنواة، ثم تقربها بحاصل ضرب الميزات. [1]
- خريطتنا اليدوية ذات ميزتين تعطي −1 بين صفر وπ؛ نواة RBF ذات gamma=1 تعطي نحو 0.0000517. ليست الخريطة تجربة سحب عشوائي.
- احتفظ بالخريطة نفسها عند تحويل الحالات الجديدة؛ تغيير الترددات أو الأطوار يغير معنى أعمدة المثال.
- تقارن أبعاد 1000×50 و 1000×1000 عدد الخانات فقط؛ لا تثبت زمنًا أو استهلاك ذاكرة فعليًا ولا جودة تنبؤ.
كيف تظهر النواة داخل ميزات صريحة؟
تصف الورقة بناء ميزات جيب تمام بترددات مسحوبة من التوزيع المرتبط بالنواة، وأطوار منتظمة، مع تطبيع يعتمد على عدد الميزات D. متوسط حاصل الضرب يقرب النواة. [1]
نقرأ الشكل z(x)=√(2/D)×[cos(ω₁x+b₁)،…،cos(ωDx+bD)]. الرموز تحدد دوالًا تحول المدخل إلى أعمدة جديدة؛ لا تمثل الفئات التي نتوقعها. تبقى خطوة القرار أو الانحدار منفصلة عن هذا التحويل.
لتجنب الخلط سنختار قيمًا سهلة للحساب، ونعلن أنها اختيار يدوي. وجود جيب تمام في خريطة لا يكفي وحده للقول إن تردداتها سُحبت بالتوزيع الذي تتطلبه الطريقة.
خريطة صغيرة لا تساوي النواة الأصلية
نضع D=2 والترددين 1 و 2، والطورين صفر وπ/2. يصبح معامل التطبيع واحدًا، وخريطتنا z(x)=[cos(x)،cos(2x+π/2)].
عند x=0 نحصل رياضيًا على [1، 0]، وعند x=π على [−1، 0]. حاصل الضرب −1. في المقابل، نواة RBF التي نختارها للمقارنة exp(−(x−z)²) تعطي بين النقطتين exp(−π²)، أي نحو 0.0000517.
هذا اختلاف كبير عمدًا في مثال ذي ميزتين مختارتين؛ لم نشغل RBFSampler ولم نزعم أنه نتيجة عشوائية معتادة. وهو يبين لماذا لا يجوز استبدال كلمة تقريب بكلمة تطابق، أو تفسير القيمة السالبة هنا بوصفها احتمالًا سالبًا.
لماذا يجب أن يبقى التحويل نفسه؟
يوثق RBFSampler عدد المكونات والترددات والأطوار المخزنة، ويتيح random_state للتحكم في السحب. كما يدعم gamma عددية أو scale التي تعتمد على تباين البيانات. [2]
في مثالنا، إذا غيرنا الطور الأول بعد بناء نموذج على الأعمدة السابقة، فقد يصبح العمود الأول دالة مختلفة. لا يكفي أن يظل عدد الأعمدة اثنين؛ وزن مرتبط بـcos(x) لا يصبح تلقائيًا وزنًا للدالة الجديدة.
لذلك نفرق بين تحويل حالة جديدة بالخريطة المحفوظة وإنشاء خريطة جديدة ثم تسميتها التحويل القديم. ثبات وصف الأعمدة هو الشرط الذي نعتمد عليه في هذه المقارنة، لا ثبات الاسم فقط.
ماذا يخبرنا حجم الجدول؟
نتخيل 1000 حالة و 50 ميزة محولة؛ الجدول يحوي 50000 خانة. ومصفوفة جميع الأزواج بين 1000 حالة تحوي مليون خانة. حسبنا عدد الخانات فقط في شكلين مفترضين.
لا يثبت ذلك مقدار الذاكرة على جهاز معين؛ تمثيل الأعداد والخطوات الأخرى غير محددة. ولا يثبت أن خمسين ميزة تكفي لتنبؤ مفيد، إذ لم نقس خطأ التقريب أو أداء مهمة فعلية.
عند قراءة مقارنة عملية اطلب فصل حجم التمثيل عن جودة التقريب وعن جودة القرار النهائي. مثالنا يشرح ما يتغير داخل الخريطة، ويترك هذه القياسات لنتائج تُحسب على البيانات والإعدادات المعلنة فعلًا.
المصادر ومتابعة القراءة
- Rahimi وRecht: Random Features for Large-Scale Kernel Machines (يفتح في نافذة جديدة)people.eecs.berkeley.edu
- scikit-learn: RBFSampler (يفتح في نافذة جديدة)scikit-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.