
شجرة الانحدار تنتج قيمة عددية عند الورقة. في DecisionTreeRegressor مع معيار squared_error، تتعلم الورقة متوسط قيم أهداف أمثلة التدريب التي وصلت إليها. أما معيار absolute_error فيستخدم الوسيط. [1]
الخلاصة السريعة
تتقاسم الحالات التي تصل إلى الورقة نفسها قيمة التنبؤ المتعلمة؛ لذلك قد يتغير الناتج فجأة عند عبور حد بين ورقتين.
- الناتج قيمة عددية؛ المتوسط مرتبط بمعيار الخطأ التربيعي، وليس قاعدة لكل إعداد انحدار. [1]
- في مثالنا، تعطي أزمنة 4 و 6 و 8 داخل ورقة متوسطًا 6 دقائق للحالات التي تصل إليها.
- اختبار واحد قد ينتج درجتين ثابتتين؛ قرب المدخلين لا يضمن تقارب التنبؤ عند حد التقسيم.
- لا يمتد خط تصاعدي تلقائيًا خارج نطاق المثال؛ افحص المسار والقيمة وعدد الأمثلة قبل تفسير التقدير.
كيف يختلف الرقم عن اسم الفئة؟
في التصنيف قد تنتظر اسمًا مثل «جاهز». في هذا المقال نريد تقدير مدة تجهيز بالدقائق. يحدد معيار التدريب ما تلخص به الورقة أهداف أمثلتها؛ توثق scikit-learn المتوسط للخطأ التربيعي والوسيط للخطأ المطلق. [1]
لا تخلط خاصية الإدخال بالهدف. سنستخدم عدد القطع في الطلب بوصفه مدخلًا، والوقت الفعلي المنقضي بوصفه هدفًا. المتوسط الذي نحسبه يخص أزمنة التجهيز، وليس متوسط أعداد القطع. اكتب الوحدتين في الجدول لتبقى العلاقة واضحة.
مثال: ماذا تتعلم ورقة واحدة؟
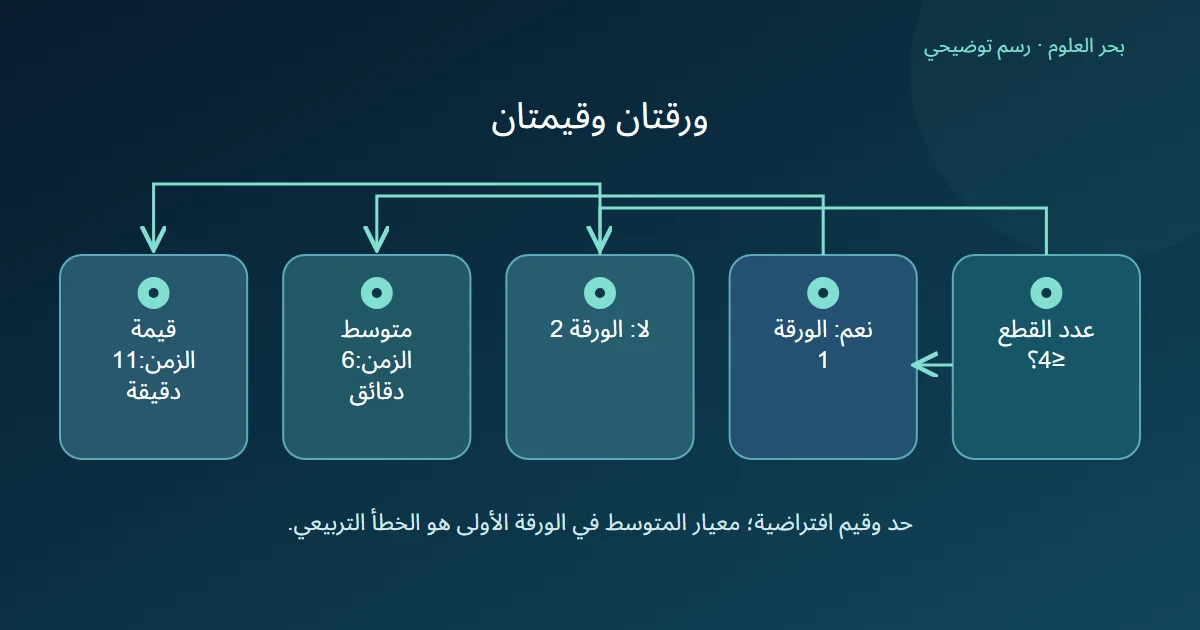
نفرض للتوضيح أن اختبارًا يرسل الطلبات ذات أربع قطع أو أقل إلى ورقة أولى. وصلت إليها ثلاثة أمثلة بأزمنة 4 و 6 و 8 دقائق. عند استخدام المتوسط، قيمة الورقة (4 +6 +8) ÷3 =6 دقائق. كل هذه الأرقام من إعداد المقال، ولم نجمع طلبات حقيقية.
طلب جديد من ثلاث قطع يتبع هذا الفرع ويأخذ 6، وطلب من أربع قطع يأخذ 6 أيضًا في الشجرة المفروضة. اختلاف عدد القطع بينهما لم يفتح اختبارًا جديدًا داخل الورقة. لذلك لا نعدل الرقم بأنفسنا إلى 5 أو 7 لمجرد اختلاف المدخل؛ نقرأ القيمة التي يمثلها النموذج.
لماذا قد يظهر التنبؤ كدرجات؟
أكمل مثالنا بورقة ثانية للطلبات التي تزيد على أربع قطع، تعلمت افتراضيًا قيمة 11 دقيقة. يصبح الناتج 6 للمدخل 4، و 11 للمدخل 5. الفرق خطوة كاملة بين ورقتين، وليس انتقالًا تدريجيًا نضيف فيه دقيقة لكل قطعة.
ارسم محور عدد القطع ثم ضع قيمتين أفقيتين على جانبي الحد. يمكن لشجرة أكثر تفصيلًا إنشاء أوراق أخرى، لكن المثال هنا لا يثبت حاجتها أو نجاحها. يعرض المثال الرسمي للانحدار كيف قد تتعلم شجرة عميقة تفاصيل الضوضاء. [2]
لا تفسر القفزة بأنها تغير مفاجئ حقيقي في العمل. إنها ناتج التقسيم الذي افترضناه. لفحصها تحتاج حالات قرب الحد، وسؤالًا محددًا عما إذا كان الفرق في التنبؤ مفيدًا للمهمة.
ماذا يحدث لمدخل بعيد عن الأمثلة؟
إذا كانت الشجرة المفروضة لا تختبر إلا «أربع قطع أو أقل»، فإن طلبًا من 100 قطعة يسلك الفرع الثاني ويأخذ 11 أيضًا. هذا استنتاج من القاعدة المصنوعة، لا تقدير واقعي لطلب ضخم. لم تتعلم الشجرة خطًا يمتد من 6 إلى 11 ثم يواصل الزيادة مع كل قطعة.
أرفق التنبؤ بمراجعة حدود البيانات التي بُنيت منها الورقة، وعدد أمثلتها، ووحدة الهدف. عند وجود مدخل بعيد، اسأل إن كانت أمثلة المهمة تدعمه قبل الاعتماد على الرقم. سهولة حساب المتوسط لا تجعل الحالة الجديدة ممثلة تلقائيًا في التدريب.
المصادر ومتابعة القراءة
- scikit-learn: DecisionTreeRegressor — criterion (يفتح في نافذة جديدة)scikit-learn.org
- scikit-learn: Decision Tree Regression (يفتح في نافذة جديدة)scikit-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.