
SGD طريقة تحسين لتدريب نموذج، وليست عائلة نماذج مستقلة. يدعم SGDClassifier خسائر وعقوبات مختلفة لمصنفات خطية. [1]
الخلاصة السريعة
يحدث SGD المعاملات باستعمال اتجاه خسارة مثال تدريب ومعدل تعلم؛ أما partial_fit فينفذ مرورًا واحدًا على الأمثلة المقدمة، ولا يضمن بلوغ الحد الأدنى. [1] [2]
- يغير اختيار الخسارة النموذج الذي ندرّبه؛ مع log_loss يكون تدريب انحدار لوجستي بـSGD. [1]
- التحديث يطرح معدل التعلم مضروبًا في اتجاه التدرج مع أثر التنظيم إن استعمل؛ المثال العددي يفترض الاتجاه ولا يقيسه. [1]
- في أول partial_fit، قدم مجموعة الفئات عبر جميع الاستدعاءات، حتى إن لم تضم الدفعة الحالية كل الفئات. [2]
- استدعاء partial_fit واحد لا يضمن التقارب؛ إدارة التوقف والتقارب ومعدل التعلم مسؤولية المستخدم. [2]
SGD يصف طريقة التدريب
يوضح الدليل أن SGD تقنية تحسين. مثلًا، SGDClassifier بخسارة log_loss يعطي انحدارًا لوجستيًا مدربًا بهذه التقنية، بدل استعمال محلل آخر. [1]
لذلك لا تكفي مقارنة اسم «SGD» باسم «انحدار لوجستي» لتحديد ما اختلف. قد يكون التغير في طريقة العثور على المعاملات، وقد يكون في الخسارة أو التنظيم أيضًا. اكتب هذه العناصر في أعمدة منفصلة حتى يفهم القارئ السؤال الذي اختبرته.
مثال: اتجاهان لا خطوة ثابتة للأمام
في الصيغة الموضحة بالدليل، يطرح التحديث معدل التعلم مضروبًا في مجموع اتجاه خسارة المثال واتجاه التنظيم، إن وجد. [1]
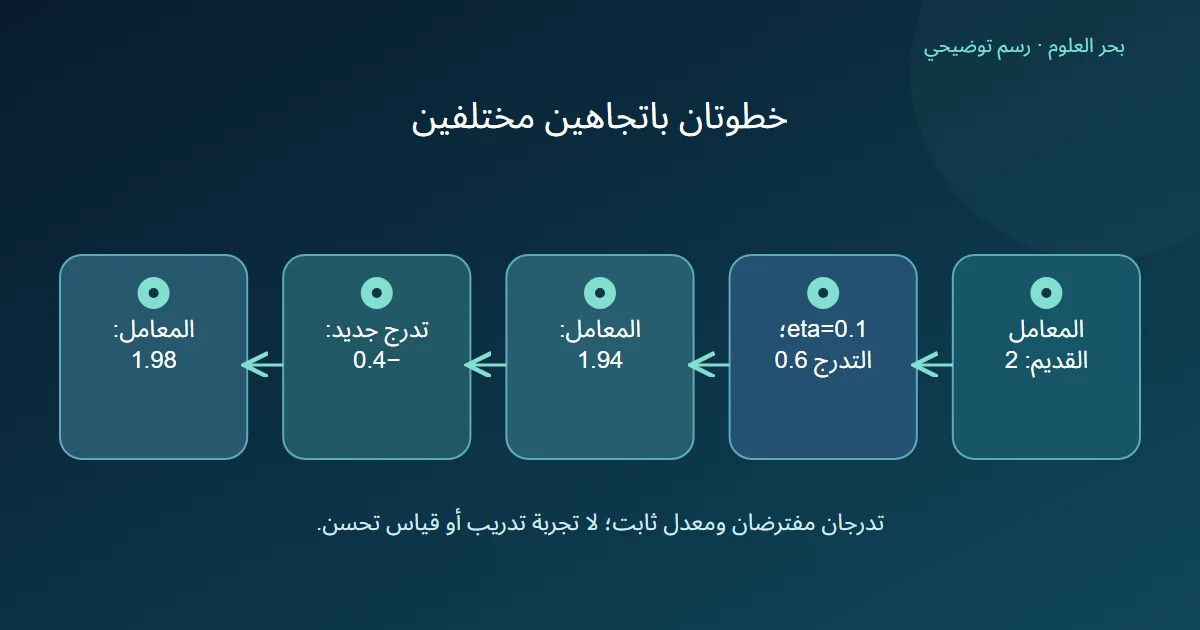
لنقرأ التحديث لمعامل واحد بأرقام من إعداد المقال. قيمته القديمة 2، ومعدل التعلم 0.1، والاتجاه الكلي المفترض 0.6. تصبح القيمة 2−0.1×0.6=1.94. مقدار 0.6 هنا قيمة افترضناها للتدرج، لا خطأ تصنيف ولا احتمالًا ولا متبقيًا يلزم أن نطرحه مباشرة.
وفي خطوة لاحقة نفترض أن الاتجاه الكلي أعيد حسابه وأصبح −0.4، مع معدل التعلم نفسه. تصبح القيمة 1.94−0.1×(−0.4)=1.98. تحرك المعامل نحو الأعلى هذه المرة، لأن الاتجاه سالب. لم نفترض بقاء التدرج ثابتًا عبر الأمثلة.
هذه قراءة لعملية الطرح فقط. لم نختر دالة خسارة وبيانات تكفي لاشتقاق الاتجاهين، ولم نثبت أن الخطوتين حسنتا تصنيفًا. وإذا جعلنا معدل الخطوة الأولى 0.2 مع الاتجاه نفسه، كانت القيمة 1.88؛ كبر التغير وحده لا يحدد أفضل معدل تعلم.
ماذا يحتاج أول استدعاء جزئي؟
ينفذ partial_fit مرورًا واحدًا على الأمثلة المقدمة. ويطلب أول استدعاء classes التي تشمل الفئات عبر كل الاستدعاءات، ويمكن حذفها لاحقًا. ليس مطلوبًا أن يحتوي y في كل دفعة على جميعها. [2]
تخيل مهمة فئتاها المعروفتان «مربع» و«مثلث». وصلت الدفعة الأولى ببطاقات المربعات فقط، ثم وصلت مثلثات في الثانية. وصف فئات المهمة يجب أن يشمل الاثنين منذ الاستدعاء الأول؛ وصول فئة في دفعة لاحقة يختلف عن تحديد مهمة ذات فئة واحدة.
حددنا الفئتين من تعريف المهمة، ولم نستنتجهما باختلاق سجلات. كذلك مرور واحد على دفعة من عشر بطاقات ليس مرادفًا لتحديث على بطاقة واحدة فقط؛ عدد الأمثلة في الدفعة جزء من وصف ما حدث.
كيف نميز استمرار التعلم عن اكتماله؟
يحذر التوثيق من أن استدعاء partial_fit مرة واحدة لا يضمن الوصول إلى حد أدنى للكلفة؛ يحتاج المستخدم إلى إدارة التقارب والإيقاف وتعديلات معدل التعلم. [2]
في سجل العمل، اكتب ترتيب الدفعات وعدد المرور عليها ومعدل التعلم والخسارة والإعدادات ذات الصلة. ثم قدم مقياس نجاح المهمة الذي رصدته. ظهور معاملات جديدة يعني أن التحديث تم، لكنه لا يثبت أن تدريبًا كاملًا انتهى أو أن النموذج يصلح لكل بطاقة لاحقة.
المصادر ومتابعة القراءة
- scikit-learn: Stochastic Gradient Descent (يفتح في نافذة جديدة)scikit-learn.org
- scikit-learn: SGDClassifier، partial_fit (يفتح في نافذة جديدة)scikit-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.