
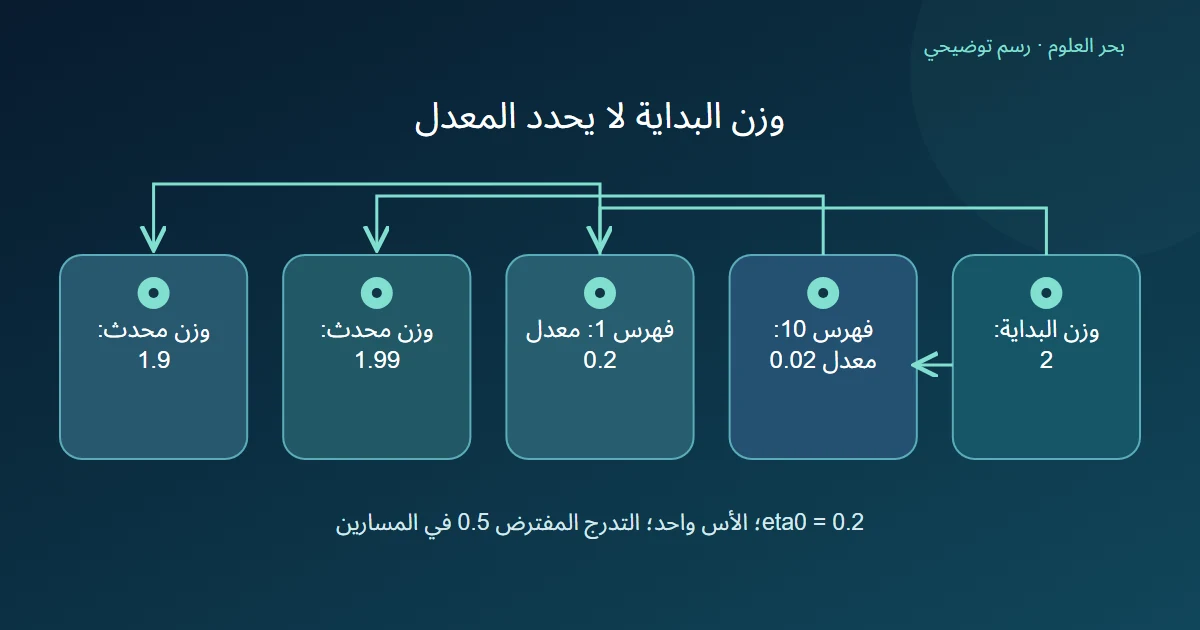
سؤال warm_start وعداد التعلم في SGD يخص حالتين منفصلتين: من أين تبدأ الأوزان، وأي فهرس يدخل معدل التعلم؟ قد تعود البداية العددية نفسها مع اختلاف الفهرس. نقرأ عقد SGDClassifier، ثم نعزل هذا الفرق في تحديث واحد ذي تدرج مفترض، حتى لا نسمي حفظ المعاملات استئنافًا كاملًا لكل الحالة.
الخلاصة السريعة
حفظ الأوزان لا يحدد العداد: fit يعيد ضبطه وpartial_fit يزيده في SGDClassifier. [1]
- warm_start يعيد استعمال الحل السابق للتهيئة؛ هذا وصف للأوزان المحفوظة. [1]
- يوثق SGDClassifier أن fit يعيد ضبط العداد وpartial_fit يزيده. [1] هذه معلومة عن الاستدعاء، لا نتيجة سجل تدريب نفذناه.
- في ورقتنا المعدل 0.2 مقسومًا على الفهرس ذي الأس واحد؛ الفهرسان 10 و 1 يعطيان 0.02 و 0.2، ومع وزن اثنين وتدرج ثابت 0.5 ينتجان 1.99 و 1.9.
- المعدل الثابت يجعل تحديثنا المنفرد متساويًا، ولا يثبت تكافؤ تدريب كامل؛ الفهرسان والتدرج معلنان ولم ننفذ fit أو partial_fit أو قياس أداء.
أي حالة أعادها حفظ الأوزان؟
warm_start يستعمل حل الاستدعاء السابق للتهيئة بدل مسحه. [1]
نبدأ دفتر مقارنة بوزن قيمته اثنان، محفوظ من عمل سابق مفترض. في المسارين ننسخ هذا العدد نفسه إلى خانة البداية. تساوي خانة الوزن لا يحدد قيمة عداد أو ترتيب أمثلة أو عدد مرور؛ تلك حقول أخرى يلزم وصفها إن أردنا مقارنة الاستئناف.
ولا نعامل الاسم الإنجليزي ضمانًا بأن ملفًا يحفظ كل الحالة. المصدر هنا يصف خيار مقدر معين، وليس عقد حزمة تخزين كاملة. إذا لم يحمل سجلنا سوى الوزن، نعرف هذا الرقم ونترك بقية الحقول غير محددة إلى أن يعلنها المثال أو مصدر فعلي.
لماذا يهم نوع الاستدعاء للعداد؟
مع معدل ديناميكي يعتمد التعلم على العينات المشاهدة؛ fit يعيد ضبط العداد، وpartial_fit يزيده. [1]
هذه قاعدة نقرأها في توثيق SGDClassifier، ولا نستخرجها من رؤية وزن لم يتغير كثيرًا. يمكن للأوزان أن تتقارب عدديًا رغم اختلاف ما جرى في العداد. نسجل اسم الاستدعاء وإعداداته بدل تخمينه من حجم التعديل.
سنعلن في الورقة مسارين مستقلين لهما فهرسا معدل عشرة وواحد. لا نزعم أن استدعاء حقيقي على دفعة مجهولة أعطى هذين الفهرسين، أو أن عشرة هي عدد بطاقات أرسلناها. اخترنا قيمتين موجبتين لاختبار أثر الفهرس داخل معادلة معروفة.
كيف يختلف تحديث واحد عند تغيير الفهرس؟
مع invscaling يكون المعدل eta0 مقسومًا على t مرفوعًا للأس power_t. [1]
نختار eta0 = 0.2 وpower_t = 1. عند t = 10 يصبح المعدل 0.02، وعند t = 1 يصبح 0.2. نثبت الوزن الابتدائي اثنين والتدرج الكلي الموجب 0.5 في المسارين، ثم نطرح المعدل مضروبًا في هذا التدرج.
المسار الأول يعطي 2 − 0.02 × 0.5 = 1.99. والثاني يعطي 2 − 0.2 × 0.5 = 1.9. عزلنا التدرج لشرح القسمة فقط؛ لم نشتقه من بيانات أو خسارة أو تنظيم. لذلك ليس الفرق 0.09 تقديرًا لتحسن دقة، ولا مسافة رصدناها بين نموذجين مدربين.
هل يتلاشى كل فرق مع معدل ثابت؟
لو جعلنا المعدل 0.2 مستقلًا عن الفهرس في هذا التحديث المنفرد، صار الوزن الجديد 1.9 في الحالتين، مع ثبات الوزن والتدرج اللذين أعلنّاهما. هذا يثبت نتيجة الحساب المحدد فقط. لا يثبت أن المسارين سيظلان متساويين بعد أمثلة أو تدرجات أخرى.
يشير التوثيق إلى أن تكرار fit أو partial_fit قد يختلف عن fit واحد بسبب خلط البيانات. [1]
لذلك نراجع الأوزان والعداد وجدول المعدل وترتيب البيانات كلًا في خانته، ثم نقارن مقياس المهمة إذا نفذنا تدريبًا فعليًا. لم ننفذ هنا تدريبًا أو حفظ نموذج أو تحميله. الفائدة أن سؤال «هل استأنفنا؟» صار قابلًا للتفصيل: ما الذي بقي، وما الذي أعيد، وما الذي لم يسجله دفترنا؟
المصادر ومتابعة القراءة
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.