
عرض التنسور والذاكرة المشتركة يفسران لماذا لا يكفي عد الأشكال المعروضة لحساب الذاكرة. توثق PyTorch أن view يشارك بيانات التنسور الأصلي. [1] نضع عقدا حسابيا يميز عدد العناصر المنطقية عن التخزين الفريد.
الخلاصة السريعة
لا؛ إذا كانت التنسورات عروضا تشترك في التخزين، فإن عد عناصرها جميعا لا يساوي جمع مساحات مستقلة للبيانات نفسها.
- العرض في PyTorch يشارك البيانات الأصلية، وقد يظهر تعديلها عبر العرض في الأصل؛ ليس نسخة مستقلة بمجرد اختلاف الشكل. [1]
- نعلن أربع قيم مخزنة، وعرضين يرى كل منهما القيم الأربع نفسها. لدينا 12 عنصرا منطقيا عند جمع البطاقات، لكن حمولة القيم الفريدة أربعة عناصر.
- مع أربع بايتات لكل قيمة في فرضنا، الحمولة 16 بايتا. نسخة مستقلة كاملة تضيف 16 فتصير 32؛ هذا ليس قياس إجمالي ذاكرة الجهاز.
- لا تفترض أن reshape يشارك دائما: قد يعيد عرضا أو تنسورا جديدا. [1] راجع التخزين الفعلي وسياسة النسخ؛ لم نفحص مخصص ذاكرة أو نموذجًا.
الاسم والشكل لا يحددان ملكية البيانات
توضح PyTorch أن view يشارك البيانات مع الأصل، وأن تعديل بيانات العرض ينعكس في الأصل. [1]
يمكن أن يكون لدينا وصفان لكيفية قراءة الأرقام نفسها، دون أن نعلن وجود مجموعتين منفصلتين من الأرقام. لذلك نميز بطاقة التنسور التي تبين الشكل عن المخزن الذي توجد فيه البيانات. الاسم المختلف لا يحسم المشاركة أو الاستقلال.
ولا نعكس الاستنتاج: تساوي القيم أو الشكل لا يثبت أن المخزن واحد. قد تصنع نسخة مستقلة تبدأ بالأرقام نفسها. يلزم دليل على التخزين أو عقد واضح في المثال، لا مقارنة مرئية للأرقام وحدها.
أربع قيم وثلاث بطاقات
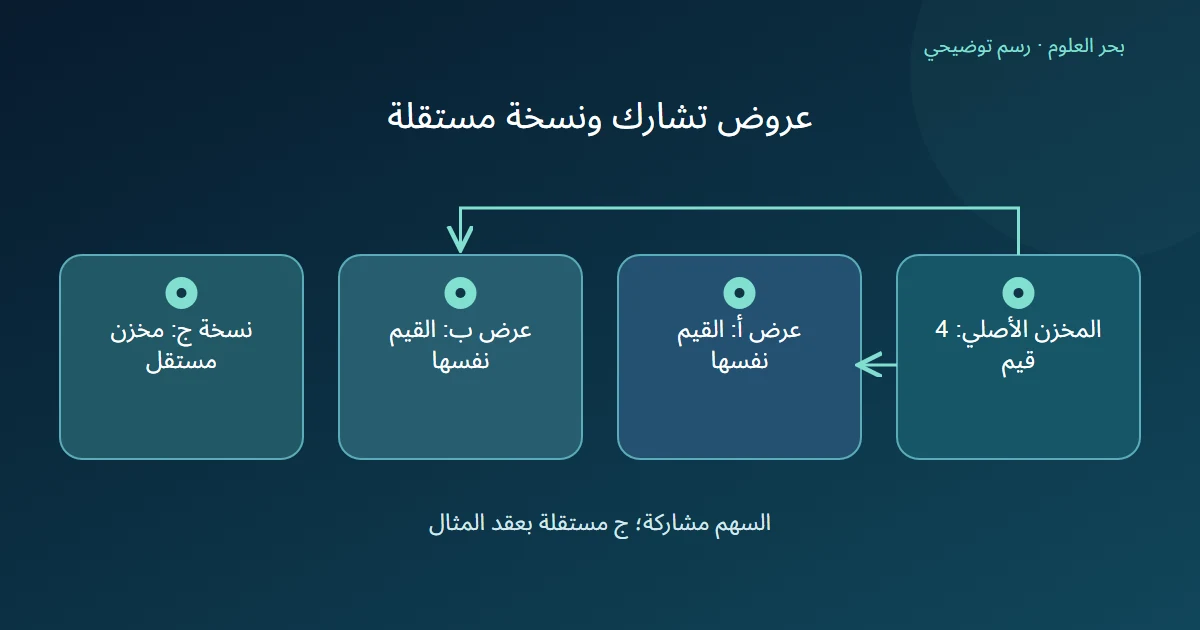
نؤلف مخزنا أساسيا فيه 5، 7، 9، 11. نعلن أن عرض أ يقرأ القيم الأربع كصف واحد، وعرض ب يقرأها كصفين وعمودين. كلاهما يشارك المخزن نفسه كله، ولم نصنع نسخة بيانات لأي منهما.
إذا جمعنا عناصر الأصل وأ والعرض ب نحصل على 4 + 4 + 4 = 12. هذا عدد عناصر في ثلاثة أوصاف منطقية. أما القيم المخزنة الفريدة في عقدنا فعددها أربعة، لا اثنا عشر. لا نعد الرقم 5 ثلاث مرات مخزنة لمجرد ظهوره في البطاقات الثلاث.
نعلن أن كل قيمة تشغل أربع بايتات في التمثيل الذي اخترناه. حمولة البيانات الفريدة هنا 4 × 4 = 16 بايتا. لا نضيف الحجم من جديد لكل عرض، ولا نقول إن العملية كلها أو الجهاز كله يحتاج 16 بايتا فقط.
ماذا تضيف نسخة مستقلة؟
نعلن الآن نسخة ج لها مخزن مستقل كامل يحوي القيم الأربع نفسها، بالحجم نفسه لكل عنصر. يصبح لدينا مخزنان، وحمولتهما 16 + 16 = 32 بايتا. لم تلغ المشاركة بين الأصل والعرضين لمجرد إضافة النسخة.
في فرضنا، تعديل موضع 7 عبر عرض مشترك إلى 70 يغير قراءة الموضع نفسه في الأصل والعرض الآخر. أما ج المستقلة فلا تتغير بهذا التعديل. هذه النتيجة من عقد المشاركة الذي أعلنّاه، لا تنفيذ عملية PyTorch جربناها.
ولا تنقل حساب الحمولة إلى إجمالي الذاكرة. لم نحسب بيانات وصف الأشكال أو إدارة المخازن أو مساحات أخرى يحتاجها الاستدلال. الغرض منع جمع البيانات المشتركة عدة مرات، لا تقديم رقم ذروة ذاكرة قابل للتعميم.
هل تغيير الشكل يعني عرضا دائما؟
تحذر الوثائق من افتراض المشاركة لعمليات reshape وflatten؛ قد تعيدان عرضا أو تنسورا جديدا. [1]
في مراجعة فعلية، نكتب أي الأوصاف تشارك مخزنا وأيها نتج عن نسخ مستقل، ثم نحسب المخازن الفريدة التي نعرفها. إذا لم نعرف نتيجة تغيير الشكل، نبقي ملكية التخزين غير محسومة بدل اعتماد اسم العملية دليلا كافيا.
الرسم يربط عرضين بمخزن معلن ويضع النسخة المستقلة بجانبه. لم نشغل نموذجا أو نقس RAM أو ذاكرة GPU. تبقى شروط المشاركة ونوع العنصر وحدود ما حسبناه ملازمة للرقم، لكي لا يصبح عد منطقي صحيح تقديرا خاطئا للذاكرة الفعلية.
المصادر ومتابعة القراءة
- PyTorch: Tensor Views (يفتح في نافذة جديدة)docs.pytorch.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.