
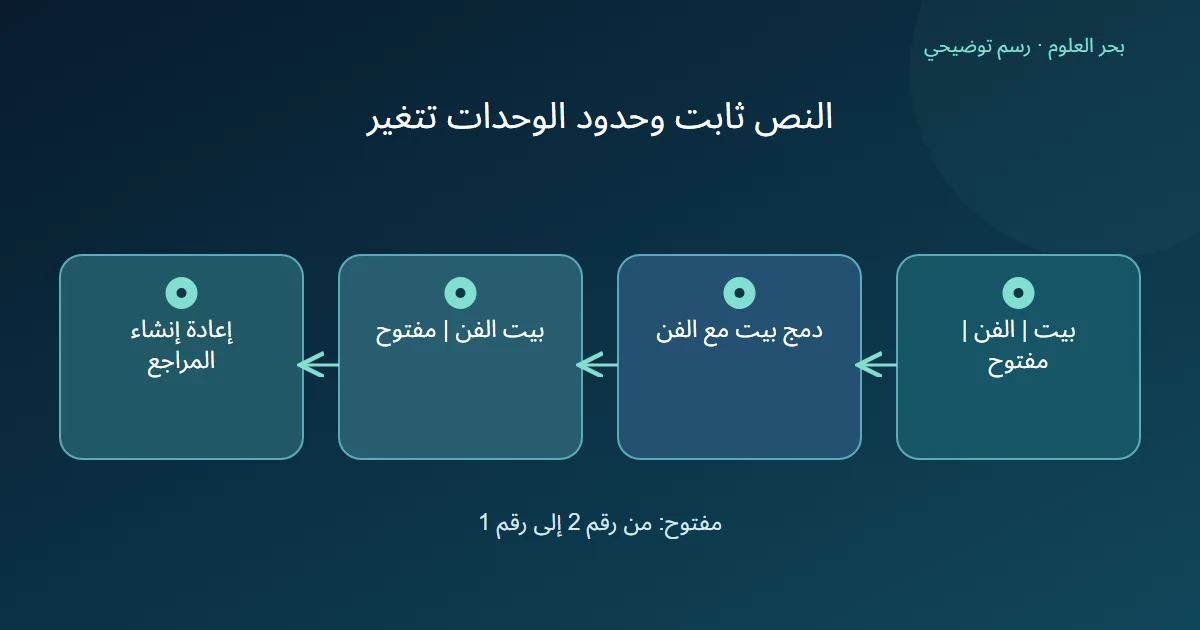
يريد فريق إعداد دليل قراءة جمع اسم مكان في وحدة واحدة قبل إرسال قائمة أسماء إلى المساعد. ظهرت وحدتان بعد أن كانت القائمة تضم ثلاث وحدات، فظن محرر أن كلمة حذفت. السؤال هنا عن إعادة تقسيم النص: ما الذي انتقل موضعه، وما الذي بقي مكتوبا؟ سنستخدم تقسيمًا معلنًا، لا نتيجة محلل عربي جربناه.
الخلاصة السريعة
اجمع الوحدات التي حددتها العملية، ثم راجع أرقام الوحدات الجديدة والنص الكامل بصورة منفصلة. انخفاض عدد الوحدات لا يثبت حذف حروف، ومراجع الوحدات والمقاطع القديمة تحتاج إلى إعادة إنشاء بعد الدمج.
- دمج مقطع في spaCy يصنع وحدة منه، وتطبق تغييرات إعادة التقسيم عند الخروج من السياق. [1]
- في مثالنا يصبح «بيت الفن» وحدة واحدة؛ ينتقل رقم «مفتوح» من 2 إلى 1، وتبقى عبارة النص نفسها.
- أعد إنشاء مراجع الوحدات والمقاطع بعد إعادة التقسيم؛ المراجع السابقة تبطل، حتى إن بدت قابلة للاستخدام. [1]
- قارن النص وحدود الوحدات وقائمة الأسماء المقصودة، ولا تجعل الدمج وحده حكمًا على صحة اسم أو جودة جواب المساعد.
ما العملية التي تنفذها؟
تصف وثائق spaCy عملية retokenizer.merge بأنها دمج Span في وحدة، وتؤجل تعديلات التقسيم إلى نهاية سياق Doc.retokenize. [1]
في تصميم دليلنا، يبدأ النص «بيت الفن مفتوح» بثلاث وحدات معلنة: «بيت»، و«الفن»، و«مفتوح». اخترنا أول وحدتين فقط لأن قائمة الدليل تريد تسمية المكان كاملة. لم نطلب استبدال العبارة بمرادف أو إزالة كلمة منها. هذه حدود المهمة التي سنقارن بها التمثيل الجديد.
أرقام جديدة لنص محفوظ
توضح الوثائق أن تقسيم spaCy يحفظ معلومات النص والمسافات، بحيث يطابق Doc.text النص المدخل. [2]
قبل الدمج، نعطي الوحدات الأرقام 0 و1 و2 بهذا الترتيب. بعد جمع «بيت الفن»، تصبح القائمة «بيت الفن» بالرقم 0، و«مفتوح» بالرقم 1. عبارة «بيت الفن مفتوح» ما زالت هي العبارة الأصلية. الفرق أن الاسم الطويل يشغل الآن موضع وحدة واحدة.
لو احتفظت ورقة المراجعة بعبارة «اقرأ الوحدة 1» من الحالة السابقة، فقد كانت تقصد «الفن»، بينما تقصد الآن «مفتوح». لذلك لا ننقل الرقم وحده بين الحالتين. حفظ الحروف لا يحفظ معنى كل إحالة قائمة على ترتيب الوحدات.
أعد بناء المراجع
تحذر الوثائق من بطلان Token وSpan المنشأة قبل إعادة التقسيم، مع احتمال استمرارها في العمل عرضًا. [1]
نقترح في ورقة المثال الاحتفاظ بالنص ومقطع الاسم المطلوب، ثم إعادة استخراج المراجع من الحالة الجديدة. لا نعتمد على أن مرجعًا قديمًا أعطى قيمة تبدو مألوفة مرة واحدة. ونوضح في السجل هل الرقم يشير إلى القائمة السابقة أم التالية.
هذا يفيد حين تتتابع خطوات إعداد مادة المساعد: قد تبني خطوة قائمة أسماء، ثم تستخدم خطوة ثانية أرقام مقاطع سابقة. نراجع الربط بين الخطوتين قبل نسبة إجابة غريبة إلى فهم النموذج نفسه.
ماذا تفحص في الناتج؟
نراجع ثلاثة أشياء مختلفة في مثالنا: بقاء النص، وحدود الوحدتين الجديدتين، وملاءمة اسم المكان لقائمة الدليل. إذا دمجنا «الفن مفتوح» بدلًا من «بيت الفن»، فقد يبقى النص محفوظًا مع فشل مقصدنا التحريري.
ولا يثبت نجاح هذا الربط أن «بيت الفن» اسم مكان حقيقي خارج المثال، أو أن المساعد سيكتب ساعات فتح صحيحة. نعطي كل فحص دليله: التقسيم من القائمة، والاسم من مرجع الدليل عند توفره، والحقائق الخارجية من مصدرها. الرسم يشرح إعادة التنظيم المعلنة فقط.
المصادر ومتابعة القراءة
- spaCy Doc retokenize and merge (يفتح في نافذة جديدة)spacy.io
- spaCy non-destructive tokenization (يفتح في نافذة جديدة)spacy.io
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.