
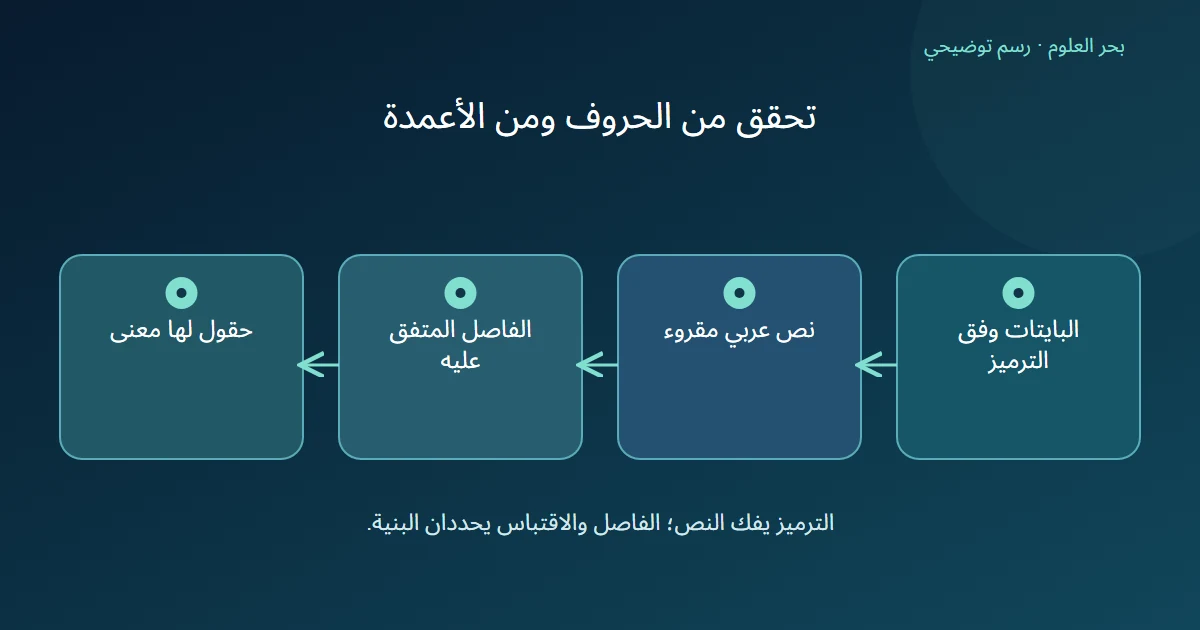
ترميز CSV وفاصل الأعمدة يجيبان عن سؤالين مختلفين. تعرض وثائق Python تحديد encoding عند فتح الملف، وتحديد delimiter عند تحليل حقوله. الأول يحدد فك البايتات إلى نص، والثاني يحدد علامة الفصل بين الحقول. [1]
الخلاصة السريعة
إذا كانت العربية مشوهة، راجع الترميز المعروف للمصدر؛ وإذا ظهر السجل كله في عمود واحد، راجع الفاصل وقاعدة القراءة. قد تصادف المشكلتين معا، لذلك تحقق من النص والبنية كل على حدة.
- إعداد الترميز وإعداد الفاصل مستقلان في مثال القراءة؛ ضبط أحدهما لا يثبت صحة الآخر. [1]
- سجل «دفتر؛8؛نسخة» افتراضي يحتاج الفاصلة المنقوطة العربية المعلنة، ولا تكفي سلامة ظهور كلمة دفتر.
- UTF-8 يستطيع تمثيل العربية؛ علامة BOM فيه قد تدل على الترميز، وبعض المستقبِلات لا تتوقعها. [2]
- احفظ الأصل، وتحقق من كلمة عربية معلومة وعدد الحقول وقيمها؛ لا تعلن النجاح من مظهر عمود واحد.
ما الفرق بين فك النص وتقسيم حقوله؟
في Python يمكن فتح الملف بتعيين encoding، ثم تمريره إلى قارئ csv ذي delimiter مناسب. [1]
الفاصل في ملف تعليمي قد يكون فاصلة إنجليزية أو علامة أخرى متفقا عليها. تغيير هذه العلامة لا يعيد تفسير البايتات التي جعلت كلمة عربية تظهر بحروف غريبة. وبالمقابل، فك النص وفق الترميز الصحيح لا يقرر تلقائيا أي علامة تقسم الأعمدة. نحتاج وصف المصدر لكل إعداد، مع قاعدة الاقتباس عندما تضم القيم علامة الفصل نفسها.
كيف نرى الخطأ البنيوي مع عربية سليمة؟
افترض أننا تسلمنا النص التعليمي «دفتر؛8؛نسخة»، واتفق صاحبه على أن الفاصل هو العلامة ؛ العربية. وصف السجل دفتر، والكمية ثماني نسخ. جميع التفاصيل مختلقة للشرح، ولم نقرأ ملفا فعليا.
إذا بحث القارئ عن الفاصلة الإنجليزية وحدها، فقد يبقى هذا السجل حقلا واحدا رغم وضوح حروفه. وإذا استعملنا العلامة المشابهة ; الإنجليزية بدلا من ؛ المتفق عليها، فإن التشابه البصري لا يجعل العلامتين متطابقتين. هذه ليست توصية باختيار فاصل عربي لكل ملف؛ إنها دعوة إلى مطابقة العلامة الفعلية في عقد المصدر.
| المراجعة | ما نفحصه في المثال |
|---|---|
| الحروف | ظهور كلمة دفتر كما كتبها المصدر |
| حدود الحقول | ثلاثة حقول وفق العلامة ؛ |
| معنى القيم | دفتر، كمية 8، وحدة نسخة |
هل إضافة BOM تضمن إصلاح الملف؟
توضح Unicode أن UTF-8 يمثل محارف Unicode، وأن BOM فيه توقيع محتمل للترميز، مع وجود مستقبِلات لا تتوقع هذا التوقيع. [2]
لذلك نراجع متطلبات البرنامج الذي سيستقبل الملف. لا نضيف علامة إلى نسخة خام مجهولة الترميز ثم نفترض أننا أصلحنا حروفها، ولا نعتقد أن التوقيع يحدد فاصل الأعمدة. إذا حفظ تحويل خاطئ فوق الأصل، فقد لا تكفي إعادة اختيار الترميز لاستعادة ما فقد؛ نعود إلى النسخة المحفوظة أو المصدر.
ما نتيجة التحقق المقبولة هنا؟
نقترح حفظ النسخة الأصلية، وتوثيق ترميز المصدر، واختيار الفاصل والاقتباس المناسبين في نسخة عمل. ثم نقارن كلمة عربية معلومة وثلاث قيم متوقعة في سجل مثالنا. إذا نجح النص وفشل عدد الحقول، نواصل مراجعة البنية؛ وإذا نجحت الأعمدة وفشلت الحروف، نواصل مراجعة فك النص.
لا نعمم إعدادات برنامج أو إصدار على كل الأجهزة، ولا ندعي تنفيذ هذه الخطوات فعليا هنا. قبل تجهيز بيانات نموذج، نراجع أيضا نوع كمية الدفاتر ووحدتها وحالة الغياب. صحة الحروف وحدود الأعمدة شرط لفهم الملف؛ لا تثبت وحدها دقة محتواه أو ملاءمته لمهمة الذكاء الاصطناعي.
المصادر ومتابعة القراءة
- Python: csv — CSV File Reading and Writing (يفتح في نافذة جديدة)docs.python.org
- Unicode: UTF-8, UTF-16, UTF-32 and BOM FAQ (يفتح في نافذة جديدة)unicode.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.