
المعالجة داخل التحقق المتقاطع تحتاج احترام فصل التدريب والتحقق في كل طية، حتى إذا بقي الاختبار النهائي جانبا. حساب إحصاء من كامل بيانات التطوير قبل الطيات قد يدخل قيم الجزء المحجوز للتحقق في معالجة الجزء الذي يدرب عليه النموذج.
الخلاصة السريعة
لا؛ عزل الاختبار النهائي لا يعزل طيات التحقق الداخلية عن تعلم المعالجة، لذا نتعلم إحصاء كل طية من تدريبها وحده.
- توضح وثائق scikit-learn أن خطوط المعالجة تساعد في تجنب تسرب إحصاءات التحقق المتقاطع بجعل التحويل والنموذج يتعلمان من العينات نفسها. [1]
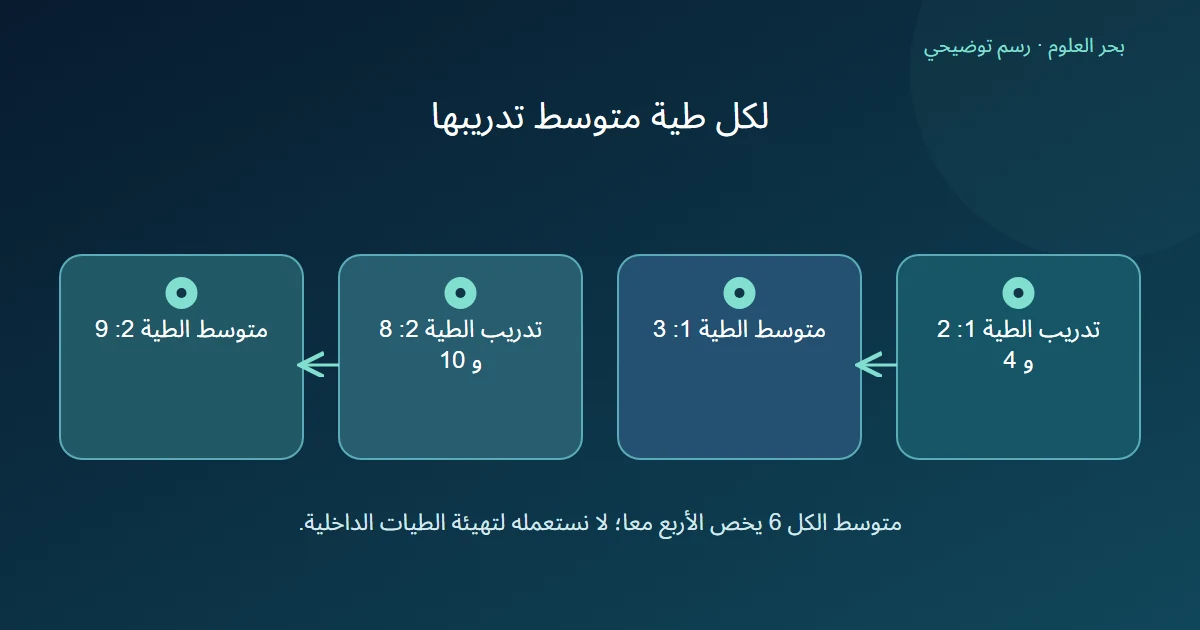
- نؤلف بيانات تطوير 2 و 4 و 8 و 10. متوسط الكل 6 ، بينما متوسط تدريب الطية الأولى 2 و 4 هو 3 ، ومتوسط تدريب الثانية 8 و 10 هو 9.
- في الطية الأولى نطرح 3 من التدريب ومن التحقق 8 و 10 ، فيصبح التحقق 5 و 7. حساب 6 مسبقا يستخدم أيضا قيم التحقق، ولو لم يستخدم أهدافها.
- نمرر الخطوات غير المتعلمة إلى إجراء الطيات، ثم نعيد التعلم على كامل بيانات التطوير بعد الاختيار عند الحاجة. متوسط 6 قد يلائم هذا التعلم النهائي، لكنه لا يصبح لذلك إحصاء تدريب صحيحا للطيتين السابقتين.
أين يقع الفصل الداخلي؟
تشرح وثائق scikit-learn أن Pipeline يساعد في تجنب تسرب الإحصاءات أثناء التحقق المتقاطع، لأنه يجعل تعلم التحويلات والمتنبئ يستعمل العينات نفسها. [1]
نفترض أولا أن الاختبار النهائي معزول ولا نستعمله في المثال. داخل بيانات التطوير المتبقية نختار تقسيم طيتين للتوضيح: ندرب على جزء ونتحقق بالآخر، ثم نعكس الدورين. تسمية الملف كله «تدريب» لا تجعل كل صف فيه تدريبًا في كل طية.
نحتاج لذلك تعريف «تدريب هذه الطية»، لا مجرد تعريف التدريب الخارجي. لا نشرح هنا اختيار عدد الطيات أو تقسيم الزمن والكيانات؛ نفترض أن العضوية الداخلية ثابتة ومناسبة للسؤال كي نعزل تعلم المعالجة.
كيف تختلف حالة المعالجة بين الطيتين؟
نؤلف أربع قيم معلومة، ونختار تحويل طرح متوسط التدريب من كل قيمة. الطية الأولى تتعلم 3 من 2 و 4 ، والثانية تتعلم 9 من 8 و 10. لا توجد ملاءمة نموذج أو درجات أداء في هذه الحسابات.
إذا طرحنا 3 في الطية الأولى، صار التدريب−1 و 1 ، والتحقق 8−3=5 و 10−3=7. لا نحسب متوسط تحقق جديدا، ولا نغير الإزاحة عندما نطبقها على صفوفه.
أما طرح 6 الذي حسب من كامل التطوير فيعطي تدريب−4 و−2 وتحقق 2 و 4. هذه أرقام مختلفة لأن قيم التحقق شاركت في الإزاحة 6. لم يدخل الاختبار النهائي، ومع ذلك دخل الجزء المحجوز للتحقق في تعلم معالجة طيته.
| مرحلة المثال | قيم تعلم المتوسط | المتوسط |
|---|---|---|
| تدريب الطية الأولى | 2 و 4 | 3 |
| تدريب الطية الثانية | 8 و 10 | 9 |
| كل التطوير معا | 2 و 4 و 8 و 10 | 6 |
هل تحتاج المشكلة إلى أهداف التحقق؟
في الحساب السابق تعلمنا المتوسط من قيم المدخل فقط، دون تقديم أي هدف. لذلك لا يكفي القول إن وسوم التحقق لم تستعمل إذا كانت إحصاءات مدخلاته دخلت الخطوة التي يفترض تعلمها من تدريب الطية.
في الطية الثانية نعيد تعلم المتوسط من 8 و 10 وحدهما، فنطرح 9 من هاتين القيمتين ومن تحقق 2 و 4. تصبح قيم التحقق−7 و−5. لا ننقل متوسط الطية الأولى 3 بوصفه متوسط تدريب الثانية.
نقترح أن يرى إجراء الطيات خط المعالجة الكامل بحالته غير المتعلمة، لا مصفوفة سبق تحويلها بإحصاء مشترك. ثم نراجع الإعداد والتنفيذ فعليا قبل أي ادعاء أن التسرب منع؛ وجود اسم Pipeline وحده لا يثبت ما أدخلناه إليه.
متى يكون متوسط كامل التطوير مناسبا؟
بعد مقارنة الإعدادات بالطريقة المحددة واختيارها، يمكن أن نحتاج تعلم المسار النهائي على كامل بيانات التطوير. في مثال طرح المتوسط، يصبح الإحصاء 6 لهذه المرحلة التي تدرب على الأربع معا. يطبق بعد ذلك الإحصاء المحفوظ على الاختبار النهائي دون إعادة تعلمه منه.
هذا استعمال مختلف عن تهيئة الطيات مسبقا بمتوسط 6. صلاحية إحصاء للمرحلة النهائية لا تجعله إحصاء تدريب للطية التي كان جزء من قيمه محجوزا للتحقق. نحفظ حالة كل مرحلة وما دخل تعلمها.
لا تثبت مقارنة المتوسطات حجم تحيز أي تقييم أو جودة الإعداد المختار. إنها تميز حدود المعلومات بين المراحل. وبعدها يبقى التحقق من عضوية الطيات وتوفر الميزات ومنع استعمال الاختبار النهائي في الاختيار جزءا من مراجعة التقييم.
المصادر ومتابعة القراءة
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.