
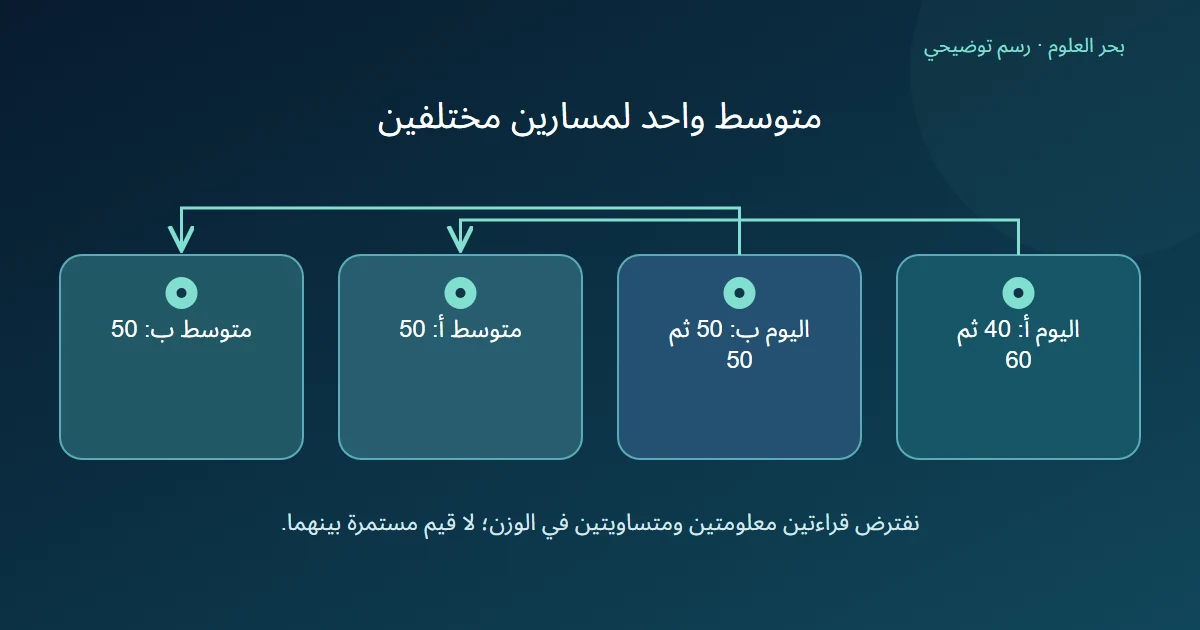
المتوسط اليومي للبيانات يلخص القيم التي أدخلناها في حسابه، لكنه لا يخبرنا وحده كيف تغيرت داخل اليوم. قد تنتهي قراءات مختلفة إلى المتوسط نفسه. لذلك نراجع ما إذا كان سؤال النموذج يحتاج هذا الملخص أو تفاصيل التوقيت والتغير.
الخلاصة السريعة
لا؛ المتوسط اليومي وحده لا يعيد القراءات الداخلية أو يكشف ترتيبها وقيمها القصوى.
- تحسب Resampler.mean في pandas متوسط قيم كل مجموعة مع استبعاد القيم المفقودة. [1] هنا نفترض قراءتين معلومتين ومتساويتين في الوزن لكل يوم.
- قراءتا يوم أ هما 40 و 60 ، ويوم ب 50 و 50. المتوسط 50 في الاثنين، لكن المجال من 40 إلى 60 في أ ومن 50 إلى 50 في ب.
- المتوسطان لا يثبتان تساوي المسارين أو عدد مرات تجاوز حد. وإذا لم نعرف القراءات الأصلية فلا نستنتجها من 50 وحدها.
- اختر الملخص بحسب السؤال، واحفظ عدد القراءات وتوقيتها وقاعدة الغياب. متوسط عينات متباعدة لا يصبح تلقائيا متوسطا زمنيا مستمرا.
ما الذي دخل حساب اليوم؟
تصف وثائق pandas عملية Resampler.mean بأنها حساب متوسط قيم المجموعات مع استبعاد القيم المفقودة. [1]
نحدد في مثالنا اليوم بحسب منطقة زمنية معلنة، ونضع فيه قراءتين معلومتين عند وقتين محددين. سنحسب المتوسط الحسابي للقراءتين بوزنين متساويين، دون إدخال تعويض لقيمة ناقصة أو حساب متوسط مستمر للزمن.
إذا غيرنا حدود اليوم أو القيم المقبولة أو الأوزان، فقد نغير ما يصفه الناتج. اسم «متوسط يومي» وحده لا يحدد هذه القواعد. نكتبها بجوار الملف المشتق قبل استخدامه مدخلا لنموذج.
كيف تنتج حالتان مختلفتان المتوسط نفسه؟
نختار أرقاما تعليمية لدرجة كمية عامة بوحدة واحدة معلنة، دون ربطها بحد صحي أو استهلاك حقيقي. في أ نجمع 40+60 ونقسم 100 على 2 ؛ وفي ب نجمع 50+50 ونقسم 100 على 2 أيضا.
إذا احتفظ الملف بالمتوسط فقط، حمل كل يوم الرقم 50. لكن الفرق بين أكبر وأصغر قراءة هو 20 في أ وصفر في ب. لا نستطيع استعادة هذا الفرق من المتوسط وحده، لأن الرقم نفسه يوافق أكثر من زوج.
كما أن عكس ترتيب 40 و 60 يبقي المتوسط 50. بذلك نفقد أيضا معرفة هل ارتفعت القراءتان أو انخفضتا، ما لم نحفظ معلومة أخرى عن التوقيت والقيم. الحساب لا يمثل تشغيل مسار تجميع فعلي.
| اليوم المفترض | القراءة الأولى | القراءة الثانية | المتوسط | الأصغر والأكبر |
|---|---|---|---|---|
| أ | 40 | 60 | 50 | 40 و 60 |
| ب | 50 | 50 | 50 | 50 و 50 |
أي سؤال لا يجيب عنه الملخص؟
لو عرّفنا في المثال حدا تعليميا مقداره 55 وسألنا هل تجاوزته قراءة مرصودة، فالجواب نعم في أ ولا في ب. ليس 55 حدا موصى به لأي تطبيق؛ اخترناه فقط للفصل بين الزوجين اللذين يخفيهما المتوسط 50.
وإذا سألنا كم استمر التجاوز، فلن تكفي حتى القراءتان وحدهما بلا معلومات عن القيم بين وقتيهما. لا نعامل ملاحظة مرتفعة واحدة على أنها ساعة كاملة أو نمط يوم متصل.
عند إعداد نموذج لتوقع ملخص يومي، قد يكون المتوسط نفسه جزءا مناسبا لتعريف المدخل. أما سؤال عن تغير داخلي فيحتاج المعلومات التي تصف ذلك التغير. لم ندرب نموذجا؛ لا نستنتج أن إضافة حد أقصى سترفع دقته دائما.
كيف نختار ما نحفظه من اليوم؟
نقترح الاحتفاظ بالقيم الأصلية وتوقيتاتها عند الحاجة، وإرفاق المتوسط بعدد القراءات المقبولة وقاعدة الغياب والوحدة. ويمكن اختيار أصغر قراءة وأكبرها أو غيرهما إذا كان السؤال يقتضيها، مع تعريف ما يحسبه كل ملخص.
إذا أخذنا قراءتين متقاربتين صباحا ولا شيء مساء، فإن وزنيهما المتساويين يصفان هاتين العينتين. لا يمثل الناتج متوسطا زمنيا لكل ساعات اليوم بمجرد إضافة كلمة «يومي». نحتاج سياسة أخذ عينات أو أوزانا ومعنى يناسب السؤال الزمني.
المطلوب ليس حفظ كل ملخص ممكن، بل معرفة التفاصيل اللازمة وعدم ادعاء استرجاع ما حذفناه. نراجع هذه الحدود قبل مقارنة أيام أو دمجها مع بيانات نموذج؛ فقد يتساوى رقم الملخص وتختلف الملاحظات التي أنتجته.
المصادر ومتابعة القراءة
- pandas: Resampler.mean (يفتح في نافذة جديدة)pandas.pydata.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.