
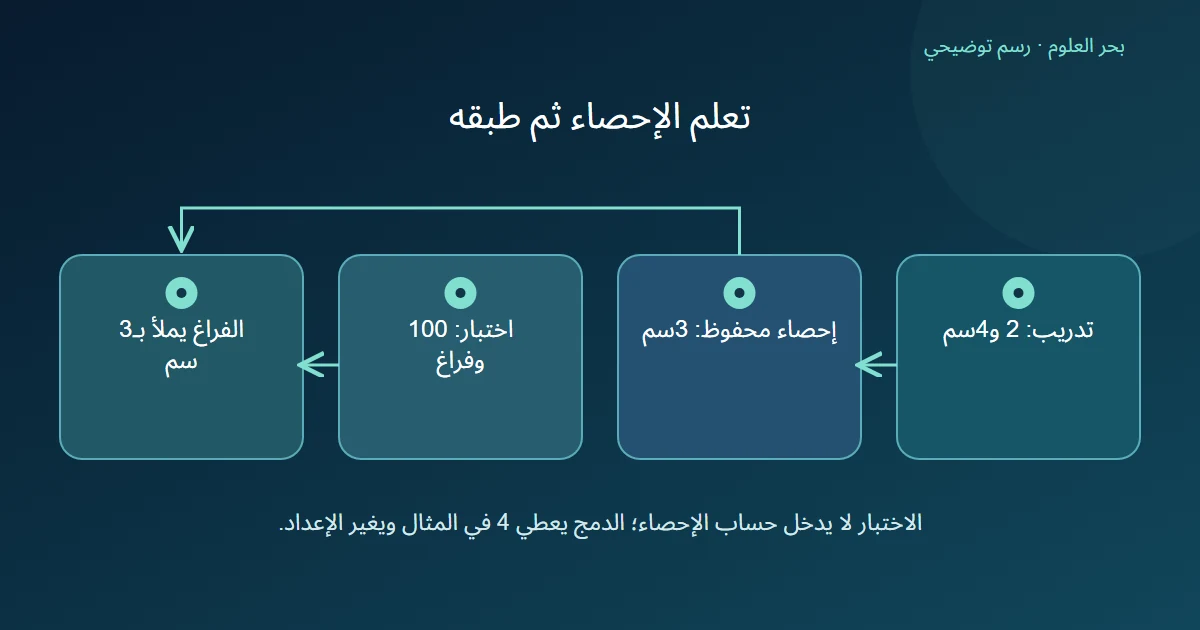
إحصاء التعويض من التدريب فقط يمنع بيانات الاختبار من المشاركة في تحديد طريقة إعداد المدخلات. قد يبدو حساب الوسيط خطوة بسيطة قبل النموذج، لكنه يستفيد من القيم التي ندخلها في الحساب. إذا ضممنا الاختبار، لم يعد إعداد النموذج مستقلا عنه. نشرح ذلك بأرقام افتراضية صغيرة، دون تدريب نموذج أو قياس دقته.
الخلاصة السريعة
افصل بيانات الاختبار، وتعلم إحصاء التعويض من التدريب، ثم طبق الإحصاء نفسه على الاختبار دون إعادة تعلمه منه.
- تتعلم خطوات المعالجة من التدريب وحده؛ تستخدم fit أو fit_transform للتدريب وtransform للاختبار، ويشمل خطر التسرب SimpleImputer. [1]
- في المثال وسيط التدريب 2 و4 هو 3؛ إدخال قيمة الاختبار 100 في الحساب يغير الوسيط إلى4.
- تطبيق قيمة3 على الفراغ في الاختبار يختلف عن إعادة حساب إحصاء مستقل من قيم الاختبار.
- احفظ نسخة الإحصاء ومصدره وحدود مجموعة التدريب؛ لا يثبت فرق الوسيط وحده مقدار تغير دقة نموذج.
ما الذي نتعلمه قبل ملء القيم؟
توصي وثائق scikit-learn بتعلم تحويلات المعالجة من التدريب فقط، واستخدام transform للاختبار دون إشراكه في fit أو fit_transform. وتذكر SimpleImputer ضمن التحويلات المعرضة للتسرب. [1]
نقترح في مثال أطوال قطع خشبية تقسيم السجلات قبل حساب إحصاء الملء. تضم مجموعة التدريب قيمتين معلومتين وقيما غائبة، وتضم مجموعة الاختبار قيمة معلومة وأخرى غائبة. نحتاج أن يبقى الاختبار خارج خطوة تعلم الإحصاء، حتى إذا كان حقل الطول فيه مدخلا لا النتيجة التي سنتوقعها.
الإحصاء المحفوظ جزء من إعداد المهمة: نعرف العمود والوحدة والقيم التي دخلت في حسابه. وجود ملفين بأسماء تدريب واختبار لا يكفي إذا جمعنا قيمهما مجددا لهذه الخطوة.
كيف تغير قيمة اختبار وسيط المثال؟
نفترض أن أطوال التدريب المعروفة هي 2 و4 سنتيمترات، فيكون متوسط القيمتين الوسطيتين3. وفي الاختبار طول معلوم 100 سنتيمتر وطول غائب. إذا جمعنا القيم المعروفة من المجموعتين، صار الترتيب 2 و4 و100، والقيمة الوسطى 4. الأعداد مفترضة والحساب مباشر؛ ليست تجربة على بيانات خشب.
- إدخال 100 غير إحصاء الملء من 3 إلى 4، مع أن قيم التدريب نفسها لم تتغير.
- في السياسة المطلوبة للشرح، نستخدم 3 لملء الطول الغائب في الاختبار، ولا نستخدم 4 المستمدة من دمج المجموعتين.
- لا يتضمن المثال تنبؤات أو نتائج مرجعية أو مقياس أداء؛ لذلك لا نحسب مقدار تضخم الدقة.
| القيم التي تدخل حساب المثال | قيمة الملء | مشاركة الاختبار |
|---|---|---|
| التدريب فقط:2،4 | 3سم | لا |
| التدريب والاختبار:2،4،100 | 4سم | نعم |
هل تطبيق الإحصاء يعني إعادة تعلمه؟
نفصل بين سؤالين: ما القيمة التي حسبناها من التدريب، وأي خانات سنملؤها بها؟ بعد حساب 3 من التدريب نستطيع تطبيقها على الخانات الغائبة في التدريب والاختبار وفق السياسة نفسها. لا يحتاج ذلك إدخال 100 في حساب وسيط جديد.
إذا حسبنا لكل مجموعة وسيطا مستقلا، صار الاختبار يعتمد إعدادا تعلمناه من قيمه. وقد تختلف قيمة الملء بين المجموعتين. لا نصف هذا بأنه تطبيق الإحصاء المحفوظ؛ إنه تعلم إحصاء آخر.
هذا الشرح يخص تقييما يفترض بيانات اختبار منفصلة عن بناء النموذج. لا نجعل إعادة الحساب حيلة لتحسين شكل نتائج التقييم، ولا نستنتج أن أي ترتيب للملفات يمنع التسرب تلقائيا.
ما السجل الذي يجعل الخطوة قابلة للمراجعة؟
نقترح حفظ تعريف التقسيم ونسخة التدريب وإحصاء كل عمود والوحدة وقاعدة الغياب. يراجع صاحب التقييم أن القيمة المحفوظة مستمدة من التدريب المحدد، وأن تطبيقها لا يعيد التعلم من صفوف الاختبار. نربط النسخة المشتقة بإعدادها، كي لا تختلط بتعويض نفذ بسياسة أخرى.
وفرق 3 و4 يثبت أثر إدخال قيمة الاختبار في هذا الحساب فقط. ليس ضمانا أن الوسيط أفضل طريقة لكل بيانات، ولا دليلا على مقدار دقة نموذج لم ندربه. بعد تثبيت الإجراء يمكن تقييمه وفق سؤال مناسب، مع إبقاء أصل القيم المعوضة واضحا.
المصادر ومتابعة القراءة
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.