
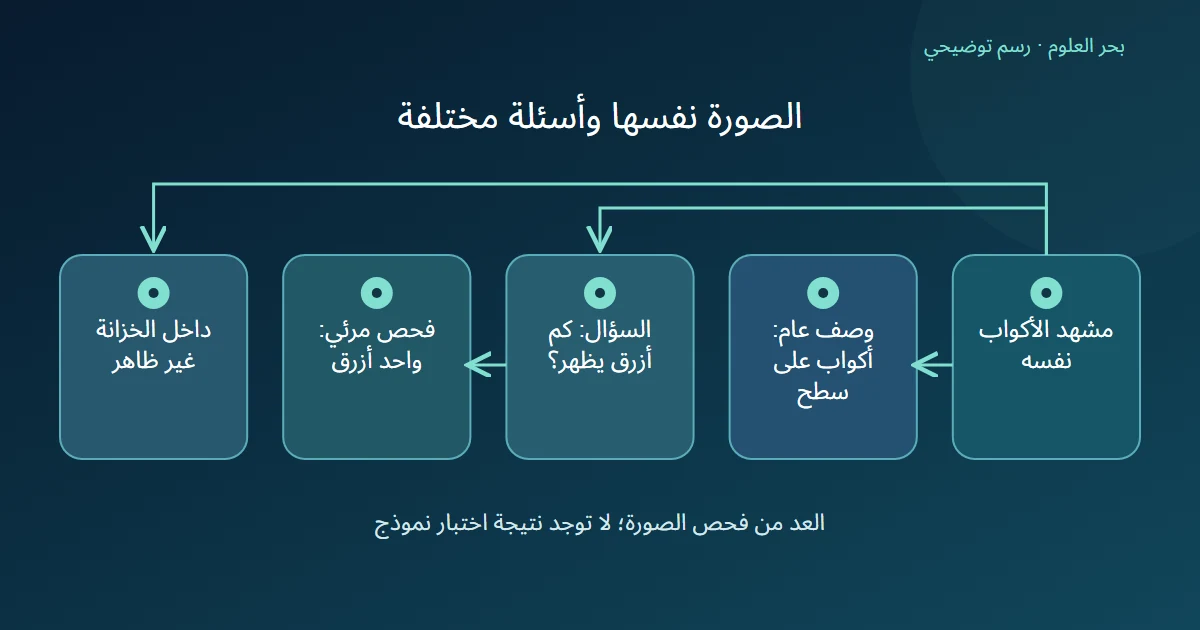
وصف الصورة وسؤال عنها مهمتان متقاربتان في المدخل المرئي، لكنهما لا يطلبان النتيجة نفسها. يعرف Hugging Face وصف الصورة بأنه توقع عبارة تصفها، [1] ويعرف السؤال البصري بأنه جواب يعتمد على الصورة والسؤال. [2] نستخدم مشهدا توضيحيا مولدا لفحص هذا الفرق، دون تجربة نموذج أو إعلان دقته.
الخلاصة السريعة
اختر النتيجة التي تحتاجها: وصف عام للمشهد أم جواب عن تفصيل محدد، ثم تحقق من ذلك التفصيل في الصورة نفسها وأبق ما لا يظهر مجهولا.
- الوصف يقدم عبارة عن الصورة؛ السؤال البصري يضيف سؤالا يحدد ما نريد الإجابة عنه، لا مجرد تسمية عامة للمشهد. [1] [2]
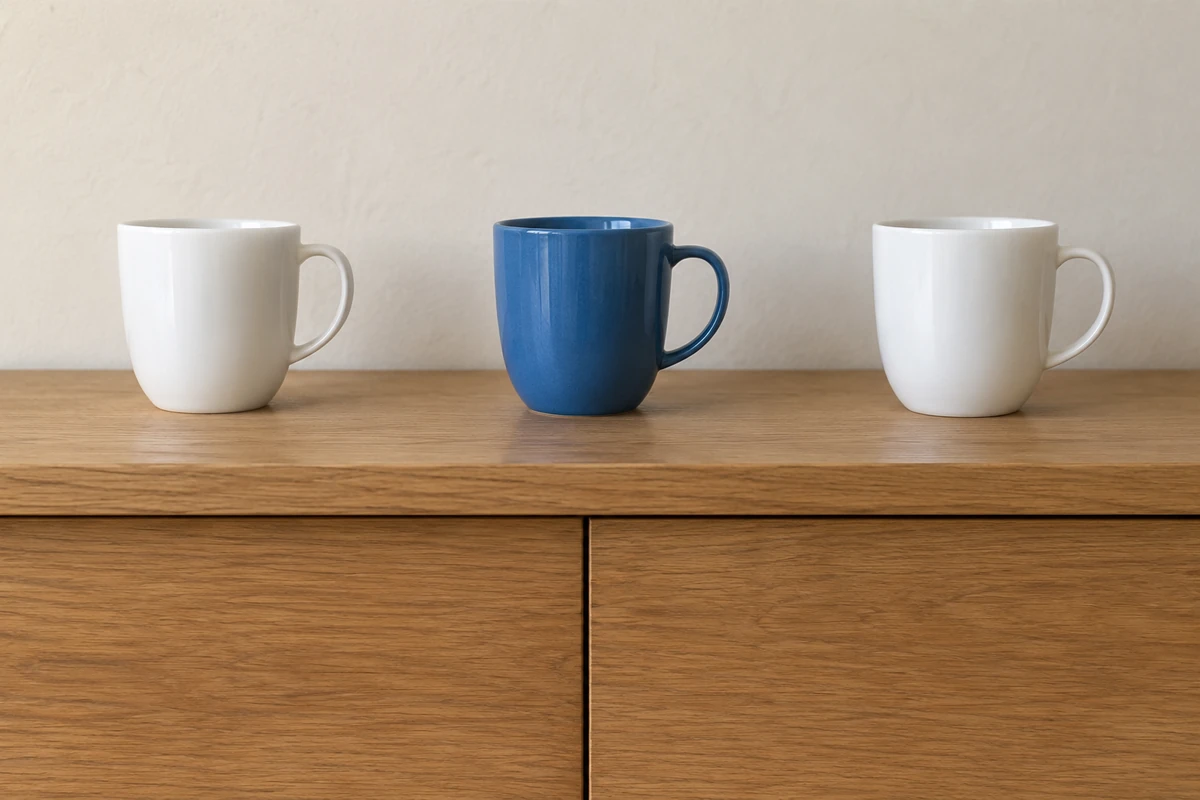
- في الصورة التوضيحية يظهر ثلاثة أكواب على سطح خشبي؛ نراجع عددها مباشرة بدلا من استنتاجه من وصف «أكواب».
- إذا كان السؤال عن الأزرق الظاهر، نجد كوبا أزرق واحدا واثنين أبيضين؛ هذا عد بصري من الصورة، وليس مخرجا لاختبار نموذج.
- بابا الخزانة مغلقان، فلا نعرف محتوياتها من الصورة؛ وصف صحيح لجزء من المشهد لا يثبت كل جواب أو عدد أشياء خارجه.
هل تحتاج وصفا أم جوابا محددا؟
قد يحتاج محرر صفحة وصفا قصيرا لما تعرضه الصورة، وقد يسأل عن عدد أشياء من لون معين. يشرح دليل وصف الصور توليد وصف من الصورة. [1] أما دليل الأسئلة البصرية فيذكر مدخل الصورة والسؤال؛ ويعرض أكثر من طريقة للإجابة، منها اختيار فئة ومنها توليد نص. [2] لا نعطي كل النماذج بنية واحدة.
في تمريننا، الهدف الأول كتابة عبارة عامة عن مشهد الأكواب. الهدف الثاني معرفة عدد الأكواب الزرقاء الظاهرة. نحدد الغرض قبل مراجعة الجواب؛ قد يصف نص عام المشهد دون أن يذكر اللون أو العدد اللذين يحتاجهما سؤال المحرر.
ما الذي يمكننا رؤيته في المشهد؟
أنشئت الصورة المصاحبة بالذكاء الاصطناعي لتوضيح المثال، وليست توثيقا لبيت أو تجربة. فحصناها مباشرة: ثلاثة أكواب متباعدة، واحد أزرق بين اثنين أبيضين، على سطح خشبي فوق خزانة مغلقة. يمكن للقارئ مقارنة هذه المشاهدات بالصورة، دون اعتماد جواب آلي غير موجود.
نقترح وصفا من إعداد المقال: «ثلاثة أكواب، أحدها أزرق، على سطح خشبي». لا نسميه نتيجة نموذج وصف صور، ولا نفترض أن قارئا أو أداة استنتجاه في اختبار. يفصل هذا العرض بين مشهد يمكن عده وبين ادعاء أداء يحتاج تجربة فعلية وشروطا معلنة.
كيف يغير السؤال ما تبحث عنه؟
نسأل «كم كوبا أزرق يظهر في الصورة؟». بالمراجعة المباشرة نجد واحدا. ونسأل «كم كوبا يظهر إجمالا؟» فنجد ثلاثة. جواب السؤال الأول لا يصلح للثاني لمجرد أن الكوب الأزرق جزء من المشهد؛ الصفة المطلوبة تحدد أي أشياء نعد.
ولو قدمت أداة وصفا يقول «أكواب على سطح خشبي»، فهذا لا يحسم سؤال اللون من النص وحده. نعود إلى الصورة أو نطلب المهمة المناسبة ثم نراجع نتيجتها. لم نمرر هذا الملف إلى نموذج للإجابة أو الوصف؛ الأعداد المذكورة ملاحظاتنا على الصورة التوضيحية نفسها.
أي سؤال يتجاوز المرئي؟
نسأل أيضا «كم كوبا داخل الخزانة؟». البابان مغلقان، ولا تعرض الصورة الداخل. لا نحسب الثلاثة الظاهرة جوابا لهذا السؤال، ولا نقول إن الخزانة فارغة لأن شيئا فيها لم يظهر. يحتاج عدد الداخل إلى معلومة أخرى مناسبة، لا إلى توسيع العبارة العامة بثقة.
وحتى وصف الصورة الذي وافق المشهد في جانب واحد لا يثبت جودة جميع الإجابات البصرية. نقترح قبل اعتماد أي جواب تثبيت السؤال ونطاق العد وما يظهر فعلا، والإبقاء على التفاصيل المحجوبة مجهولة. المثال يتيح المقارنة بنفسك؛ لا يقدم قياسا لنموذج أو ضمانا للعد في صور أخرى.
المصادر ومتابعة القراءة
- Hugging Face: Image captioning (يفتح في نافذة جديدة)huggingface.co
- Hugging Face: Visual question answering (يفتح في نافذة جديدة)huggingface.co
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.