
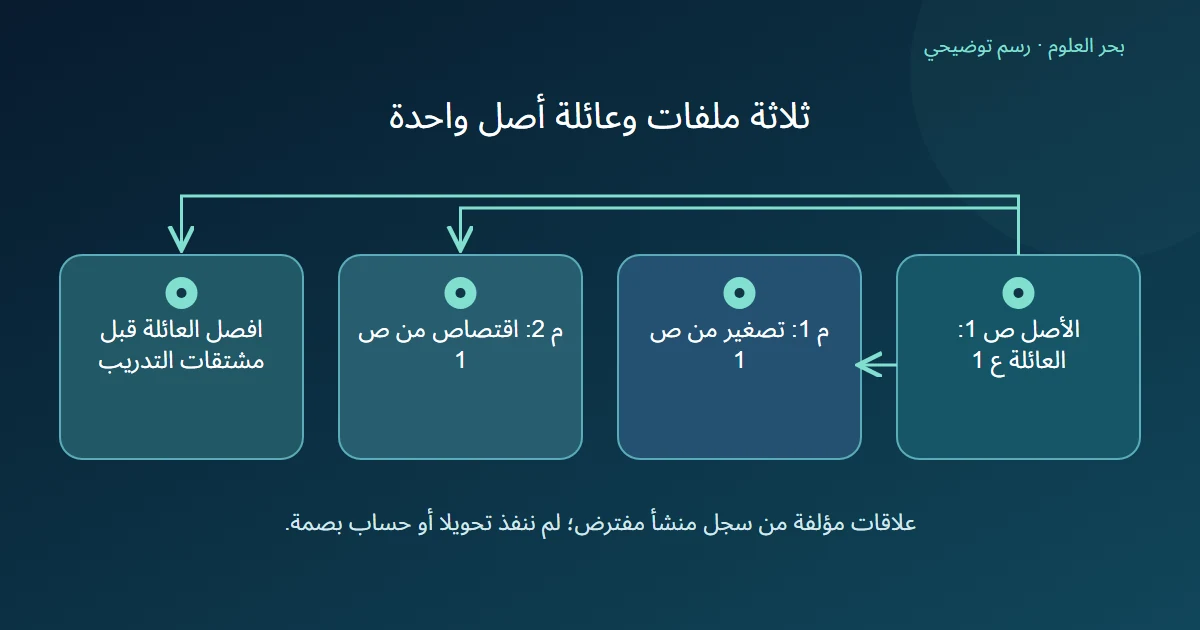
بصمات ملفات الصور وتداخل الأصل يجيبان عن سؤالين مختلفين. قد تختلف ملفات مشتقة من الصورة نفسها، بينما تظل مرتبطة بأصل واحد. لذلك لا يكفي فحص اختلاف بصمات الملفات لإعلان أن الاختبار يقيس صورا من أصول لم تظهر في التدريب.
الخلاصة السريعة
لا؛ اختلاف البصمات يميز البيانات التي حسبت منها، لكنه لا يثبت أن الصور جاءت من أصول مستقلة.
- تصف وثائق hashlib إدخال البايتات وحساب بصمتها. [1] ليست البصمة نفسها سجلا لعلاقة الأصل بالمشتقات.
- نفترض أصل ص 1 وملف تصغير م 1 وملف اقتصاص م 2 ، موثقين كعائلة واحدة. وضع ص 1 في التدريب وم 2 في الاختبار يبقي الأصل مشتركا مهما اختلفت بصمتا الملفين.
- توصي إرشادات زيادة الصور في TensorFlow بتطبيق زيادة البيانات على التدريب فقط. [2] ولغرض اختبار أصل جديد، نفصل عائلات المنشأ قبل إنشاء مشتقات التدريب.
- احفظ معرف الأصل والتحويل وعلاقة الأب بالملف. تشابه الصورة وحده لا يثبت المنشأ، والأصل المختلف لا يضمن وحده استقلال الشيء المصور أو مشهد الفيديو.
ماذا تقارن بصمة الملف؟
توضح وثائق Python أن hashlib يستقبل بيانات بايتات ثم يتيح طلب بصمة البيانات المقدمة إليه. [1]
عند المقارنة نحدد الخوارزمية وما أدخلناه فيها: محتوى الملف كاملا أم جزء منه؟ اختلاف البصمتين عند استخدام الخوارزمية الحتمية نفسها يدل على اختلاف المدخلين، لكنه لا يقول من التقط الصورة أو أي ملف اشتقت منه.
لا ندعي أن كل تعديل يضمن بصمة مختلفة؛ ولا نضع هنا قيما توهم أننا حسبنا بصمات صور فعلية. السؤال المقصود هو حدود الاستنتاج حتى عندما نعلم أن بصمتين مختلفتان، وليس شرح مقاومة التصادم أو سلامة الملفات.
كيف تبقى عائلة الأصل موزعة بين الطرفين؟
نؤلف سجل منشأ للصورة ص 1 ولمشتقين منها. كلمة «تصغير» و«اقتصاص» تصف التحويلين المفترضين، وليست تقرير تنفيذ لمعالجة صورة موجودة. نفرض معرفة العلاقة من سجل منشأ صحيح في المثال.
إذا كانت بصمة ص 1 تختلف عن بصمة م 2 ، فقد نجحنا في تمييز ملفين مختلفين. لكن م 2 يعود إلى ص 1 وفق الفرض، لذلك لا يصلح وصفه بأصل تصوير جديد لمجرد اختلاف البصمة. فصل أسماء الملفات أيضا لا يغير هذه العلاقة.
ولا نفترض أن الاقتصاص يحتفظ بكل عناصر الأصل أو بصلاحية كل تسمية. تلك مراجعة محتوى أخرى. وجود أصل مشترك هنا يكفي لإظهار مخالفة شرط الفصل الذي عرّفناه، دون حساب أداء نموذج أو مقدار تشابه الصور.
| رمز الملف المؤلف | العلاقة المعلنة | معرف العائلة | التوزيع الخاطئ لغرض أصل جديد |
|---|---|---|---|
| ص 1 | صورة الأصل | ع 1 | تدريب |
| م 1 | تصغير من ص 1 | ع 1 | تدريب |
| م 2 | اقتصاص من ص 1 | ع 1 | اختبار |
ما الترتيب الذي يحفظ شرط الأصل الجديد؟
تقول إرشادات TensorFlow إن زيادة البيانات تطبق على مجموعة التدريب فقط. [2]
لغرض المثال نقترح تخصيص كل عائلة أصل إلى طرف واحد، ثم إنشاء مشتقات التدريب من الأصول المخصصة له. إذا كانت المشتقات موجودة سلفا، نراجع روابط آبائها ونخصص العائلة معا، بدلا من فصل كل ملف بمعزل عن أصله.
هذا ترتيب تعليمي لشرط التقييم المحدد. قد تحتاج مهمة أخرى سياسة مختلفة معلنة. ولا نقدم قائمة تحويلات صالحة لكل فئة؛ فالاقتصاص قد يحذف الشيء الذي تحمل الصورة تسميته، وتحتاج ملاءمة التحويل مراجعة مستقلة.
ما التوثيق الذي يعوض غياب البصمة عن وصف المنشأ؟
نقترح حفظ معرف الملف ومعرف الأصل ومعرف الأب المباشر ونوع التحويل ونسخته. تربط هذه المعلومات المشتق بعائلته حتى إذا تغير اسمه أو حفظ بصيغة أخرى، بشرط أن تكون العلاقة موثقة وصحيحة بالفعل.
إذا غاب سجل الأصل، فقد يساعد فحص التشابه في اقتراح ملفات للمراجعة، لكنه لا يقدم وحده تاريخ اشتقاق مؤكدا. لا نخترع علاقة أبوة ولا نحذف الصور على أساس التخمين؛ نوضح حدود الأدلة المتاحة.
وقد تكون صورتان من أصلين مختلفين لشيء واحد أو إطارين متجاورين من مقطع واحد. إذا كان سؤال الاختبار يطلب شيئا أو مشهدا جديدا، نحتاج مستوى تجميع أوسع يناسبه. نجاح فصل عائلة الملف لا يغني عن تحديد وحدة التقييم.
المصادر ومتابعة القراءة
- Python: hashlib (يفتح في نافذة جديدة)docs.python.org
- TensorFlow: Data augmentation (يفتح في نافذة جديدة)tensorflow.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.