
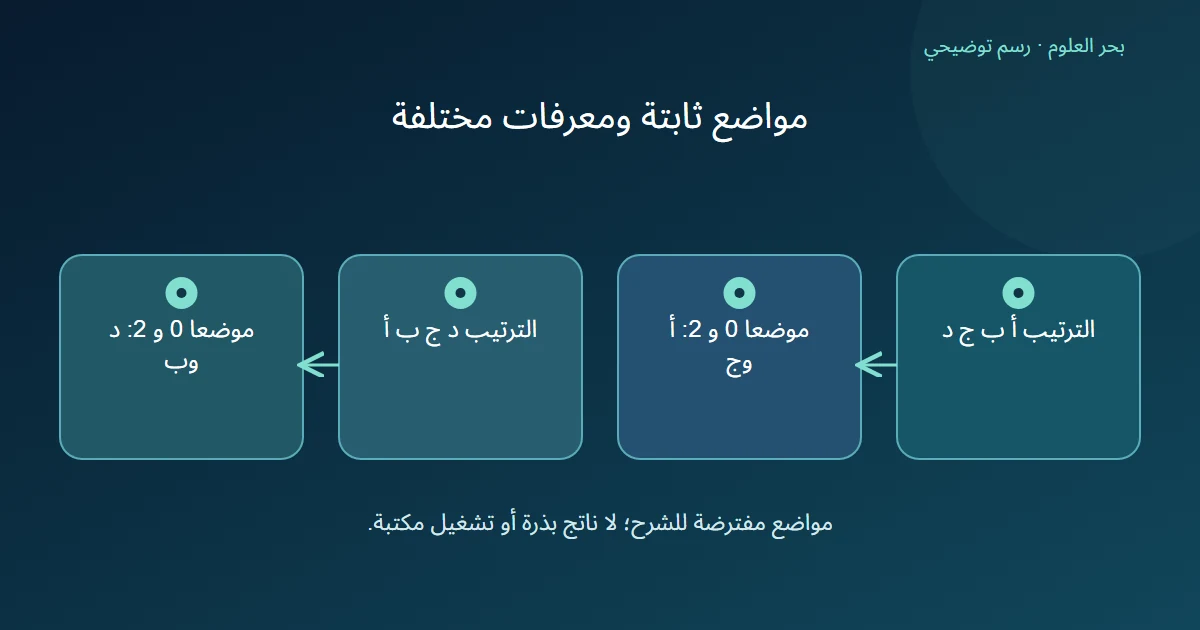
البذرة الثابتة في التقسيم تساعد على إعادة اختيار عشوائي وفق إعداد محدد، لكنها لا تمثل قائمة معرفات سجلات محفوظة. إذا تغير ترتيب صفوف الإدخال، قد تشير المواقع المختارة نفسها إلى سجلات أخرى، رغم ثبات طول القائمة.
الخلاصة السريعة
قد تتغير عضوية السجلات عند تغيير ترتيب الصفوف؛ تثبيت بذرة عددية لا يعوض حفظ المعرفات وترتيب الإدخال وإعداد التقسيم.
- في مصدر ShuffleSplit المقروء يولد الإجراء تبديلا لمواضع العينات، ويختار مواضع الاختبار والتدريب منه. البذرة العددية تضبط هذا الاختيار ضمن الإعداد المحدد. [1]
- نؤلف ترتيبين لأربع معرفات: أ،ب،ج،د ثم د،ج،ب،أ. ونفترض للتوضيح موضعي اختبار 0 و 2 ؛ لا ندعي أنهما ناتج بذرة فعلية.
- الموضعان يعطيان أ وج في الترتيب الأول، ود وب في الثاني. ثبات المواضع وطول الإدخال لا يساوي ثبات السجلات؛ وليس كل تغيير ترتيب مضطرا لتغيير العضوية.
- نحفظ معرفات التقسيم الفعلية وترتيب الإدخال والطريقة والمعاملات والإصدار. لا ندعي إعادة التنفيذ عبر كل الإصدارات أو كل أنواع الحالة العشوائية من رقم بذرة وحده.
ما الذي يعاد اختياره في تنفيذ التقسيم؟
ينشئ ShuffleSplit في المصدر المحدد تبديلا للمواضع حسب عدد العينات، ثم يأخذ مواضع الاختبار والتدريب من أجزاء ذلك التبديل. [1]
نحصر النقاش في تقسيم عشوائي غير طبقي، ببذرة عددية صحيحة، وطول وإعدادات وتنفيذ ثابتة. معرف السجل نفسه ليس ما يقلبه هذا السطر؛ إنه يعمل على مواقع المصفوفة.
نميز تثبيت هذه الشروط عن تمرير كائن حالة عشوائية يتغير استعماله عبر الاستدعاءات، أو تغيير نسخة البرنامج. لا نشرح تلك الحالات هنا ولا نضمنها من المثال.
كيف يشير الموضع نفسه إلى سجل آخر؟
نعرف المواضع من الصفر: أول عنصر موضعه 0 وثالث عنصر موضعه 2. نثبت هذين الموضعين افتراضا لتوضيح علاقة الموقع بالمعرف، دون اختيار بذرة أو تشغيل مولد عشوائي.
في الترتيب الأول يشيران إلى أ وج. بعد عكس ترتيب القائمة يشيران إلى د وب. ظل عدد العناصر أربعة، وظلت المواضع المختارة 0 و 2 ، لكن هوية السجل الموجود عند كل موضع تغيرت.
الجدول ليس توقعا لنتيجة بذرة بعينها ولا مخرجا للمكتبة. إن أردنا معرفة نتيجة إعداد فعلي، نحتاج تشغيله أو فحصه وحفظ العضوية الناتجة؛ لم نفعل ذلك هنا.
| الترتيب المفترض | الموضع 0 | الموضع 2 | سجلا الاختبار المفترضان |
|---|---|---|---|
| أ، ب، ج، د | أ | ج | أ، ج |
| د، ج، ب، أ | د | ب | د، ب |
هل كل إعادة ترتيب تغير الاختبار؟
لا يلزم ذلك؛ قد نبدل سجلين كلاهما داخل المجموعة المختارة، فتظل مجموعة معرفاتها نفسها مع اختلاف ترتيب العرض. وقد نبدل موضعين خارجها فقط. لذلك نستعمل «قد يتغير» ولا نجعل التغير حتميا لأي تبديل.
وإذا بقي ترتيب الإدخال والمعرفات والإعداد والتنفيذ مطابقا ضمن الحالة العددية المذكورة، فإن اعتراض المثال لا ينطبق على إعادة الاستدعاء نفسها. مشكلته أن تغيير المدخل لا يلغي أثره مجرد تثبيت البذرة.
كما لا نستنتج من اختلاف العضوية أن أحد التقسيمين أفضل. نحتاج هدف التقييم وشروطه لمعرفة أثر الانتقال، لا مجرد مقارنة عددية في قائمة صغيرة.
ماذا نحفظ لإعادة الحالات المحجوزة نفسها؟
نقترح حفظ معرفات سجلات التدريب والاختبار الناتجة فعليا، مع ترتيب الإدخال وطريقة التقسيم ومعاملاته وإصدار التنفيذ والبذرة. إذا لم نشغل التقسيم بعد، نكتب أن العضوية مقترحة ولا نسجلها بوصفها ناتجا.
عند تغير البيانات نراجع وجود المعرفات وتطابق تعريف السجل وسياسة التعامل مع صفوف جديدة. قائمة معرفات قديمة تحتاج هذه السياسة، ولا تصبح ضمانا لتكافؤ كل مجموعة بيانات لاحقة.
إذا كان الهدف مقارنة إعدادين على حالات محجوزة واحدة، نفحص المعرفات بدلا من الاكتفاء بمساواة البذرتين. المثال يوضح شرط إعادة العضوية، دون إعادة تدريب أو قياس أداء أو وعد بتطابق تنفيذ عبر كل البيئات.
المصادر ومتابعة القراءة
- scikit-learn 1.9.1: model_selection/_split.py (يفتح في نافذة جديدة)raw.githubusercontent.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.