
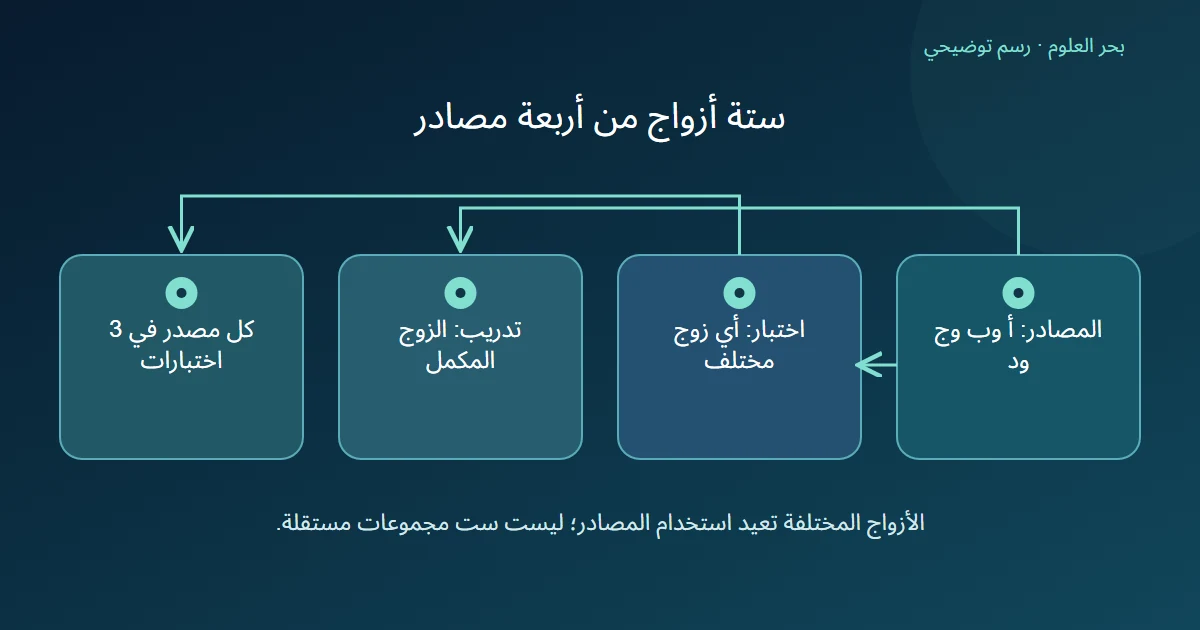
LeavePGroupsOut يحدد مجموعات كاملة نتركها للاختبار، ويكرر الفصل لكل اختيار ممكن بهذا العدد. إذا كانت لدينا أربع مجموعات مصدر وتركنا اثنتين كل مرة، نحصل على ستة اختيارات، لا ست مجموعات بيانات مستقلة.
الخلاصة السريعة
لأن اختيار مجموعتين من أربع يعطي ستة أزواج مختلفة؛ يستخدم كل اختبار الزوج المختار ويستخدم التدريب المجموعتين الباقيتين.
- يوضح دليل scikit-learn أن LeavePGroupsOut يختبر جميع اختيارات العدد P من المجموعات، وقد تتداخل مجموعات الاختبار بين الاختيارات عندما يكون P أكبر من 1. [1]
- نؤلف أربعة مصادر أ وب وج ود، ونترك مصدرين كل مرة. أزواج الاختبار هي أ–ب، أ–ج، أ–د، ب–ج، ب–د، ج–د؛ وكل تدريب هو الزوج المكمل.
- يظهر كل مصدر في الاختبار ثلاث مرات وفي التدريب ثلاث مرات. اختلاف الأزواج لا يجعل التقييمات الستة مستقلة؛ البيانات يعاد استخدامها وفق التصميم، ولا نحسب هنا مقاييس أو تباينا لها.
- نحدد معنى المصدر وعدد المجموعات وسؤال التعميم قبل هذا الاختيار. إذا كانت المجموعات مراحل زمنية، فقد تتضمن بعض الأزواج تدريبا من المستقبل؛ تعداد الأزواج لا يضمن تقييما زمنيا صالحا أو توازن الصفوف والفئات.
ما الوحدة التي نتركها خارج التدريب؟
يصف دليل scikit-learn إجراء LeavePGroupsOut بأنه يترك العدد P من المجموعات للاختبار عبر جميع الاختيارات الممكنة؛ ومع P أكبر من 1 تتداخل مجموعات الاختبار بين بعض الاختيارات. [1]
نؤلف أربعة مصادر مستقلة التعريف نسميها أ وب وج ود، ونعتبر صفوف كل مصدر مجموعة كاملة. كلمة «مصدر» هنا معرف عضوية معلن، وليست برهانا على استقلال إحصائي بين المصادر.
نختار P=2 للمثال. كل فصل يضع جميع صفوف المصدرين المحددين في الاختبار، ويضع صفوف المصدرين الآخرين في التدريب. لا نعطي أحجام الصفوف أو الوسوم، ولا نزعم أننا شغلنا الإجراء على بيانات فعلية.
كيف نعد الأزواج الستة؟
يمكن ربط أ بثلاثة مصادر تليه، ثم ب بالمصدرين ج ود، ثم ج بالمصدر د. نحصل على 3+2+1=6 أزواج، دون عد أ–ب وب–أ اختيارين مختلفين؛ ترتيب الاسمين لا يغير عضوية الاختبار.
يحتفظ كل صف في الجدول بمجموعتين للاختبار وبمجموعتين مكملتين للتدريب. هذا تعداد يدوي لجميع أزواج أربع مجموعات، لا توقع لأرقام الصفوف التي يعيدها استدعاء برمجي أو ترتيبها.
وجود ستة صفوف لا يعني أن لدينا ستة مصادر جديدة. تظهر الأسماء الأربع نفسها مرارا لأن الهدف المعلن هو فحص كل اختيار من مصدرين ضمن هذه المجموعة المحددة.
| مصدرَا الاختبار | مصدرَا التدريب |
|---|---|
| أ وب | ج ود |
| أ وج | ب ود |
| أ ود | ب وج |
| ب وج | أ ود |
| ب ود | أ وج |
| ج ود | أ وب |
لماذا تتكرر المصادر في الاختبار؟
يشارك أ في أ–ب وأ–ج وأ–د، فتكرر ظهوره ثلاث مرات. وينطبق العد نفسه على ب وج ود؛ لكل مصدر ثلاثة شركاء محتملين. وبما أن كل مصدر غائب عن ثلاثة أزواج أخرى، يظهر أيضا في التدريب ثلاث مرات.
هذا التكرار ليس خلطا بين التدريب والاختبار داخل الفصل نفسه: في كل صف لا يوجد مصدر في الجانبين. لكنه يمنع اعتبار الصفوف الستة مجموعات بيانات منفصلة، فقد أعيد استخدام بعض مصادر الاختبار وبعض مصادر التدريب.
ولا نستنتج من التكرار صيغة عامة لتباين مقياس أو درجة اعتماد إحصائي. لم نحسب تنبؤات أو نقارن مقاييس. نميز فقط بين انفصال المصدر داخل فصل واحد وبين إعادة استخدامه عبر فصول متعددة.
ما حدود سؤال التعميم في هذا التصميم؟
نقترح توثيق تعريف المجموعة وعددها الكلي وقيمة P، ثم بيان هل المطلوب تعميم إلى مصدرين من المصادر المحددة أم إلى مصادر مستقبلية غير ممثلة فيها. تعداد الأزواج الستة يجيب عن الحالة الأولى وفق المثال؛ لا يضمن تغطية كل مصدر ممكن في الواقع.
إذا رمزت أ وب وج ود إلى فترات متتابعة، فقد يضع بعض الصفوف فترة متأخرة في التدريب وأخرى سابقة في الاختبار. لذلك لا يتحول هذا التعداد وحده إلى تصميم تنبؤ سببي للمستقبل؛ نراجع الزمن وفق سؤال مختلف قبل اعتماد الفصول.
كذلك لا يساوي ترك مصدرين ترك نصف الصفوف بالضرورة، لأن أحجام المصادر قد تختلف. ولا يثبت تعداد الأزواج توازن الفئات. الجدول يوضح اختيارات المجموعات ومكملاتها وتكرارها، ثم تحتاج ملاءمة هذا التصميم للبيانات قرارا معللا.
المصادر ومتابعة القراءة
- scikit-learn: Cross-validation: evaluating estimator performance (يفتح في نافذة جديدة)scikit-learn.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.