
مولد عشوائي مشترك قد يربط إعدادين ظننا أنهما منفصلان. إذا مررنا كائن الحالة نفسه إلى نموذجين، فقد يستهلك تشغيل الأول حالة سيستعملها الثاني لاحقا. عندها لا يكفي ثبات بيانات الثاني لتجاهل ترتيب الاستدعاءات.
الخلاصة السريعة
نعم، قد يؤثر الاستدعاء السابق لكائن آخر في حالة العشوائية التي يبدأ بها النموذج، إذا اشتركا فعلا في كائن RandomState نفسه.
- توضح وثائق scikit-learn أن استعمال RandomState يستهلك حالته، وأن الكائنات التي تشارك المثيل نفسه تصبح مترابطة من هذه الناحية. [1]
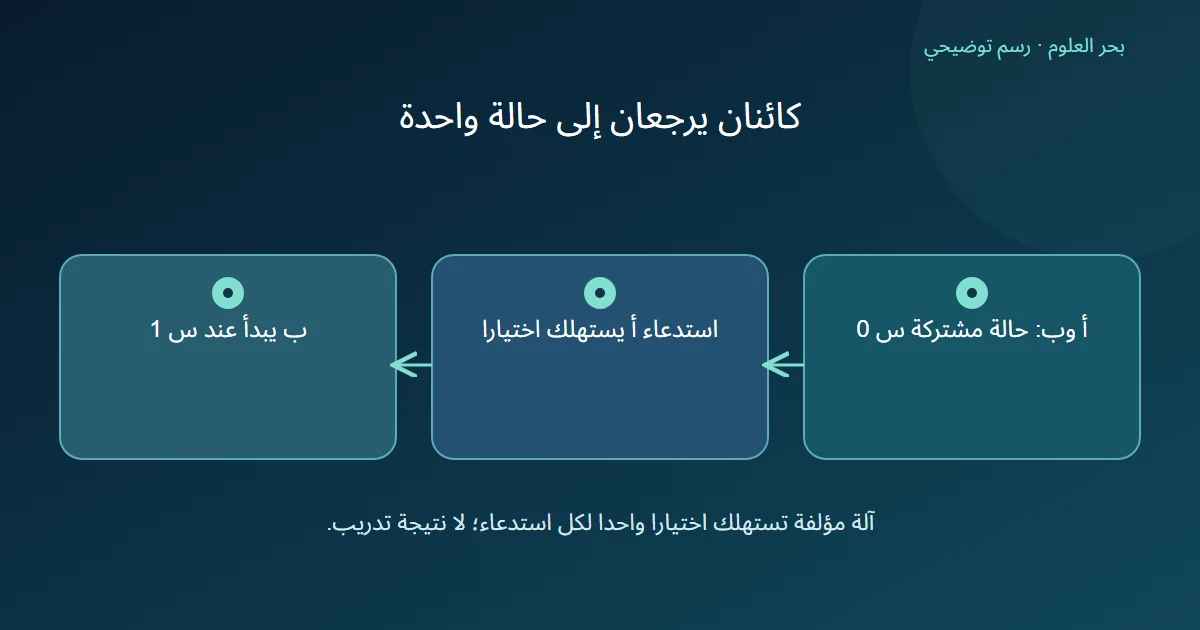
- نؤلف عملية يستهلك فيها كل استدعاء اختيارا واحدا: إذا بدأ أ عند س 0 ثم استدعي ب، بدأ ب عند س 1 ؛ وإذا قدمنا ب بدأ هو عند س 0. ليست هذه مخرجات مولد فعلي.
- مع كائنين منفصلين، لا يقدم استدعاء أ موضع حالة ب في مثالنا. هذا فصل للحالة، وليس إثبات استقلال إحصائي أو اختلاف المخرجات إذا هيئا بالبذرة نفسها.
- نوثق هل الحالة مشتركة وترتيب استهلاكها وما ثبت في المقارنة. تغير نقطة البداية لا يثبت تغير التنبؤ أو تحسن الأداء؛ ولم نشغل نموذجا أو مكتبة.
كيف يرتبط كائنان بحالة واحدة؟
تشرح وثائق scikit-learn أن استدعاء التعلم يستهلك حالة المولد، وأن نموذجين يشتركان في مثيل RandomState نفسه قد يؤثران في عشوائية بعضهما. [1]
نتخيل إعدادين مسميين أ وب، ولهما بياناتهما ومعاملاتهما الثابتة في المقارنة. أعطيناهما مرجعا إلى كائن حالة واحد. الاسمان مختلفان، لكن الحالة التي يرجعان إليها واحدة؛ لا ينشئ اختلاف اسم النموذج حالتين تلقائيا.
السؤال المحدد هو أثر تشغيل أ قبل ب في نقطة البداية المتاحة لب. لا نحكم على جودة أي نموذج أو نعيد تعريف ما دخل بيانات تدريبه.
كيف يظهر أثر ترتيب الاستدعاء؟
نؤلف آلة تعليمية لها مواضع حالة س 0 ثم س 1 ثم س 2. كل استدعاء يستهلك اختيارا واحدا فقط وينقل الموضع خطوة. هذه فرضية لتتبع المشاركة، وليست وصفا لعدد الاختيارات الذي تستهلكه خوارزمية تعلم حقيقية.
في السطر الأول يستعمل أ نقطة البداية س 0 ، ثم يبقى لب الموضع س 1. في السطر الثاني نعكس ترتيب الاستدعاء من نقطة البداية نفسها، فيحصل ب على س 0 وأ على س 1. لا توجد قيم تنبؤ أو معاملات مدربة في الجدول.
قد تختلف كمية الاستهلاك في تنفيذ فعلي. لذلك لا ننقل رمز س 1 إلى تقرير بوصفه حالة عددية سجلناها؛ إنه اسم تعليمي يوضح أن كائنا آخر تقدم بالحالة قبل الوصول إلى ب.
| ترتيب المثال | بدء أ | بدء ب |
|---|---|---|
| أ ثم ب، بحالة مشتركة | س 0 | س 1 |
| ب ثم أ، بحالة مشتركة | س 1 | س 0 |
| أ ثم ب، بحالتين منفصلتين | س 0 الخاصة بأ | س 0 الخاصة بب |
ماذا تفصل الحالة الخاصة بكل كائن؟
في السطر الثالث نفترض كائنين منفصلين، كلاهما مهيأ عند بداية سميناها س 0. استدعاء أ يقدم حالته الخاصة، لكنه لا يقدم حالة ب، فيبقى ب عند بدايته حتى يستدعى.
هذا لا يضمن استقلال الاختيارات إحصائيا. إذا بدأ الكائنان بالتهيئة نفسها، فقد ينتجان تسلسلين متطابقين في مسار محدد؛ فصل موضع الحالة عن الآخر يجيب سؤال المشاركة فقط.
ولا يضمن الجدول اختلاف نتيجة ب بين أول سطرين. قد تؤدي اختيارات مختلفة إلى التنبؤ نفسه، أو قد لا يؤثر الجزء العشوائي في المخرج الذي ننظر إليه. فصل الحالة عن النتيجة يمنع تحويل تتبع التنفيذ إلى حكم أداء بلا قياس.
ماذا نراجع عند مقارنة إعدادين؟
نقترح حفظ طريقة إنشاء الحالة، وهل أعطيت مرجعا مشتركا إلى كائنات أخرى، وترتيب الاستدعاءات التي استعملتها. نحدد أيضا بيانات ب وإعداداته، حتى لا ننسب تغيرا إلى سبب واحد مع تغير عدة عناصر.
إذا أردنا مقارنة ب قبل تشغيل أ وبعده، نكتب هذا السؤال صراحة ونفحص الحالة والتنفيذ الفعلي عند إجراء المقارنة. مجرد رؤية الاسم نفسه في سجلين لا يثبت أن الحالة بدأت عند الموضع نفسه.
لم نشغل هذا الترتيب أو نقس فروق نتائج. يبين المثال كيف يمكن لاستدعاء كائن آخر أن يغير نقطة البداية المشتركة، وما الذي تحتاجه مراجعة مقارنة تريد عزل هذا الأثر.
المصادر ومتابعة القراءة
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.