
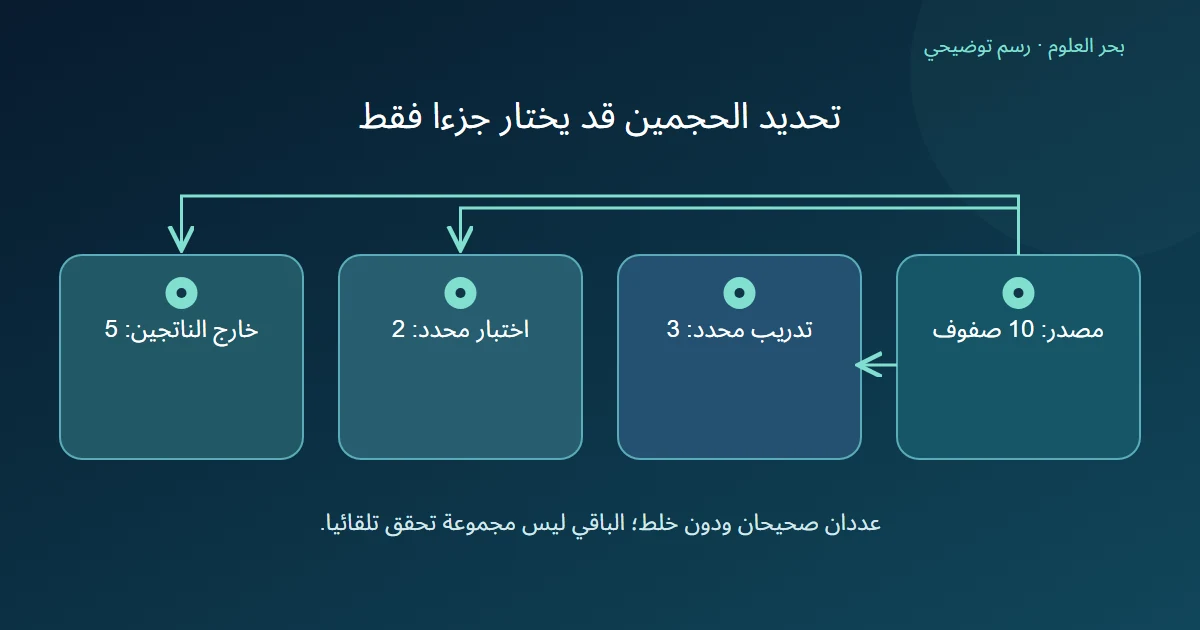
تحديد حجمي التدريب والاختبار صراحة قد يختار جزءا من البيانات بدلا من توزيعها كلها. في train_test_split لا نفترض أن غياب صف من التدريب يجعله تلقائيا في الاختبار؛ نراجع كيف حدد الحجمين وما الذي أعاده التقسيم.
الخلاصة السريعة
لا؛ عندما نحدد حجمي التدريب والاختبار بأعداد صحيحة ومجموعهما أقل من عدد الصفوف، قد تبقى صفوف خارج الناتجين.
- في تنفيذ scikit-learn المحدد هنا يكمل الحجم غير المحدد الباقي، بينما يقبل تحديد حجمين صحيحين مجموعهما أصغر من عدد العينات. [1]
- نؤلف 10 صفوف مرتبة، مع shuffle=False وstratify=None. عند train_size=3 وtest_size=2 يكون التدريب 1–3 والاختبار 4–5 ، وتبقى 6–10 خارج الناتجين.
- إذا تركنا train_size=None مع test_size=2 ، يصبح التدريب 1–8 والاختبار 9–10. تغيرت عضوية الاختبار أيضا، لا عدد التدريب وحده. الاشتقاق يدوي من التنفيذ، دون استدعاء المكتبة.
- الصفوف غير المسندة لا تصبح مجموعة تحقق تلقائيا ولا تحذف من المصدر. نحفظ الأعداد والمعرفات وسياسة استعمال الباقي، ولا نعمم مواضع المثال عند تشغيل الخلط.
متى يحسب الحجم بوصفه الباقي؟
يحسب تنفيذ الإصدار 1.9.1 الحجم غير المحدد من عدد العينات ناقص الحجم الآخر، ويمنع مجموع حجمين أكبر من البيانات؛ لا يشترط مساواة المجموع للحجم الكلي عند تحديدهما معا. [1]
نحصر المثال في عددين صحيحين، لا نسب كسرية تحتاج تقريب الأعداد. ولدينا 10 صفوف سميناها 1 إلى 10 حسب ترتيب الإدخال، مع تعطيل الخلط وعدم التقسيم الطبقي.
نراجع هذا السلوك في نسخة المصدر المثبتة، دون ضمان بقاء كل تفصيل ثابتا عبر أي إصدار مستقبلي. الغرض تفسير إعداد محدد يمكن للقارئ تتبع حسابه.
أين تذهب الصفوف عند تحديد ثلاثة واثنين؟
عندما نعطل الخلط، ينشئ التنفيذ مواقع التدريب أولا ثم مواقع الاختبار التالية وفق الحجمين. [1]
لذلك نعطي التدريب الصفوف الثلاثة الأولى والاختبار الصفين التاليين في السطر الأول. مجموع الناتجين 5 ، وتبقى 5 من المصدر خارج هذا الاختيار. تدريب واختبار غير متداخلين لا يعني هنا أنهما غطيا المصدر كله.
لم نشغل train_test_split، ولم نعلن الناتج من تجربة. اشتققنا الجدول من الفروع المقروءة في المصدر، وتحققنا حسابيا من أعداد الصفوف وحدودها المعلنة.
| الإعداد مع 10 صفوف ودون خلط | التدريب | الاختبار | خارج الناتجين |
|---|---|---|---|
| تدريب 3، اختبار 2 | 1 إلى 3 | 4 و 5 | 6 إلى 10 |
| تدريب غير محدد، اختبار 2 | 1 إلى 8 | 9 و 10 | لا صفوف |
ما الذي يتغير إذا تركنا التدريب غير محدد؟
في السطر الثاني يكمل حجم التدريب الباقي:10−2=8. مع ترتيب الصفوف نفسه وعدم الخلط، يأخذ التدريب 1 إلى 8 ويبدأ الاختبار بعده، فيكون 9 و 10.
إذن لا يصح وصف التعديل بأنه «إضافة خمسة صفوف للتدريب مع الاختبار نفسه». تحركت حدود الاختبار في مثالنا؛ يلزم فحص المعرفات الفعلية قبل مقارنة إعدادين على أساس أنهما يستعملان الحالات المحجوزة نفسها.
ولا نعمم أسماء الصفوف هذه إذا تغير ترتيب الإدخال أو فعلنا الخلط. تبين الأسماء نتيجة المثال المرتب تحديدا، لا وعدا بمواضع ثابتة لكل إعداد.
كيف نعامل الجزء غير المسند؟
غياب 6 إلى 10 من الناتجين في السطر الأول لا يجعلها مجموعة تحقق أنشأها الإجراء. إذا أردنا دورا إضافيا، نحدده ونحفظ عضويته وسياسة استعماله صراحة، مع مراجعة فصل المعلومات حسب السؤال.
كذلك لا يعني التقسيم حذف الصفوف من المصدر الأصلي. نتحدث عن عضوية الناتجين؛ لا نجري عملية حذف أو نغير ملفا في المثال. يحفظ هذا التفريق معنى عبارة «غير مستخدم هنا».
نقترح تقريرا يذكر حجم المصدر وحجمي الناتجين وعدد الصفوف خارج كليهما ومعرفاتها، ثم سبب اختيار الجزء. لا يكفي أن تظهر مجموعتان باسم تدريب واختبار لاستنتاج تغطية جميع البيانات أو جودة التقييم.
المصادر ومتابعة القراءة
- scikit-learn 1.9.1: model_selection/_split.py (يفتح في نافذة جديدة)raw.githubusercontent.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.