
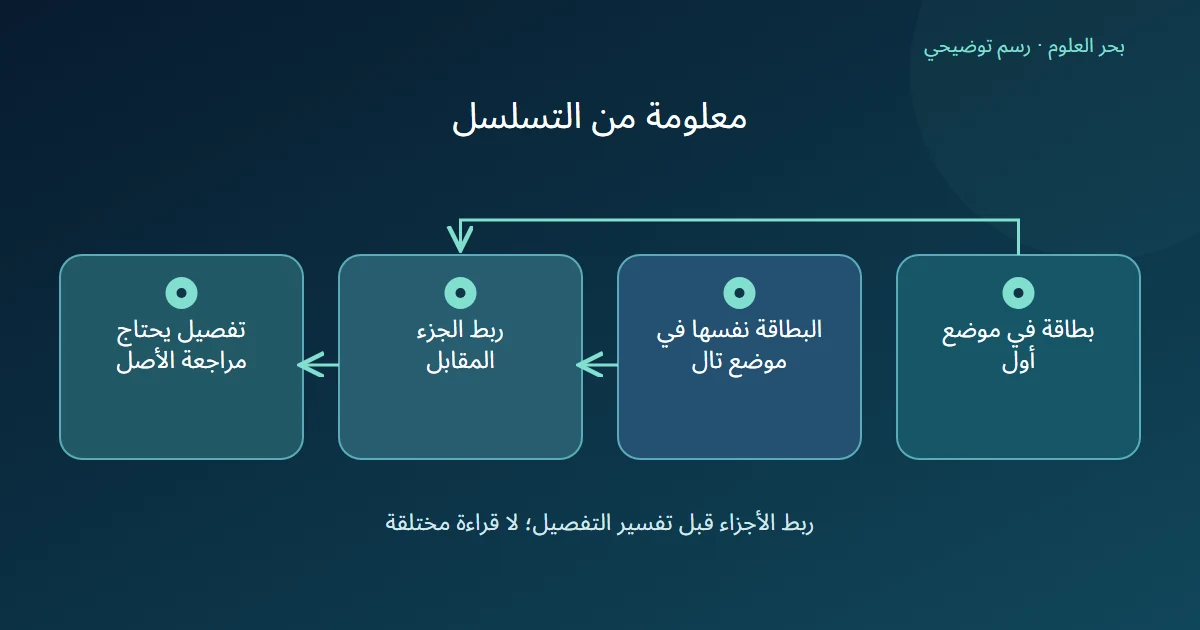
رفع دقة الفيديو باستخدام الإطارات المجاورة يختلف عن تكبير صور مستقلة. السؤال المفيد قبل اختيار المسار هو: هل تتعامل الأداة مع تسلسل، أم تستقبل كل إطار وحده؟ نوضح الفرق بمثال مكتوب لبطاقة تتحرك على طاولة، دون تشغيل نموذج أو تقديم تفاصيل محسنة بوصفها قراءة موثقة.
الخلاصة السريعة
قد تجمع طريقة رفع دقة الفيديو معلومات من عدة إطارات مرتبطة؛ لكن زيادة حجم الناتج أو وضوحه لا تثبت وحدها استعادة تفاصيل الأصل.
- توضح دراسة BasicVSR فرق الصورة المنفردة عن جمع معلومات من إطارات مترابطة وغير متطابقة مكانيا. [1] لا تنسب هذا المسار تلقائيا إلى كل أداة تحسين.
- في مثال البطاقة تتحرك الحافة عبر الصور؛ قارن مواضع الجزء نفسه، ولا تجمع بكسلات الإحداثية نفسها كأنها تخص العنصر نفسه.
- ظهور جزء في إطار مجاور قد يضيف مشاهدة له؛ أما كتابة حرف لم يتضح في أي مدخل فلا تصبح نقلا مؤكدا لأن الناتج مقنع.
- احفظ تسلسل المصدر وحدود الأجزاء المرئية، وافحص التفصيل المطلوب على المرجع المناسب؛ لم ننفذ تحسين فيديو أو اختبارا لدقته.
ما الذي يضيفه الزمن إلى مهمة رفع الدقة؟
تشرح دراسة BasicVSR أن رفع دقة الفيديو يجمع معلومات من إطارات مترابطة قد تكون غير متحاذية. وتقسم الوظائف إلى نقل المعلومات زمنيا، والمحاذاة، والجمع، ورفع الدقة. [1]
نقرأ اسم المهمة قبل الحكم على أداة. برنامج يكبر كل صورة منفردة قد يخرج ملف فيديو أكبر أيضا؛ اسم الناتج وحده لا يبين أنه استفاد من الصور السابقة واللاحقة. اسأل عن المدخل الفعلي والطريقة الموثقة بدلا من افتراض أن كلمة «فيديو» تصف علاقة بين الإطارات.
ولا نستنتج من تعريف الدراسة أن كل تطبيق حديث يستعمل بنيتها أو ينتج النتيجة نفسها. نأخذ منها تمييزا محددا بين مصدر معلومات مكاني منفرد ومصدر يمتد عبر التسلسل.
لماذا لا نجمع الموضع نفسه بلا تحقق؟
نؤلف ثلاث صور متتابعة للبطاقة نفسها. تنتقل حافتها من يسار الصورة إلى وسطها، بينما يبقى خلفها سطح الطاولة. عند إحداثية ثابتة قد نرى البطاقة أولا ثم الطاولة لاحقا؛ هذه ليست ثلاث مشاهدات للجزء نفسه.
إذا أردنا قراءة علامة قرب الحافة، نبحث عن موضع العلامة على البطاقة في كل صورة مناسبة. هذا يشرح الحاجة إلى ربط الأجزاء المقابلة، ولا يقدم خوارزمية محاذاة نفذناها. كما لا يحول بطاقتين متشابهتين من تسجيلين مختلفين إلى مشاهدات للبطاقة نفسها.
قد تتغير زاوية البطاقة أو يحجبها إصبع. نسجل هذا الفرق في المثال بدلا من إكمال جدول المشاهدات بقراءة لم تظهر.
هل تفاصيل الناتج شهادة على الأصل؟
نفترض أن جزءا من العلامة واضح في الصورة الثانية وحجب في الأولى. وجود الصورة الثانية يختلف عن غياب الجزء في جميع الصور المتاحة؛ لدينا في الحالة الأولى مشاهدة إضافية يمكن الرجوع إليها.
لكن لو كان الحرف الدقيق غير مقروء في المدخلات، لا نسمي حرفا مقترحا في الناتج نسخة مؤكدة منه. المسار الذي يستعمل الجيران لا يعفي من مراجعة القراءة المطلوبة. ولا يعني هذا أن كل تحسين عديم الفائدة؛ فالفائدة في العرض تختلف عن إثبات شكل حرف في الأصل.
كيف تسجل مراجعة محددة؟
احتفظ بترتيب صور البطاقة ونسخة الملف وأي جزء ظهر فعلا. حدد هل تريد تسهيل العرض أم قراءة العلامة حرفيا، ثم قارن الجزء المعني بالمصدر المناسب إذا نفذت معالجة لاحقا.
يمكن كتابة «أصبحت الحافة أسهل تمييزا» مع بيان ما تمت مراجعته. لا تضف «عادت كل التفاصيل» أو نسبة دقة لم تقسها. المثال هنا يفسر دور المعلومات الزمنية وحدود نسبتها إلى الأصل؛ لم ننتج فيديو محسنا أو نشاهد مخرجات نموذج.
المصادر ومتابعة القراءة
- BasicVSR: The Search for Essential Components in Video Super-Resolution and Beyond, CVPR2021 (يفتح في نافذة جديدة)openaccess.thecvf.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.