
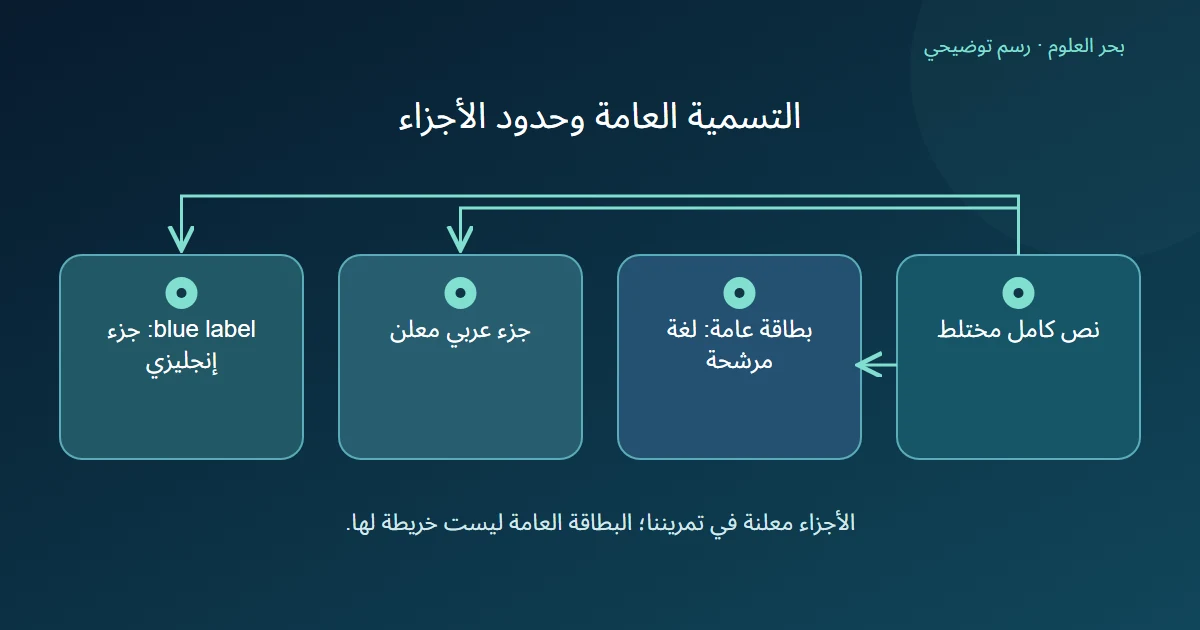
إذا عرض المساعد بطاقة تقول «لغة النص: العربية»، فلا نستنتج أن كل كلمة في المادة عربية. قد يكون الناتج تصنيفا واحدا لمدخل يحتوي أجزاء من لغات مختلفة. نراجع وصف fastText للنموذج والمدخل، ثم نؤلف بطاقة نتيجة لا نزعم أنها خرج تجربة، لنفصل تسمية النص من خريطة أجزائه.
الخلاصة السريعة
لا؛ بطاقة لغة عامة لا تحدد لغة كل جزء أو موقعه. سجل النص الذي صنف، وافصل المرشحين له عن نتائج تحليل أجزاء ترسلها مستقلة.
- تصف fastText نماذج تحديد لغة تتوقع UTF-8، وتصف predict بإرجاع مرشح واحد افتراضيا لنص معين أو عدة مرشحين عند تحديد k. [1] [2]
- في نصنا «وصلت الورقة، والبطاقة تحمل blue label» نعلن كلمتين إنجليزيتين؛ بطاقة عامة مفترضة باسم العربية لا تغير هذا التصريح ولا تصبح ترجمة لهما.
- قائمة ثلاثة مرشحين للنص كله ليست ثلاثة أجزاء ولا ثلاثة مواضع لغوية؛ تحتاج خريطة الأجزاء حدودا تربط كل حكم بمادته.
- افصل تعريف الأجزاء ونتائجها من التسمية العامة، واحفظ النص والإعدادات؛ المرشح ليس ضمانا للدقة أو نسبة كلمات اللغة، ولم نشغل نموذج كشف.
ما نطاق الناتج الموصوف؟
تصف صفحة fastText نماذج لتحديد اللغة تتوقع نص UTF-8. وتبين وثيقة Python أن predict يصنف نصا معينا، ويعيد مرشحا واحدا افتراضيا، ويمكن طلب مرشحين أكثر بمعلمة k. [1] [2]
نحصر الكلام في دور النتيجة، ولا نقارن دقة نماذج أو نحسب دعما للعربية من مثالنا. نحتاج معرفة المدخل الذي حمل هذه النتيجة: جملة كاملة أم فقرة أو جزء حددناه. الرقم بجانب تسمية لا يرسم حدود الكلمات تلقائيا.
هل التسمية العامة تغير النص المختلط؟
نكتب «وصلت الورقة، والبطاقة تحمل blue label»، ونعلن أن blue label عبارة إنجليزية في تمريننا. ثم نضع بطاقة مفترضة تلخص المدخل كله باسم «العربية». لم نطلب من fastText إنتاجها ولا نعرف ماذا سيتوقع لو شغلناه.
هذه البطاقة لا تلغي الجزء الإنجليزي الذي أعلناه، ولا تخبرنا أين بدأ أو انتهى. كذلك لا تحول blue label إلى ترجمة عربية أو تثبت أن كل حروف لاتينية في أي نص كلمات إنجليزية؛ في حالات أخرى قد تكون أسماء أو رموزا تحتاج مادتها وسياقها.
هل المزيد من المرشحين خريطة أجزاء؟
في ورقة منفصلة نعلن نتيجة للنص نفسه تحمل ثلاثة مرشحين مرتبين، دون حدود أو مواضع. عدد المرشحين هنا عدد تسميات نقارنها على المدخل؛ لا يعني أن المدخل انقسم إلى ثلاثة أجزاء، ولا أن الأول يخص أول كلمة والثاني التالية.
ولو أردنا خريطة للجزء العربي والعبارة الإنجليزية في تمريننا، نحتاج تعريف حدود كل منهما وربط الحكم به. إرسال أجزاء مستقلة يقدم أسئلة أخرى قد تحتاج مراجعة نتائجها؛ لا نضمن أن التقسيم يحسن الدقة في كل نص، ولا ننقل تسمية المدخل الكامل إلى كل جزء منه.
ماذا نحفظ قبل استعمال نتيجة الكشف؟
نقترح حفظ النص الأصلي، والنموذج وطريقة تعريف المدخل، وعدد المرشحين المطلوب ومعنى الأعداد المصاحبة وفق المرجع الفعلي. لا نسمي احتمالا في بطاقة نسبة الكلمات المكتوبة بلغة معينة دون طريقة تثبت ذلك الحساب.
وعندما يعتمد عمل لاحق على لغة جزء بعينه، نراجع مادته وحدوده ودليل الحكم بدلا من الاكتفاء بتسمية عامة. لم نستدع نموذجا أو نقارن لهجات أو نفحص صوتا؛ المثال يوضح اختلاف نطاق التصنيف من تغطية أجزاء النص، مع بقاء المحتوى والنتيجة المفترضة منفصلين.
المصادر ومتابعة القراءة
- fastText Language identification: نماذج اللغة والمدخل (يفتح في نافذة جديدة)fasttext.cc
- fastText Python: predict للنص وعدد المرشحين (يفتح في نافذة جديدة)fasttext.cc
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.