
التقييم المتتابع مع تأخر الوسم يفصل سؤال التنبؤ من موعد وصول الحقيقة. يعرض River مسارا من أسئلة وأجوبة بحسب وقت الوصول، مع delay لتأخير كشف الهدف. [1] نؤلف متعلما صغيرا لنعرف أي تنبؤ نقارن، دون تشغيل مكتبة أو تدريب نموذج فعلي.
الخلاصة السريعة
في العقد الذي نراجعه نتنبأ قبل التعلم من جواب الحالة؛ إذا تأخر جوابها نحفظ التنبؤ الأول، ثم نقيمه عند ظهور الوسم بدلا من استبداله بتنبؤ جديد.
- تعرض صفحة River تأخير كشف الهدف. [1] وتحفظ الشيفرة المقروءة التنبؤ، ثم تحدث المقياس عند الجواب قبل التعلم منه في المسار المتأخر. [2]
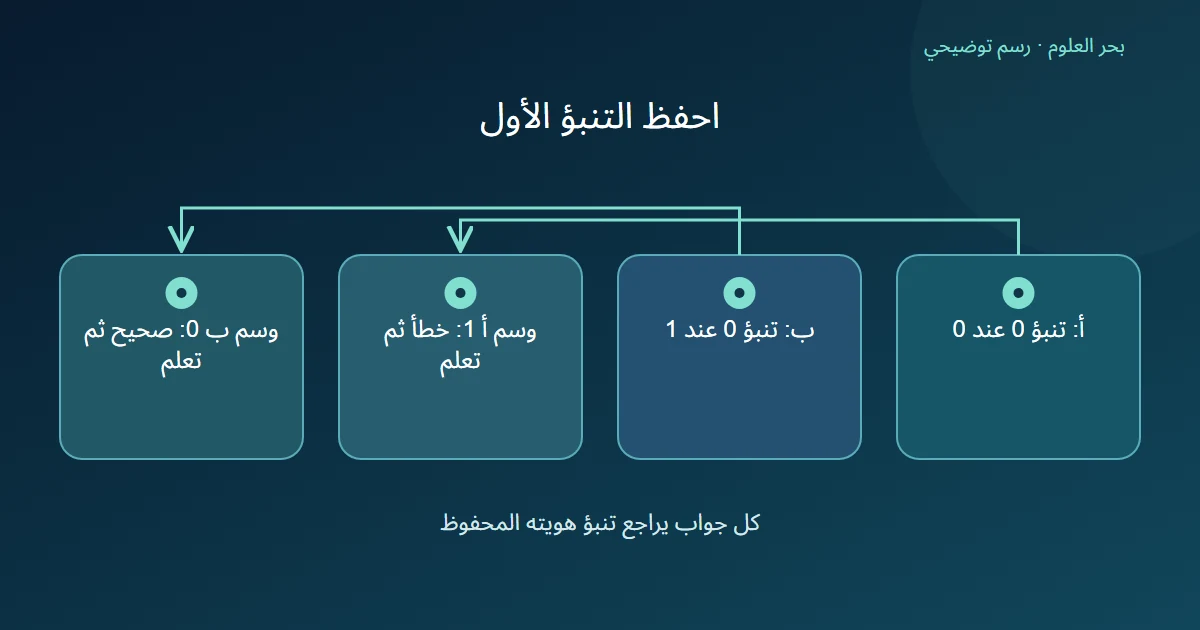
- في متعلمنا المعلن تبدأ الحالة بصفر وتصبح آخر وسم تعلمه؛ أ تصل عند صفر وب عند واحد، وتنبؤ كل منهما صفر قبل ظهور وسميهما.
- عند 3 يظهر وسم أ بقيمة 1، فيخطئ تنبؤها المحفوظ ثم تصبح حالة المتعلم 1؛ عند 4 يظهر وسم ب بقيمة 0، فيصيب تنبؤها المحفوظ ثم تعود الحالة إلى صفر.
- إعادة تنبؤ ب بالحالة 1 قبل التعلم من وسمها تعطي 1، لكنها ليست قرارها القديم صفر؛ احفظ الهوية والتنبؤ ووقت الكشف ولا تفترض طريقة حسم أحداث متزامنة لم نعلنها.
متى نختبر ومتى نحدث المتعلم؟
يستعمل progressive_val_score أسئلة وأجوبة مرتبة بالوصول، ويكشف الهدف بعد مدة delay؛ دون تأخير يعالج الملاحظات تباعا. [1]
في الشيفرة الحالية يحفظ المسار المتأخر تنبؤ السؤال، ثم يستعيده عند جواب الحالة لتحديث المقياس قبل تعلم ذلك الجواب. [2]
نضيق المثال إلى تعلم بإشراف ووسم صحيح معلوم عند موعده. لا نطبق ترتيبنا على تحديث غير خاضع للإشراف أو نقول إن وجود خيار تأخير يمنع كل تسرب في كل تطبيق. ما سنراجعه دفتر تنبؤات وحالات أعلنّاها.
ما قاعدة المتعلم والأوقات في الورقة؟
نؤلف متعلما يحتفظ بعدد واحد. يبدأ بصفر، ويتنبأ دائما بعدده الحالي، وعند تعلم وسم يصبح عدده ذلك الوسم. يتجاهل الخصائص في هذا التمرين البسيط؛ ليست هذه وصفة لتصنيف عملي أو دالة River استدعيناها.
نعلن أ تصل عند الوقت صفر، ووسمها 1 يظهر عند 3. وب تصل عند 1، ووسمها 0 يظهر عند 4. الأوقات على مرجع واحد بوحدة مجردة، ولا يوجد تعادل زمني في هذه القائمة.
قبل 3 لم يظهر أي وسم؛ لذلك تنبؤ أ عند صفر وتنبؤ ب عند واحد كلاهما صفر. نحفظ العدد تحت هوية الحالة، ولا نتعلم من قيمتين نعرفهما نحن في نهاية تصميم المثال قبل ظهورهما للمتعلم.
كيف يتغير الحكم والحالة عند الأجوبة؟
عند 3 نراجع تنبؤ أ المحفوظ، وهو صفر، أمام وسمها 1. هو خطأ في ورقتنا. بعد هذه المراجعة نتعلم 1، فتصبح الحالة 1. تغير الحالة الآن لا يعيد كتابة تنبؤ أ الذي صدر سابقا.
عند 4 نراجع تنبؤ ب المحفوظ صفر أمام وسمها صفر؛ هو صحيح. بعد ذلك نتعلم وسم ب، فتصبح الحالة صفرا. الصحيح واحد من حالتين تحت دفترنا ومعيار التطابق الذي اخترناه.
ولو أخذنا الحالة الحالية 1 قبل تحديث ب وطلبنا منها جواب ب جديدا، لأعادت 1. سيكون خاطئا أمام صفر، لكن هذا لا يجعل تنبؤ ب القديم خاطئا. اختلف موعد القرار وحالة المتعلم التي أصدرته.
ما الدفتر الذي يمنع استبدال القرار القديم؟
نقترح حفظ هوية كل حالة وتنبؤها الأول ووقت السؤال ووقت كشف الوسم ونسخة حالة المتعلم. عند وصول الجواب، نطابقه مع التنبؤ المحفوظ للحالة نفسها؛ لا نسأل نسخة لاحقة ثم نسميها نتيجة قديمة.
الأحداث المتزامنة قد تحتاج قاعدة مستقلة تحدد أي كشف أو سؤال يسبق الآخر. تعمدنا أن تكون الأوقات مختلفة؛ لذلك لا نقدم نتيجتنا وعدا بطريقة حسم تعادل في المكتبة أو خدمة. كما أن وسمًا غير متحقق يحتاج مراجعة المرجع قبل المقارنة.
الرسم يتتبع التنبؤين صفرا ثم الكشفين وتحديث الحالة. لم ننفذ River أو محاكاة خدمة أو قياس دقة نموذج. المثال يشرح ترتيب تقييم قرار قديم مع تعلم لاحق، ويترك تحسين المتعلم أو تأخر بيانات واقعية لمسألة أخرى.
المصادر ومتابعة القراءة
- River: progressive_val_score (يفتح في نافذة جديدة)riverml.xyz
- River: progressive_validation.py الحالي (يفتح في نافذة جديدة)raw.githubusercontent.com
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.