
قد يفشل حرف بعد مطابقة جزء طويل، لكن بعض ذلك الجزء يبقى بداية محتملة للنمط. سنحسب جدول حدود أصليًا، ونتتبع نجاحًا يبدأ عند الموضع اثنين، ثم نراجع أربع مطابقات متداخلة في نص متكرر، مع كود ومرجع مباشر مستقل.
الخلاصة السريعة
جدول الحدود يحتفظ بما يمكن أن يبقى مطابقًا عند الاختلاف، وعند النجاح أيضًا. نراجع الأطوال والمواضع والتداخل وفق عقد حرفي محدد.
- المقارنة حرفية والنمط غير فارغ، ونرجع كل مواضع البداية بما فيها المتداخل. لا نفحص حدود كلمة أو معنى أو تغيير حالة الأحرف.
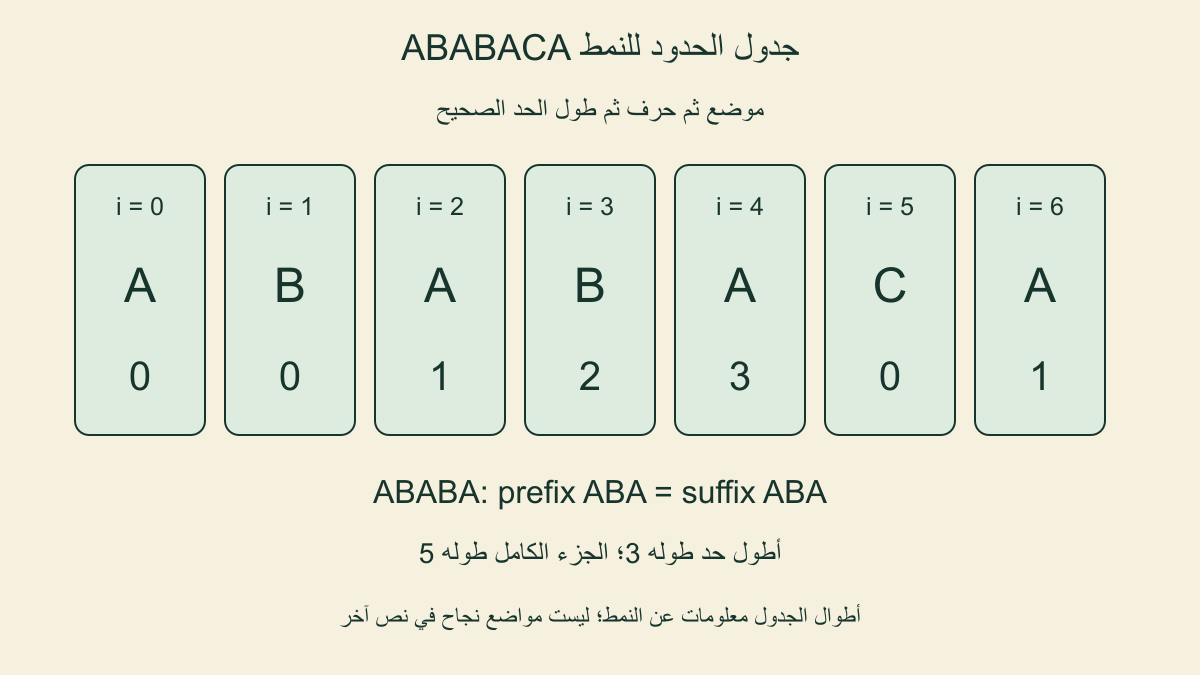
- الحد أطول بادئة تساوي لاحقة لجزء من النمط وتكون أقصر من ذلك الجزء كله. في ABABA الحد ABA بطول ثلاثة، ولا يمنع تداخل الجزأين مساواتهما.
- جدول ABABACA عند المواضع صفر إلى ستة هو 0 و0 و1 و2 و3 و0 و1. الأطوال معلومات عن النمط، وليست مواضع نجاح في نص آخر.
- في ABABABACABA يفشل الحرف B بعد مطابقة خمسة أحرف، فنرجع إلى طول ثلاثة ونفحص الحرف نفسه، حتى يكتمل نجاح يبدأ عند الموضع اثنين.
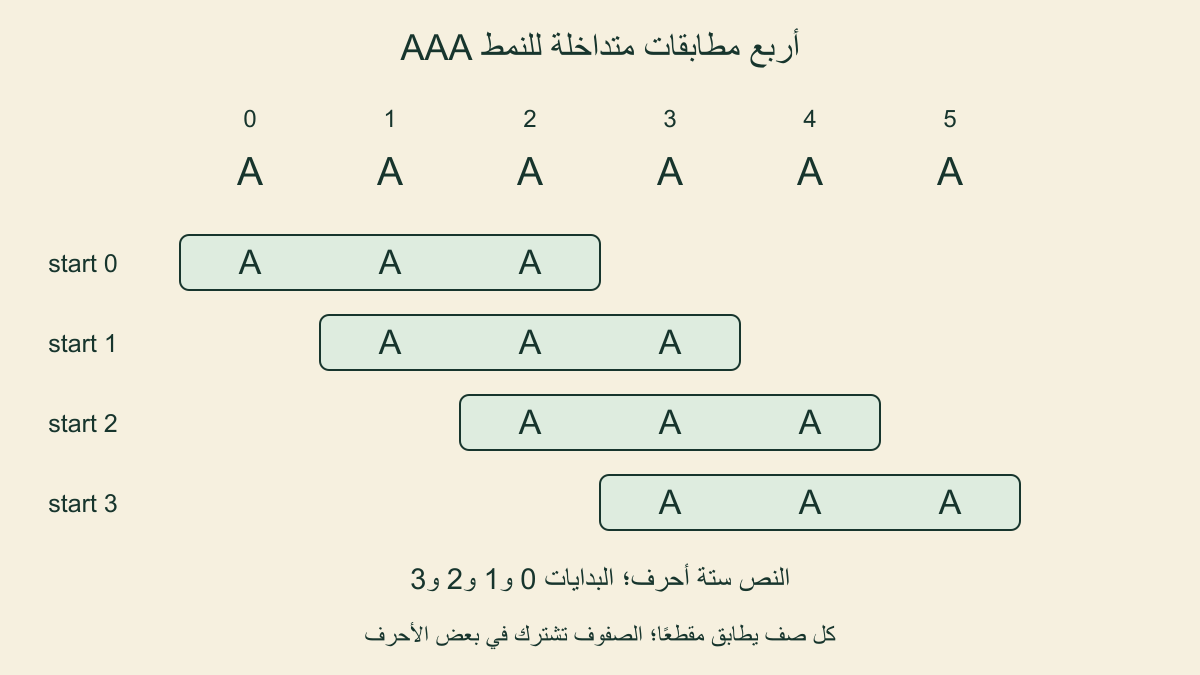
- AAA داخل AAAAAA تعطي البدايات صفرًا وواحدًا واثنين وثلاثة. حفظ الحد AA بعد كل نجاح يسمح باكتشاف التداخل بدل القفز إلى نجاح منفصل.
- الكود يرجع جدولًا ومواضع في tuple ويرفض نمطًا فارغًا أو غير نصي، ويقبل نصًا فارغًا بنتيجة بلا نجاح. النمط الأطول من النص لا يكتمل.
- الطول المطابق وموضع القراءة وبداية النجاح حقول مختلفة. نراجع كل موضع بمقطع بطول النمط، ونحفظ النص والنمط وسياسة التداخل مع النتيجة.
- نقارن الجدول بمرجع بادئات ولواحق مباشر، والبحث بمرجع مقاطع مستقل، مع أمثلة صغيرة. لا نقدم قياس سرعة أو دعمًا لكل سياسة تحويل أو وحدة نص أخرى.
حدد التطابق الحرفي والنمط غير الفارغ
نريد إيجاد كل موضع يبدأ عنده نمط حرفي داخل نص معلوم، بما في ذلك مواضع تتداخل فيها المطابقات. تصف NIST خوارزمية Knuth-Morris-Pratt بأنها طريقة لمطابقة السلاسل تستفيد من حالة مبنية من النمط، وتذكر كلفة مرتبطة بطولي النص والنمط. سنشرح تنفيذًا أصليًا يستخدم جدول الحدود، مع أمثلة مؤلفة من الأحرف A وB وC بدل نسخ مثال المصدر أو رسمه.
في عقدنا النمط غير فارغ، والنص قد يكون فارغًا. تطابق حرف يعني مساواته للحرف المقابل في النمط، وليس تشابه المعنى أو قرب التهجئة. لا نطبق تبديل حالة الأحرف أو تجاهل مسافات أو فحص حدود كلمة. إذا احتاج القارئ أيًا من هذه العمليات، فعليه إعلانها قبل المطابقة وحفظ أثرها على المواضع بدل نسبتها إلى النتيجة الحرفية.
سنرقم المواضع من صفر، ونرجع موضع البداية لكل نجاح. وجود موضع في النتيجة يعني أن مقطع النص بطول النمط ابتداءً من ذلك الموضع يساويه. لا يعني أن كل النص يساوي النمط، ولا أن النجاح كلمة مستقلة. هذا التعريف يجعل فحص كل نتيجة ممكنًا بمقارنة مقطع واضح، ويمنع الخلط بين موضع بداية وعدد أحرف طابقت.
بادئة ولاحقة صحيحتان وليستا النص كله
نأخذ جزءًا يبدأ من أول النمط وينتهي عند حرف معين، ونبحث عن أطول بادئة فيه تساوي لاحقة له، على أن تكون أقصر من الجزء كله. سنسمي هذا الجزء المشترك حدًا داخليًا. في ABABA مثلًا تساوي البادئة ABA اللاحقة ABA، وطولهما ثلاثة. توجد أيضًا A بطول واحد، لكننا نختار الأطول حين نسجل جدول الحدود.
شرط أن تكون أقصر من الجزء كاملًا ضروري. كل نص يساوي نفسه، ولو سمحنا باختياره حدًا دائمًا لما حصلنا على طول أصغر نرجع إليه عند الفشل. في الجزء A المفرد لا توجد بادئة غير فارغة أقصر منه، فيكون طول الحد صفرًا. الصفر هنا عدد أحرف يمكن الاحتفاظ بها، وليس علامة أن الحرف غير موجود في النمط.
وقد تتداخل البادئة واللاحقة في الجزء الذي نراجعه. في ABABA تشترك نسختا ABA في الحرف الأوسط، وهذا لا يمنعهما من كونهما أجزاء متساوية في موضعي البداية والنهاية. لا نطلب انفصالهما كما نفعل في مجموعات غير متقاطعة. المطلوب مساواة السلسلتين وقصرهما عن الجزء كله، وفق تعريفنا الدقيق.
جدول ABABACA وقيمه
نختار النمط ABABACA، وطوله سبعة أحرف. عند الجزء A يكون الحد صفرًا، وعند AB صفرًا أيضًا لأن A لا تساوي B. عند ABA يعود الحرف A في الطرفين فيكون الطول واحدًا. وعند ABAB تكون AB في البداية والنهاية بطول اثنين، وعند ABABA يكون أطول حد ABA بطول ثلاثة.
عند ABABAC تنتهي اللاحقة بحرف C بينما تبدأ البادئة بحرف A، ولا نجد حدًا غير فارغ يطابق في هذا المثال، فيكون الطول صفرًا. وبعد إضافة A إلى نهاية النمط الكامل يصبح الحد A بطول واحد. لذلك جدول المواضع من صفر إلى ستة هو 0 ثم 0 ثم 1 ثم 2 ثم 3 ثم 0 ثم 1.
الرسم الرئيسي يضع حرف كل موضع وطول الحد المسجل بعد قراءته. هذه الأطوال لا تشير إلى مواضع بدء مطابقة داخل النص الذي سنبحث فيه؛ هي معلومات عن النمط نفسه. مثلًا القيمة ثلاثة عند الموضع أربعة تعني أن جزء ABABA له حد بطول ثلاثة، ولا تعني أن النمط الكامل ظهر في موضع ثلاثة من نص آخر.
الرجوع عبر الحدود الممكنة
أثناء بناء الجدول، إذا احتفظنا بحد طولُه ثلاثة ثم لم يوافق الحرف الجديد ما نحتاجه لإطالته، نجرب حدًا أقصر موجودًا داخل ذلك الحد. في النمط المختار، عند وصول C بعد ABABA لا يوافق C الحرف B الذي يلي ABA في بداية النمط. نرجع من الطول ثلاثة إلى الحد المسجل للجزء ABA، وهو واحد.
نراجع الحرف نفسه عند الطول واحد؛ ما يلي A في النمط هو B أيضًا، فلا يوافق C. نرجع إلى صفر ثم نختبر C أمام A، فلا يوافق. لذلك نسجل صفرًا لهذا الموضع دون الرجوع إلى موضع سابق من الإدخال أو اختراع مقارنة نجحت. الرجوع متتابع عبر قيم أصغر، وليس طرح واحد من الطول كل مرة بلا معرفة أي بادئة ما زالت محتملة.
توضح صفحة جامعة Texas فكرة الاستفادة من معلومات ما طابق بالفعل عند حصول اختلاف بدل إعادة كل العمل من البداية. تطبيقنا هنا يحفظ الأطوال ويستعملها لبناء مرشحين أقصر. سنراجع هذه المرشحات بكود مستقل يقارن البوادئ واللواحق مباشرةً، حتى لا يكون توافق جدول مع جدول بني بالطريقة نفسها هو دليلنا الوحيد على صحته.
تتبع النص والموضع الثاني
نبحث عن ABABACA داخل النص ABABABACABA. تبدأ القراءة بأحرف توافق ABABA، فيكون عدد الأحرف المطابقة خمسة. عند الموضع خمسة من النص نجد B، بينما الحرف التالي المطلوب في النمط هو C. ظهر اختلاف، لكن آخر ثلاثة أحرف من المطابقة السابقة هي ABA، وتوافق أول ثلاثة أحرف من النمط؛ لا نحتاج نسيانها.
نرجع من الطول خمسة إلى قيمة الجدول عند الموضع أربعة، وهي ثلاثة. الحرف B الذي نراجعه الآن يوافق الحرف عند الموضع ثلاثة من النمط، فيصبح الطول أربعة. يليه A في النص فيصبح خمسة، ثم C فيصبح ستة، ثم A فيصبح سبعة. عند موضع النص ثمانية اكتمل النمط، فيكون موضع البداية ثمانية ناقص سبعة زائد واحد، أي اثنين.
يمكننا فحص النتيجة بمقطع النص من اثنين حتى ما قبل تسعة، فنجد ABABACA. لم نحرك مؤشر قراءة النص إلى الخلف عند الفشل؛ الذي تغير كان طول الجزء المحتمل من النمط. هذه نقطة تختلف عن بناء مقارنة جديدة من كل بداية في الطريقة المباشرة، مع أن الطريقتين يجب أن تتفقا على مواضع النجاح لهذا العقد الحرفي.
الأطوال والمواضع حقول مختلفة
في التتبع السابق ظهر عدد مطابقة خمسة ثم ثلاثة ثم أربعة، لكن موضع القراءة كان عند الحرف نفسه لحظة الرجوع. الطول يصف عدد أحرف النمط التي توافق نهاية ما قرأناه، بينما الموضع يصف مكان الحرف الحالي داخل النص. لا نستخدم أحدهما بدل الآخر في حساب بداية نجاح، لأن الطولين قد يتغيران عدة مرات عند موضع قراءة واحد.
وعند اكتمال سبعة أحرف في موضع ثمانية، يبدأ النجاح عند اثنين وينتهي قبل تسعة. صيغة البداية تستعمل موضع آخر حرف وطول النمط الكامل. إذا حفظنا موضع القراءة وحده ثم عرضناه للمستخدم كبداية، سنشير إلى النهاية بدل البداية. لذلك نختبر مقطعًا بطول النمط من كل موضع معاد، لا الرقم في عزلة.
كما لا يعني الرجوع إلى طول صفر أن كل النص السابق غير صالح أو خالٍ من الأحرف. يعني أنه لم يبق جزء غير فارغ من بادئة النمط يمكن الاحتفاظ به في هذه الحالة. قد يبدأ الحرف الحالي نفسه تطابقًا جديدًا إذا وافق أول حرف؛ ولهذا يراجعه الكود بعد الرجوع، بدل تجاوزه تلقائيًا إلى الحرف التالي.
تطابقات متداخلة في أحرف متكررة
نختار نصًا من ستة أحرف A ونمطًا من ثلاثة أحرف A. المقاطع بطول ثلاثة التي تبدأ عند صفر وواحد واثنين وثلاثة كلها تساوي AAA. لهذا نرجع أربعة مواضع، رغم أن طول النص ستة فقط. هذه المواضع متداخلة؛ مثلًا النجاح الأول يستعمل الأحرف من صفر إلى اثنين، والثاني من واحد إلى ثلاثة.
لو اشترطنا ألا تشترك النجاحات في أي حرف، لتغير السؤال. يمكن أن نختار النجاح عند صفر ثم عند ثلاثة، لكننا عندئذ لا نرجع جميع ظهورات النمط الحرفية. عدد نتيجتنا أربعة لا يعني وجود اثني عشر حرفًا مختلفًا، بل أربع بدايات لمقاطع تتشارك بعضها. الرسم الداخلي يفصل صف كل نجاح عن صف النص كي تظهر المشاركة بوضوح.
بعد أول نجاح كامل، يملك النمط AAA حدًا بطول اثنين هو AA. يمكننا الاحتفاظ به للاستمرار؛ الحرف A التالي يكمل نجاحًا يبدأ عند واحد. ثم يتكرر الأمر حتى آخر بداية عند ثلاثة. لا نحتاج الرجوع إلى موضع النص السابق، ولا نعتبر النجاح الأول سببًا يمنع البحث عن بدايات أخرى متداخلة معه.
الرجوع بعد النجاح يحفظ التداخل
عند اكتمال النمط، يسجل الكود موضع البداية ثم يرجع إلى أطول حد للنمط الكامل. في AAA هذا الطول اثنان، وفي ABABACA الطول واحد. لا يبقي حالة عددها طول النمط الكامل وهو على وشك قراءة حرف جديد، لأن ذلك سيطلب حرفًا بعد نهاية النمط. ولا يصفر الحالة دائمًا، لأن ذلك قد يحذف إمكانية نجاح متداخل.
في نص AAAAAA، إذا نسينا كل الأحرف المطابقة بعد النجاح الأول، تبدأ قراءة جديدة من الحرف الرابع، فنجد النجاح عند ثلاثة فقط بعد النجاح عند صفر. تختفي البدايتان واحد واثنان من تلك الطريقة المعدلة. المشكلة ليست في مساواة الأحرف عند كل نجاح وصلنا إليه؛ المشكلة في فقد بدايات صحيحة لم نحتفظ بالحالة اللازمة للوصول إليها.
وفي النمط الذي لا يملك حدًا غير فارغ، قد يكون الرجوع بعد النجاح إلى صفر هو الصحيح. لهذا نستعمل قيمة الجدول بدل رقم ثابت نفترضه لكل الأنماط. خاصية التداخل تعتمد على بنية النمط؛ لا نعالج نمطًا ذا أحرف متكررة كما لو كان كل نجاح فيه منفصلًا بالضرورة، ولا نضيف تداخلًا غير ممكن من تخمين مستقل عن الأحرف.
الكود الأصلي وجدول الحدود
الدالة الأولى التالية تبني tuple من أطوال الحدود لنمط نصي غير فارغ. والدالة الثانية تقرأ نصًا وتستعمل هذا الجدول لإرجاع tuple من مواضع جميع النجاحات. كل موضع معاد بداية مقطع بطول النمط، والتداخل مسموح. لا تعدل الدالتان النص أو النمط ولا تدخلان فرزًا أو تغييرًا في الأحرف.
عند الاختلاف ينفذ الكود حلقة رجوع عبر الجدول ما دام هناك طول محتمل غير صفري. ثم يختبر الحرف الحالي مقابل الحرف المناسب في النمط. إذا وافق يزيد الطول، وإذا اكتمل النمط يسجل النجاح ويرجع إلى حد النمط الكامل. هذه خطوات قابلة للمراجعة على مثالينا، لا استدعاء مكتبة تخفي من أين جاء الموضع اثنان أو لماذا وجدنا أربع بدايات.
الكود تنفيذ أصلي لعقد محدد، وليس اختراعًا لخوارزمية جديدة. لا نزعم أنه يطابق أي مكتبة في سياسات النمط الفارغ أو ترتيب الفشل أو البحث عن كلمة. كما لا ننقل أمثلة مصادرنا النصية أو صورها إلى المنتج؛ أحرف الأمثلة والرسوم هنا من تأليف المقال، ونقارن النتائج بمرجع مباشر مستقل عن طريقة الرجوع.
def border_lengths(pattern):
    if not isinstance(pattern, str) or not pattern:
        raise ValueError("nonempty textual pattern required")
    borders = [0] * len(pattern)
    matched = 0
    for position in range(1, len(pattern)):
        while matched and pattern[position] != pattern[matched]:
            matched = borders[matched - 1]
        if pattern[position] == pattern[matched]:
            matched += 1
        borders[position] = matched
    return tuple(borders)


def pattern_matches(text, pattern):
    if not isinstance(text, str):
        raise TypeError("text required")
    borders = border_lengths(pattern)
    matched = 0
    positions = []
    for position, symbol in enumerate(text):
        while matched and symbol != pattern[matched]:
            matched = borders[matched - 1]
        if symbol == pattern[matched]:
            matched += 1
        if matched == len(pattern):
            positions.append(position - len(pattern) + 1)
            matched = borders[matched - 1]
    return tuple(positions)
النمط الأطول والنص الفارغ
إذا كان النمط أطول من النص، لا يوجد مقطع نصي بطوله داخل الإدخال، فتكون نتيجتنا فارغة. مثلًا النمط AAAA داخل AA لا يكتمل. وإذا كان النص فارغًا والنمط A، فلا يوجد موضع يبدأ عنده هذا الحرف، فتعيد الدالة أيضًا tuple فارغة. هذه حالات غياب نجاح، لا أخطاء في العقد الذي يسمح بنص فارغ.
أما النمط الفارغ فنرفضه برسالة خطأ في تنفيذنا. يمكن لطريقة أخرى تعريف مواضع للنمط الفارغ، لكننا لا نتبنى تلك السياسة ضمنيًا. نحتاج نمطًا له حرف أول وجدول حدود غير فارغ حتى تكون خطوات المقارنة المعروضة ذات معنى. لا نفسر الاستثناء بأنه مشكلة في النص إذا كان الذي خالف عقدنا هو النمط نفسه.
ونرفض مدخل نص ليس str في الدالة الثانية، ونرفض نمطًا غير نصي أو فارغًا في دالة بناء الحدود. هذه قرارات تعلنها واجهتنا قبل الحساب. لا نحول قائمة أرقام إلى نص ثم نقول إننا وجدنا نمطًا في الأصل من غير توضيح التحويل. الشروط البسيطة تساعد المراجع على إعادة المثال، مع بقاء الحاجة إلى عقد أوسع إذا أراد أنواع بيانات أخرى.
المطابقة الحرفية لا تبحث كلمة أو معنى
في النص ABABA، يظهر النمط ABA عند صفر واثنين. لا توجد في النموذج مسافات تفصل كلمات، ولا نسأل هل ABA اسم عنصر مستقل أو مقطع من اسم أطول. الدالة تراجع مساواة الأحرف داخل كل مقطع فقط. إذا أراد القارئ حصر النجاحات بين فواصل معينة، فإن ذلك شرط إضافي على المواضع التي رجعت، وليس نتيجة من جدول الحدود.
وكذلك النص AaA لا يساوي AAA في كل أحرفه تحت المقارنة الحرفية التي نستعملها. لا نحذف فرق حالة حرف بحجة أن الشكل قريب، ولا نستنتج أن الكود بحث عن معنى الحروف. يمكن إعداد نسخة محولة لعقد آخر، لكن مواضعها يجب أن ترتبط بالنص الذي طبقنا عليه التحويل، خاصةً إذا أضاف التحويل عناصر أو حذفها.
أمثلتنا من أحرف بسيطة معلومة ومواضع وفق ترتيب النص المدخل في Python. لا نستعمل نتائجها لتحديد حروف مرئية أو كلمات في كل لغة أو واجهة. ما ثبت أن المقاطع المعادة تطابق النمط في الأمثلة التي حسبناها. تحديد وحدة النص في منتج يستخدم بيانات أخرى مهمة مستقلة، ولا نخفيها وراء نجاح تجربة على A وB وC.
ما الذي يقلل إعادة المقارنة؟
في البحث المباشر نستطيع تجربة كل بداية ممكنة ومقارنة أحرف المقطع بالنمط حتى ننجح أو نختلف. أما كودنا فيحتفظ بمقدار ما طابق وبحدود يمكن أن تبقى محتملة، فيتقدم في النص دون إعادة مؤشره إلى الخلف عند كل اختلاف. مثال الطول خمسة الذي رجع إلى ثلاثة يبين أثر حفظ معلومة عن أحرف عرفناها فعلًا.
تذكر NIST وصف كلفة يرتبط بمجموع طولي النص والنمط لخوارزمية KMP. في تنفيذنا توجد مرحلة لبناء الجدول ومرحلة للقراءة، لكننا لم نقس زمنًا على ملفات كبيرة أو نقارن سرعة عملية بمكتبة أخرى. لا نكتب أن عددًا محدودًا من الأحرف يعني زمنًا ثابتًا على كل جهاز، ولا نعرض جدول سرعة ناتجًا من تقدير لم نختبره.
كما نحفظ جدولًا بطول النمط وقائمة مواضع قد تطول عندما تتكرر النجاحات. في مثال AAA داخل AAAAAA حفظنا أربعة مواضع. إذا كان النص أكبر ومكررًا قد يكبر الناتج أيضًا؛ القول إن القراءة تتقدم لا يعني أن البرنامج يحتفظ بذاكرة ثابتة وهو يجمع كل النتائج. نحدد ما نخزنه من أحرف ومعلومات ومواضع قبل وصف حجم العمل.
مرجع مستقل يقارن البوادئ والمقاطع
للتحقق من جدول الحدود، يأخذ مرجعنا كل جزء من النمط من أوله، ثم يجرب أطوالًا أقصر من الجزء ويقارن البادئة واللاحقة مباشرةً. يختار أكبر طول نجح أو صفرًا حين لا يوجد حد غير فارغ. هذا المرجع لا يستعمل جدولًا سابقًا للرجوع، فيستطيع كشف خطأ في قيمة جدول يبدو متسقًا مع استعماله داخل دالة البحث نفسها.
وللتحقق من المواضع، نجرب كل بداية يمكن أن تسع النمط في النص، ونقارن المقطع بطول النمط مقارنة مباشرةً. نحفظ البدايات التي نجحت ثم نقارنها بنتيجة الدالة المعروضة. تدخل في المرجع مواضع متداخلة لأننا لا نقفز بطول النمط بعد نجاح؛ نتقدم بداية واحدة لكل تجربة، وفق السؤال الذي عرفناه.
نفذنا المقارنة على نصوص صغيرة من A وB بأطوال من صفر إلى ستة، وأنماط غير فارغة بأطوال من واحد إلى أربعة. ونضيف ABABACA والتتبع ذي النجاح عند اثنين ونمط AAA المتكرر، ثم حالات رفض المدخلات والحالات الفارغة. هذه فحوص محدودة مستقلة، وليست برهانًا على كل عقد جديد أو شهادة أن بيانات تطبيق خارجي صحيحة.
بطاقة نتيجة تربط النص والنمط والمواضع
يمكن وصف التجربة الأولى ببطاقة: النص ABABABACABA، والنمط ABABACA، والمقارنة حرفية، والمواضع تبدأ من صفر، والنجاح عند اثنين. نضيف جدول الحدود 0 و0 و1 و2 و3 و0 و1، ونكتب أن نهاية النجاح غير المشمولة تسعة. بهذه البيانات يستطيع المراجع إعادة المقطع بدل الاعتماد على رقم ظهر بلا النص الذي حسبناه منه.
وفي تجربة الأحرف المتكررة نكتب النص AAAAAA والنمط AAA، وأننا نعيد جميع البدايات بما فيها المتداخل، فتكون صفرًا وواحدًا واثنين وثلاثة. إذا أعاد تقرير آخر صفرًا وثلاثة فقط، نراجع هل غير العقد إلى نجاحات منفصلة أو فقد حالته بعد كل نجاح. قد تكون بعض المواضع المعادة صحيحة مع بقاء النتيجة ناقصة بالنسبة للسؤال الأصلي.
قبل استعمال المطابقة، حدد وحدة النص وعقد النمط الفارغ ومعنى النجاح والموضع والتداخل. ثم افحص جدول نمط صغير وراجع مقطعًا من كل بداية ناجحة. ستعرف بذلك ما الذي أعادته الحالة والحدود: مواضع تطابق حرفي قابلة لإعادة الحساب، دون ادعاء بحث عن معنى أو كلمة أو صيغة نصية لم يدخل شرطها في الكود.
المصادر ومتابعة القراءة
- NIST: خوارزمية Knuth-Morris-Pratt لمطابقة السلاسل (يفتح في نافذة جديدة)xlinux.nist.gov
- جامعة Texas: الاستفادة من الجزء المطابق عند اختلاف حرف (يفتح في نافذة جديدة)cs.utexas.edu
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.