
تبحث خوارزمية KMP عن نمط داخل نص، وتعيد استخدام ما عرفته من المقارنات السابقة. [1] سننفذ بحثًا كاملًا ونراجع رجوع الحالة والتطابقات المتداخلة بأرقام يمكن إعادة فحصها.
الخلاصة السريعة
- في النص
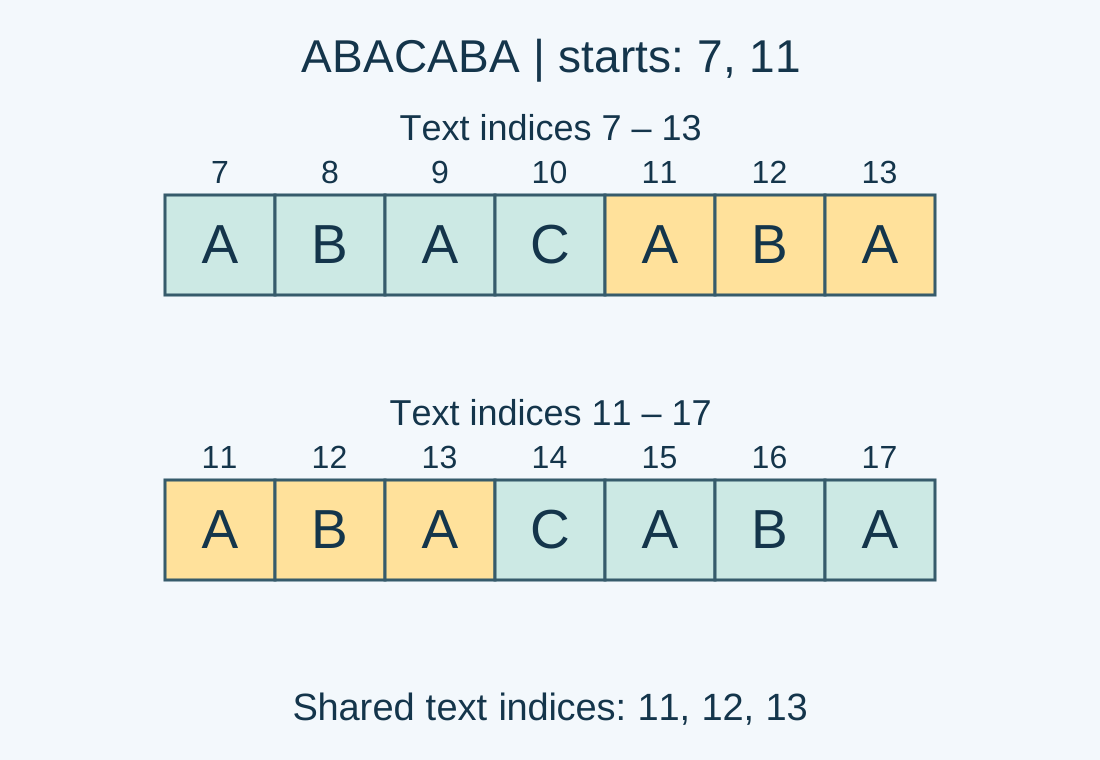
ABACABXABACABACABAيظهر النمطABACABAعند الموضعين 7 و11، بدءًا من صفر. - عند X في الموضع 6، تتراجع حالة المطابقة من 6 إلى 2 ثم صفر، بينما يبقى موضع النص نفسه أثناء هذه المحاولات.
- بعد التطابق الأول نحتفظ بطول 3، لأن آخر ABA تصلح لبداية التطابق التالي.
- برنامجنا يسجل 35 مقارنة للبحث و9 للتهيئة؛ المسح البسيط يسجل 34 في هذا المثال القصير.
- الفحوص تشمل 32690 حالة، منها جميع أزواج النصوص الثنائية حتى طول 8 والأنماط غير الفارغة حتى طول 5.
حدد ما تعنيه الحالة قبل تتبعها
الحالة j تصف عدد أحرف بداية النمط التي تطابق نهاية الجزء المقروء. نستفيد منها كي لا نرجع مؤشر النص إلى الوراء. [3]
تحفظ pi[k] طول أطول بادئة أقصر من مقطع النمط المنتهي عند k وتطابق نهايته. عند اختلاف الحرف التالي نستبدل j بالقيمة pi[j−1]، ثم نجرب الحرف نفسه مجددًا. [2]
لن نعيد درس تعريف البادئة كاملًا؛ يمكن مراجعة مثال البدايات والنهايات والتداخل أولًا. هنا نستخدم النمط ذي الأحرف السبعة ABACABA، وجدوله المحسوب [0,0,1,0,1,2,3]. القيمة 2 عند الموضع 5 تخص ABACAB، إذ تبدأ وتنتهي بـAB. أما النمط الكامل فيبدأ وينتهي بـABA، فتكون قيمته الأخيرة 3.
راقب الفشل عند X دون تحريك النص
تنجح الأحرف الستة الأولى من النص: ABACAB. لذلك تصبح j=6، والحرف المتوقع بعد ذلك هو A، أي الحرف السابع في النمط. لكن النص يقدم X عند الموضع 6. لا نفقد كل المعلومات فورًا؛ نستخدم pi[5]=2 للاحتفاظ بالنهاية AB التي تصلح لبداية جديدة.
نقارن X هذه المرة مع حرف النمط عند الموضع 2، وهو A أيضًا. يفشل الاختبار فنأخذ pi[1]=0. يبقى اختبار X أمام أول A، ويفشل كذلك. هنا فقط ننهي معالجة X، وننتقل إلى موضع النص 7 بحالة صفر. جرت ثلاث مقارنات أحرف فاشلة لهذا X، ولم يرجع مؤشر النص.
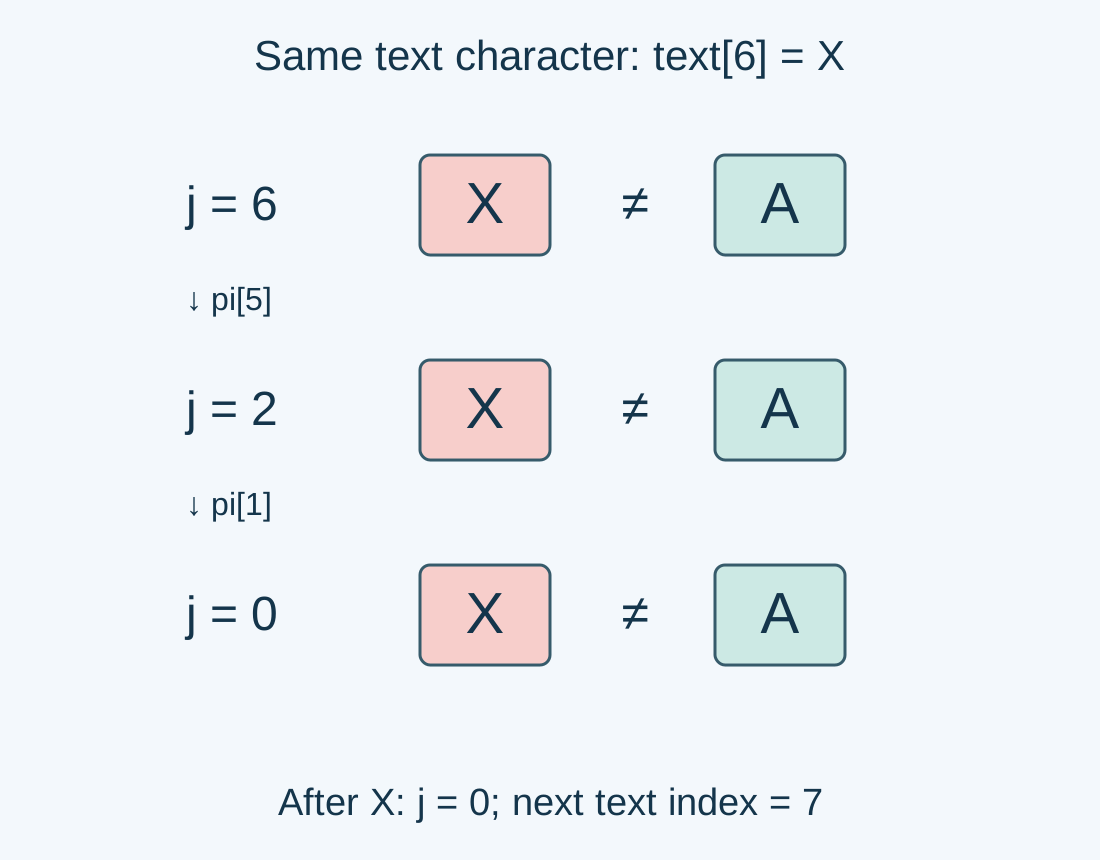
يمثل الرجوع إلى 2 بداية محتملة عند موضع النص 4: آخر حرفين مطابقين هما AB. ثم يمثل الرجوع إلى صفر محاولة تبدأ عند X ذاته. يمكن التأكد مباشرة من النص أن لا تطابق كامل يبدأ في المواضع 0 إلى 6؛ كل بداية ممكنة في تلك المنطقة إما تبدأ بحرف مختلف أو تصطدم بـX قبل اكتمال النمط.
احفظ التداخل بعد الوصول إلى نتيجة
من الموضع 7 تقرأ الخوارزمية ABACABA كاملة، وتنتهي عند الموضع 13. البداية المحسوبة هي 13−7+1=7. نسجل النتيجة، ثم نضبط j إلى pi[6]=3. الأحرف في المواضع 11 و12 و13 هي ABA، وقد تحققنا منها فعلًا؛ لذلك لا نحتاج إلى البدء من صفر.
الحرف التالي عند الموضع 14 هو C، وهو المطلوب بعد تلك ABA. بعده تأتي ABA أخرى في المواضع 15 إلى 17، فنكمل النمط ثانية. البداية هذه المرة 17−7+1=11. لو أعدنا j إلى صفر بعد النتيجة الأولى، لفقد هذا التنفيذ التطابق المتداخل الثاني.
| موضع النص | الحرف | الحالة النهائية | بداية مسجلة |
|---|---|---|---|
| 5 | B | 6 | — |
| 6 | X | 0 | — |
| 7 | A | 1 | — |
| 13 | A | 3 | 7 |
| 14 | C | 4 | — |
| 17 | A | 3 | 11 |
نفّذ الدالة نفسها وراجع مخرجاتها
تعيد الدالة زوجًا: قائمة بدايات التطابقات وجدول pi. نرفض النمط الفارغ صراحة بدل اختيار معنى ضمني له. أما النص الفارغ أو النمط الأطول من النص فينتجان قائمة تطابقات فارغة.
def kmp(text, pattern):
    if not pattern:
        raise ValueError("empty pattern")
    pi = [0] * len(pattern)
    j = 0
    for i in range(1, len(pattern)):
        while j > 0 and pattern[i] != pattern[j]:
            j = pi[j - 1]
        if pattern[i] == pattern[j]:
            j += 1
        pi[i] = j
    hits = []
    j = 0
    for i, ch in enumerate(text):
        while j > 0 and ch != pattern[j]:
            j = pi[j - 1]
        if ch == pattern[j]:
            j += 1
        if j == len(pattern):
            hits.append(i - len(pattern) + 1)
            j = pi[j - 1]
    return hits, pi
تشغيل kmp("ABACABXABACABACABA", "ABACABA") يعيد ([7,11],[0,0,1,0,1,2,3]). واختبار kmp("aaaa", "aa") يعيد البدايات [0,1,2]، فيكشف مباشرة أي تعديل خاطئ يلغي التداخل. الكود المعروض هو الذي استخرجناه من هذه الصفحة وشغلناه في الفحوص.
قارن العمل الفعلي دون الوعد بفوز دائم
للمقارنة استخدمنا مسحًا يجرب كل بداية تتسع للنمط، ويتوقف عند أول اختلاف فيها. هذه هي فكرة البحث المباشر بالنافذة. [3]
عدّادنا يسجل كل مساواة أو اختلاف منفذ بين حرفين، ويستبعد مقارنة الأعداد والفهرسة والإضافة إلى القائمة. في الكود الحالي قد ينجح اختبار الحرف في شرط while ثم يتكرر في if؛ حسبنا الاثنين. لذلك لا تعني قراءة حرف النص مرة في الحلقة أننا نقارنه مرة واحدة فقط.
في مثال X كانت التهيئة 9 مقارنات، والبحث 35، أي 44 معًا، مقابل 34 للمسح المباشر. ثم جربنا نصًا من أربعين A يتبعها B، ونمطًا من ست A تتبعها B. هناك 35 بداية صالحة، ويجرب المسح المباشر سبعة أحرف في كل منها: 35×7=245. أنجز بحثنا 115 مقارنة، مع 15 للتهيئة، فكان مجموعه 130. كلاهما وجد البداية 34.
وفي النص ZYX مع النمط ABC، اكتفى المسح المباشر بمقارنة واحدة، بينما أجرى بحثنا ثلاثًا واحتاج إلى اثنتين للتهيئة. الأرقام تخص هذه الدالة وهذه المدخلات؛ ليست قياسًا للزمن ولا إثباتًا أنها أسرع من دوال المكتبات.
تملك KMP حدًا زمنيًا خطيًا O(n+m) لطولي النص والنمط. [1] هذا وصف لنمو العمل، ولا يضمن أقل عدد من المقارنات لكل مدخل قصير.
تزداد j بمقدار واحد عند نجاح حرف، وتنقص في الرجوع. مجموع الانخفاضات لا يمكن أن يتجاوز مجموع الزيادات؛ فلا تستطيع حلقات الرجوع توليد انخفاضات بلا ارتفاعات سابقة. ويتقدم موضع النص في الحلقة الخارجية فقط. تنطبق الفكرة نفسها على حلقة بناء pi.
اختبر المدخلات وحدد معنى الحرف
طابقنا النتائج مع فحص مستقل لكل موضع بداية، وفحصنا جدول pi بتجريب أطوال البدايات مباشرة. شملت المقارنة 31682 زوجًا ثنائيًا، وألف حالة عشوائية ببذرة ثابتة، وثمانية أمثلة محددة؛ ومع فحوص الرفض والحالات الداخلية نجح 68390 تحققًا. هذه مجموعة اختبارات منفذة، وليست استبدالًا للبرهان العام.
في مثال عربي أعادت الدالة للنص «ماما» والنمط «ما» الموضعين 0 و2. وجربنا سلسلة Python مكونة من e ثم العلامة \u0301 ثم é، وبحثنا عن é. كانت النتيجة [2] فقط؛ لم نضف خطوة لتوحيد التمثيلات. لذا إذا كان تطبيقك يريد مساواة كتابات مختلفة، حدد تلك السياسة قبل استخدام مواضع النتائج.
ابدأ بالفحوص الثلاثة التي تكشف الأخطاء سريعًا: فشل بعد بادئة طويلة، وتطابقان متداخلان، ونمط غير موجود. بعدها قارن المواضع مع مسح بسيط على مدخلات صغيرة. وجود جدول pi صحيح وحده لا يكفي إذا كان تحديث الحالة بعد التطابق أو حساب البداية خاطئًا.
المصادر
- NIST: Knuth–Morris–Pratt algorithm
- Stanford CS97SI: String Algorithms، الصفحات 10–23
- Princeton: Substring Search، الشرائح 9–20
أُعد المقال والرسوم بمساعدة الذكاء الاصطناعي، مع تنفيذ الكود والاختبارات المذكورة. لم تجر مراجعة بشرية مستقلة.