
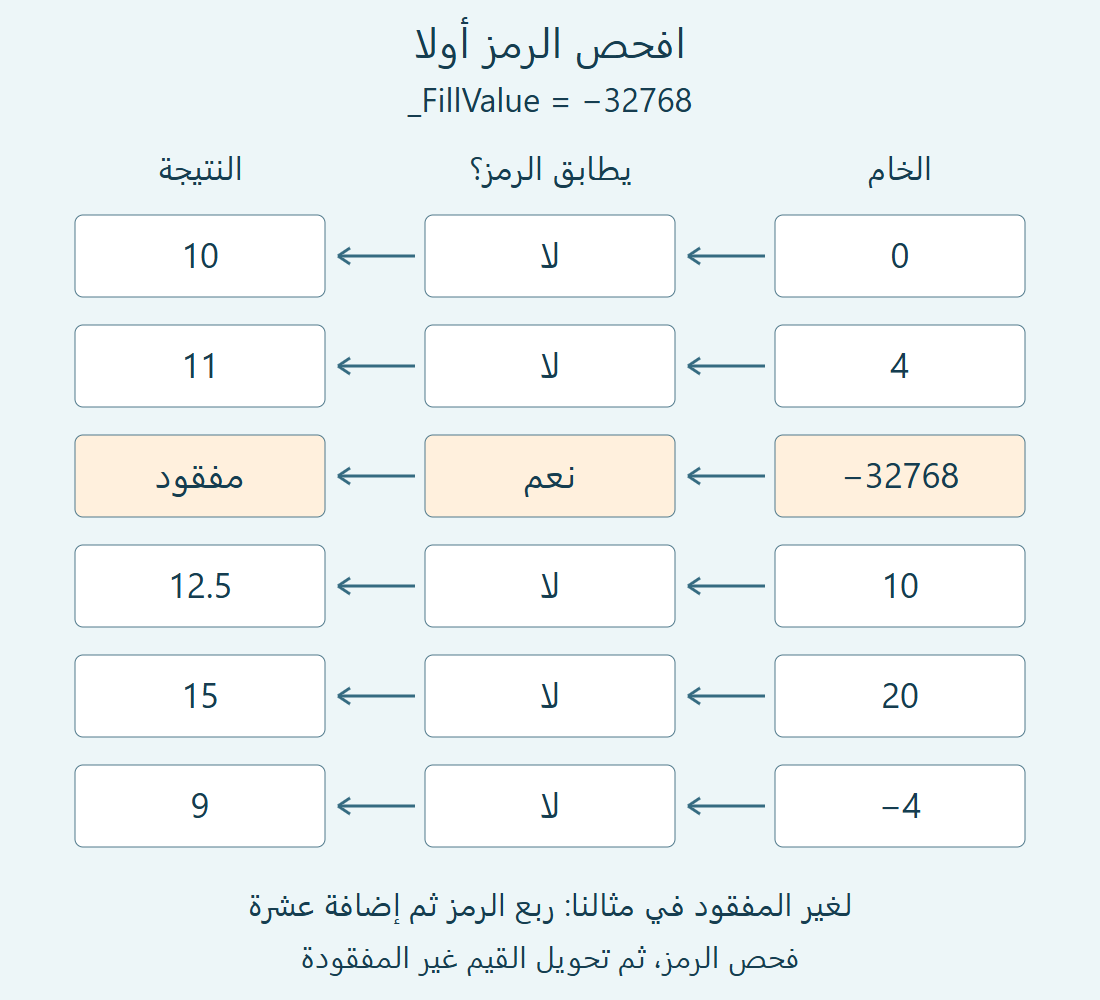
تحدد البيانات المفقودة في المجال المخزن قبل تطبيق التحويل العددي. [1]
الخلاصة السريعة
- كتبنا ستة رموز صحيحة في ملف مؤلف، وجعلنا الرمز −32768 يعني الفقد في هذا المتغير.
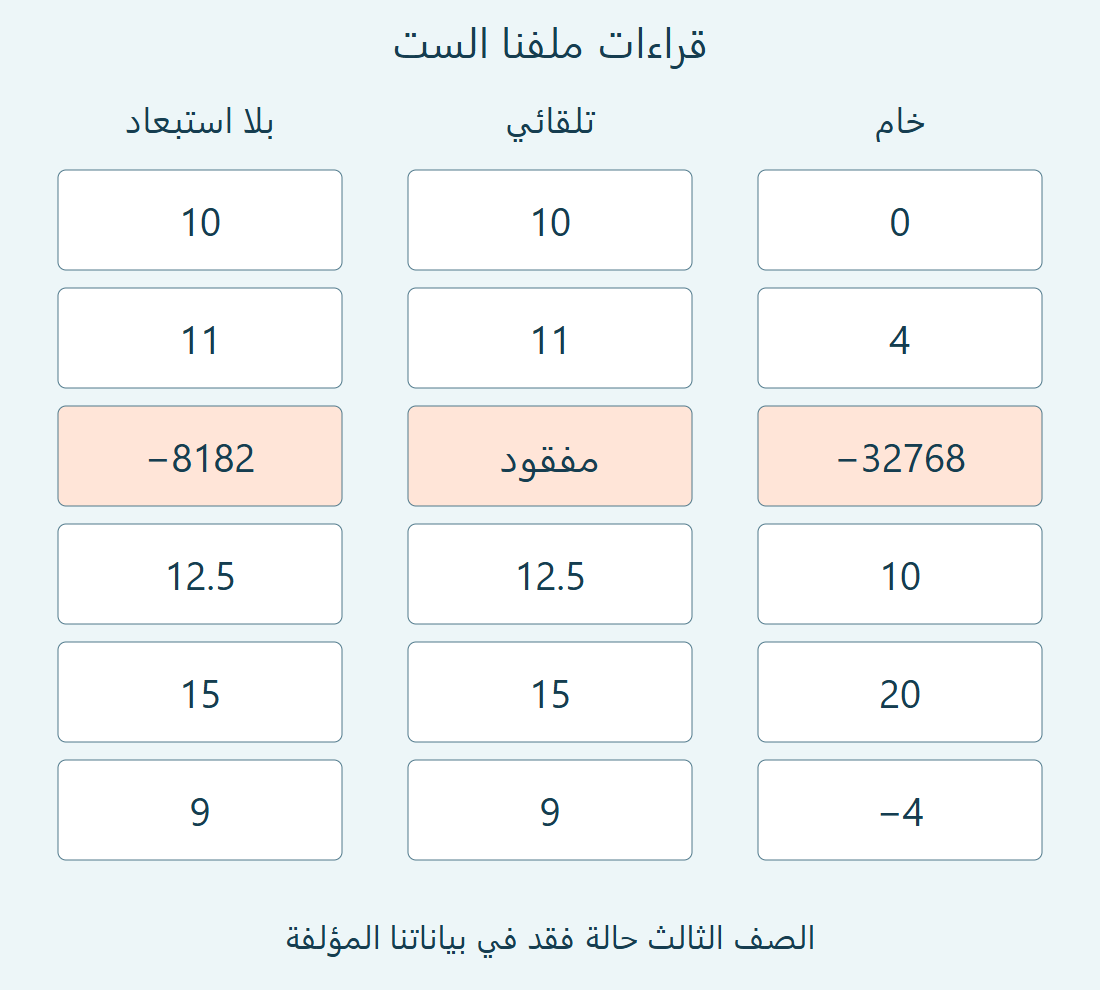
- القراءة التلقائية أبقت المواضع الستة؛ أعادت خمس قيم وجعلت الموضع الثالث مفقودا.
- القراءة الخام أعادت الرموز الستة، ومنها رمز الفقد نفسه.
- تطابق الحساب اليدوي بعد الاستبعاد مع نتيجة المكتبة: 10، 11، مفقود، 12.5، 15، 9.
- أنتج التحويل الأعمى −8182 في الموضع المفقود؛ لم نعتبره قياسا في بياناتنا المؤلفة.
ضع الرمز في مجاله الصحيح
تجربتنا متغير اسمه sample، نوعه i2، وله ستة مواضع. اخترنا الرموز [0,4,−32768,10,20,−4]، والمعامل scale_factor=0.25، والإضافة add_offset=10.0. عينّا _FillValue=−32768 صراحة. الأرقام مؤلفة للتجربة؛ لا تمثل درجات حرارة أو تراكيز أو وحدات بيئية.
ينتمي رمز الفقد إلى نوع البيانات المخزنة ومجالها، لا القيم المفكوكة. [2]
في حساب القيم الصالحة نضرب أولا، ثم نضيف. [1]
لذلك يتحول الرمز 4 في مثالنا إلى 4 × 0.25 + 10 = 11. أما −4 فيعطي −4 × 0.25 + 10 = 9. تشترك الرموز في قاعدة حساب واحدة، لكن الرمز الثالث لا يدخلها؛ طابق قيمة الفقد التي كتبناها في خصائص المتغير.
صرح بوضع الكتابة والقراءة
شغل البرنامج في مجلد لا يحتوي nc-case، بعد توفير مكتبة netCDF4. نفذناه بـPython 3.12.14 ونسخة المكتبة 1.7.4. ينشئ packed.nc بصيغة NETCDF3_CLASSIC؛ ثم يغلقه ويفتحه مرتين، مرة لقراءة تلقائية ومرة لقراءة خام. لا يستخدم ملف أرصاد سابقا.
from pathlib import Path
from netCDF4 import Dataset
out=Path("nc-case");out.mkdir()
path=str(out/"packed.nc")
with Dataset(path,"w",format="NETCDF3_CLASSIC") as d:
    d.createDimension("n",6)
    v=d.createVariable("sample","i2",("n",),fill_value=-32768)
    v.scale_factor=.25;v.add_offset=10.0
    v.set_auto_maskandscale(False)
    v[:]=[0,4,-32768,10,20,-4]
with Dataset(path) as d:
    auto=d["sample"][:].tolist()
with Dataset(path) as d:
    v=d["sample"];v.set_auto_maskandscale(False)
    raw=v[:].tolist();fill=int(v._FillValue)
    scale=float(v.scale_factor);offset=float(v.add_offset)
manual=[None if x==fill else x*scale+offset for x in raw]
wrong=[x*scale+offset for x in raw]
print(raw,auto,manual,wrong,sep="\n")
assert auto==manual==[10.,11.,None,12.5,15.,9.]تتيح المكتبة قراءة خاما أو قناعا وتحويلا تلقائيين؛ نصرح بوضع الكتابة والقراءة. [3]
في تجربة الكتابة أوقفنا set_auto_maskandscale قبل إسناد قائمتنا، لأن القيم التي أعطيناها هي الرموز التي نريد تخزينها. وفي أول فتح للقراءة تركنا الوضع الافتراضي؛ وفي الثاني أوقفناه صراحة. سجلنا الوضعين مع الناتج حتى لا يصبح اسم raw وحده دليلا على نوع القيم. [3]
احتفظ بموضع الخانة المفقودة
طبع البرنامج القائمة الخام كما كتبناها، ثم طبع للقراءة التلقائية [10.0,11.0,None,12.5,15.0,9.0]. استخدمنا tolist() لعرض النتيجة، وأعدنا فحص القناع نفسه مستقلا. في الموضع الثالث كانت علامة القناع مفعلة، بينما بقيت المواضع الأخرى متاحة. لم نحذف الخانة ونضغط القائمة إلى خمسة عناصر.
سجلنا بجانب كل رمز حالة الفقد والقيمة النهائية. عالجنا None في هذه المقارنة بوصفه عرضا للخانة المقنعة، ولم نخلطه بالعدد صفر. الرمز صفر في أول القائمة له نتيجة صالحة في مثالنا، هي 10؛ هذا الفرق ظاهر عند مقارنة الصف الأول بالثالث.
| الموضع | الخام | يطابق الفقد؟ | النتيجة |
|---|---|---|---|
| 1 | 0 | لا | 10 |
| 2 | 4 | لا | 11 |
| 3 | −32768 | نعم | مفقود |
| 4 | 10 | لا | 12.5 |
| 5 | 20 | لا | 15 |
| 6 | −4 | لا | 9 |
اجعل الضابط الخاطئ ظاهرا
نفذ الفرع wrong العملية على كل رمز دون استبعاد. في الصف الثالث أعطى −32768 × 0.25 + 10 = −8182. هذه نتيجة حساب صحيح طبقناه على مدخل لم نخصصه لقياس. بقية الأرقام طابقت النتائج الصحيحة، لذلك لم تكن مراجعة الصفوف غير المفقودة وحدها كافية لاكتشاف الخطأ.
أعدنا الحساب المستقل بكسور دقيقة: 0.25 = 1/4، و10 × 1/4 + 10 = 25/2. طابقت الكسور القراءات الخمس. وكضابط صغير إضافي، تطبيق القاعدة ثانية على الناتج الأول 10 أعطى 12.5 بدلا من 10. ليس هذا هو اختبار الفقد؛ إنه يؤكد أننا ميزنا في سجلنا الرموز من النتائج التي حوّلت بالفعل.
اقرأ الخصائص مع البيانات
أعدنا فتح الملف للتحقق من قيم الخصائص ونوع الرمز والقناع والقراءة الخام، ثم قارنا البصمة قبل القراءات وبعدها. لم تتغير بايتات الملف. اختلاف العرض بين الخام والتلقائي في تجربتنا جاء من طريقة القراءة، لا من إعادة كتابة البيانات. احتفظنا بالقائمة الخام وخصائصها والنتيجة المقنعة كي يمكن تفسير الصف الثالث من السجلات نفسها.
اعتمدنا في القاعدة على الموضعين 2.5.1 و8.1 من CF 1.12. لم نختبر كل قواعد الصلاحية أو أنواعا غير متغيرنا، ولم نعلن الملف مجموعة أرصاد متوافقة بالكامل. عند إعادة هذا المثال، راجع رمز الفقد وطريقة القراءة قبل تفسير رقم لافت على أنه قيمة رصد.
المراجع
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي وراجعته أدوات ذكاء اصطناعي. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.