
أخذ عينات من إطارات الفيديو يختار صورا من المقطع بدلا من عرض كل لحظة للمعالجة. يوضح دليل Hugging Face في فرع main أن نماذج الفيديو والنص قد تستقبل إطارات مختارة، وأن مهمة الدليل لا تتعامل مع الصوت. [1] نوضح حدود الاستنتاج من ثلاث لقطات افتراضية دون تحليل فيديو حقيقي.
الخلاصة السريعة
صف ما يظهر في الإطارات المختارة عند أوقاتها، وراجع الفيديو إذا احتجت مسار الحركة أو بداية الحدث؛ الفراغ بين صورتين لا يروي نفسه.
- المسار الموثق يعالج الفيديو والسؤال باستخدام إطارات، ومهمة الدليل لا تشمل الصوت؛ لا تفترض أن جوابها سمع ما قيل. [1]
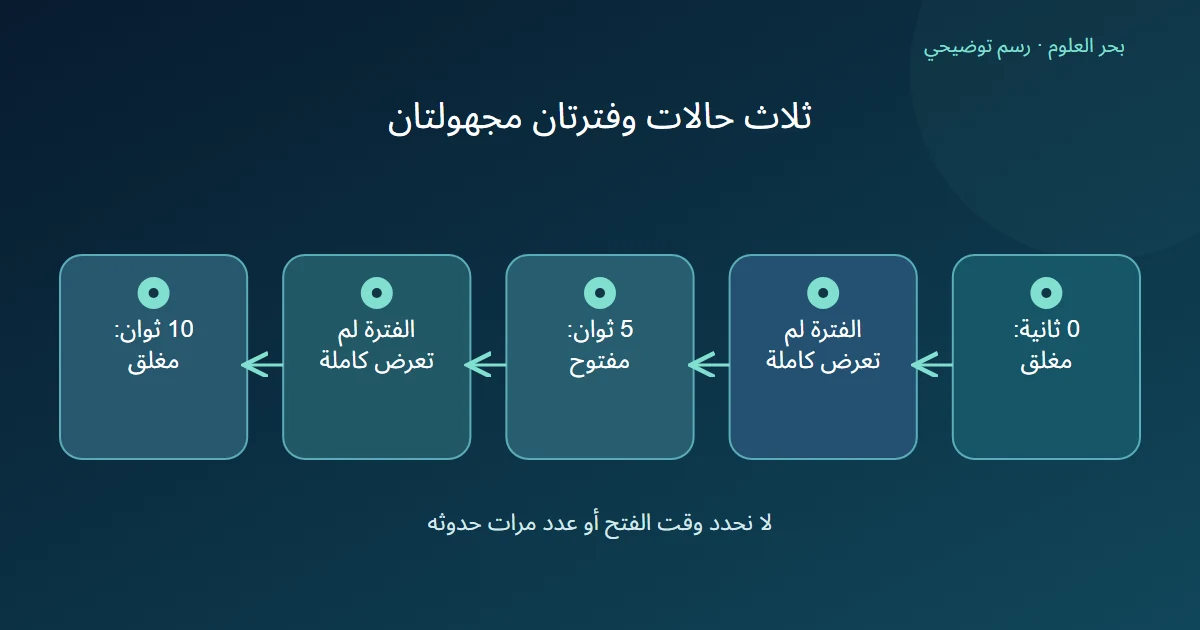
- المشاهدات المفترضة: الصندوق مغلق عند 0، ومفتوح عند 5، ومغلق عند 10 ثوان؛ هذه حالات عند أوقات محددة.
- وجود الصندوق مفتوحا عند 5 لا يثبت أنه فتح في تلك اللحظة أو ظل مفتوحا في كل الفترة؛ الحدث بين الإطارات غير مكتمل الرصد.
- ثبت الملف وأوقات العينات وراجع المقطع الأصلي عند الحاجة؛ زيادة الإطارات ليست ضمانا للدقة أو لتغطية الصوت.
ما المدخل الذي تناقشه الوثيقة؟
يميز دليل فرع main المهمة عن نموذج لا يستقبل إلا صورا متعددة دون فهم زمني، ويشرح اختيار عدد من الإطارات من الفيديو. كما ينص على أن المهمة الموصوفة لا تعالج الصوت. [1] نطاقنا قراءة مشاهدات مرئية، وليس كل قدرات النماذج متعددة الوسائط أو كل نسخة من المكتبة.
نفترض مقطعا لعلبة أدوات على طاولة في ورشة. اخترنا يدويا، لأغراض الشرح، صورا عند الثانية صفر والخامسة والعاشرة من الملف نفسه. لم نستخدم أداة أخذ عينات أو نموذج إجابة، ولا نعطي هذا العدد صفة إعداد مناسب لكل تسجيل.
ماذا تثبت الصور الثلاث في المثال؟
تظهر العلبة مغلقة في الصورة الأولى، ومفتوحة في الثانية، ومغلقة في الثالثة. يمكننا القول إن الحالة المرئية اختلفت بين هذه المشاهدات. نستعمل التوقيت بوصفه موضع الإطار في الملف، ولا نعرف منه الساعة التي صور فيها العامل اللقطة أو زمن الحدث في يوم معين.
لو كان السؤال «هل تظهر مفتوحة في الإطار عند 5؟» فالمثال المفترض يوفر مشاهدة لذلك. أما «متى بدأ فتحها؟» فيحتاج إلى معلومات عن الفترة السابقة. تغيير السؤال يغير مقدار الرصد اللازم؛ لا نمد جواب السؤال الأول ليملأ الثاني.
ما الذي قد يقع بين الإطارات؟
قد يفتح شخص العلبة قبل الثانية الخامسة، ثم يغلقها ويفتحها مرة أخرى بين العينات. الصور الثلاث وحدها لا تثبت هذا السيناريو ولا تنفيه. لذلك لا نكتب رواية «فتحها مرة واحدة عند 5 وأغلقها عند 10» وكأن اللحظتين هما بداية الفعل ونهايته المرصودتان.
ونقترح إذا احتاج محرر الدليل وصف الحركة، أن يرجع إلى الفترة المعنية في الفيديو ويراجعها. زيادة نقاط المشاهدة قد توفر تفاصيل إضافية، لكنها لا تعطينا تلقائيا كل ما فات بينها. لا نقيس هنا جودة إجابة أو نعلن رقما كافيا لكشف كل حركة أو تصرف.
كيف تكتب نتيجة قابلة للمراجعة؟
في مثالنا نكتب «ظهرت العلبة مفتوحة في لقطة الثانية 5» ونرفق موضعها في النسخة المعنية. وإذا سئلنا عن عدد مرات الفتح، نقول إن العينات لا تكفي لتحديده. لا نستعمل خلو الإطار من يد ظاهرة دليلا على أن أحدا لم يلمس العلبة بين الإطارات.
كذلك لا ننسب شرحا مسموعا إلى المسار الموثق في المقال. إن كان الصوت جزءا من السؤال، نحتاج مسارا يدعمه فعلا ومراجعة ما سمع. نميز حدود المدخل عن فشل الفهم؛ غياب الصوت أو الفترات غير المعروضة لا يصبح معلومة نكملها لأن الجواب جاء بصياغة واثقة.
المصادر ومتابعة القراءة
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.