
replace تعوض أخطاء فك الترميز بمحرف U+FFFD. [1]
الخلاصة السريعة
لا؛ U+FFFD قد يأتي من بايتات صحيحة في المصدر. [1]
- replace تعوض أخطاء فك الترميز بمحرف U+FFFD. [1]
- ظهور U+FFFD وحده لا يثبت خطأ بايتات UTF-8. [1]
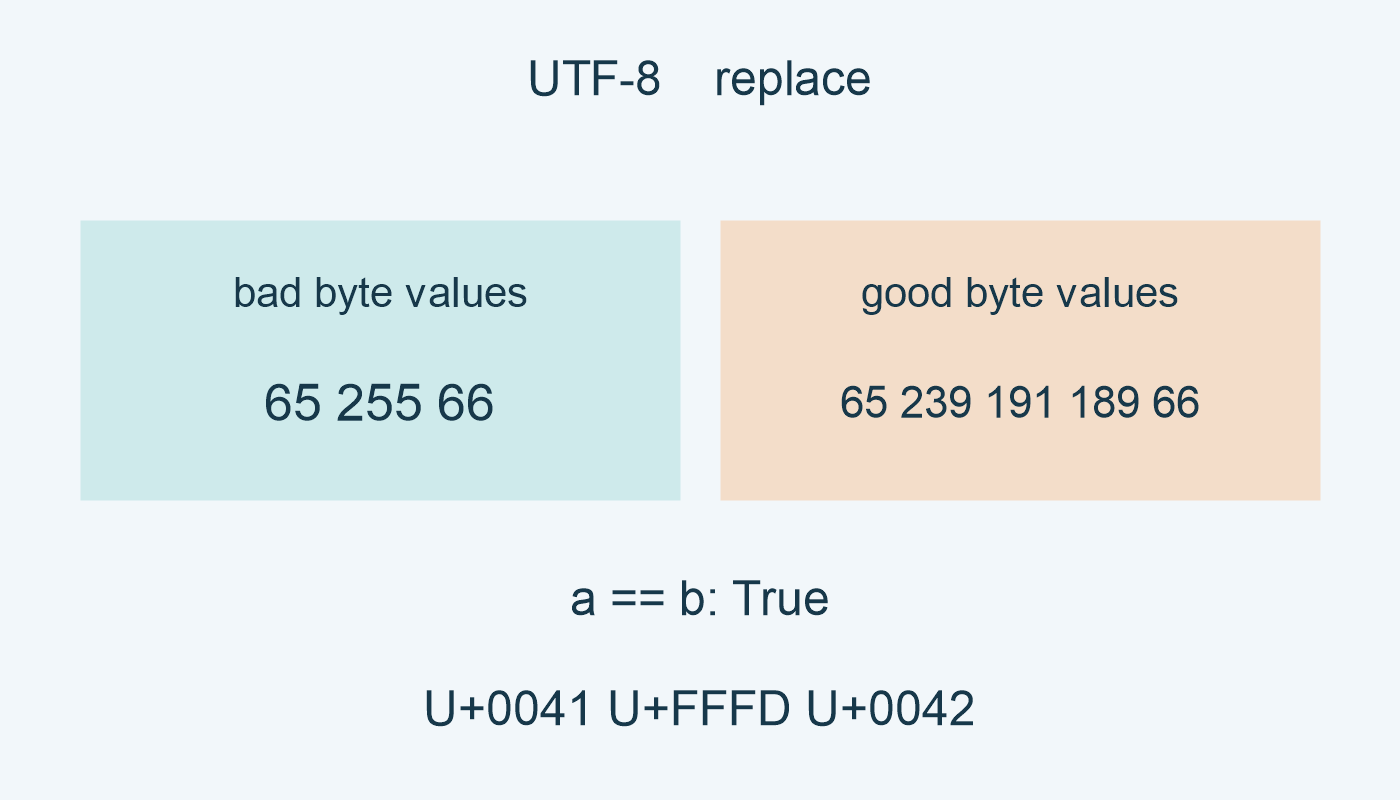
- مثال مؤلف على CPython 3.12.14: import codecs؛ bad=bytes([65,255,66]) وgood=bytes([65,239,191,189,66]). [1]
- بـUTF-8 وسياسة replace، تعيد codecs.decode للمدخلين النص نفسه بنقاط [65,65533,66]؛ الوسط U+FFFD. [1]
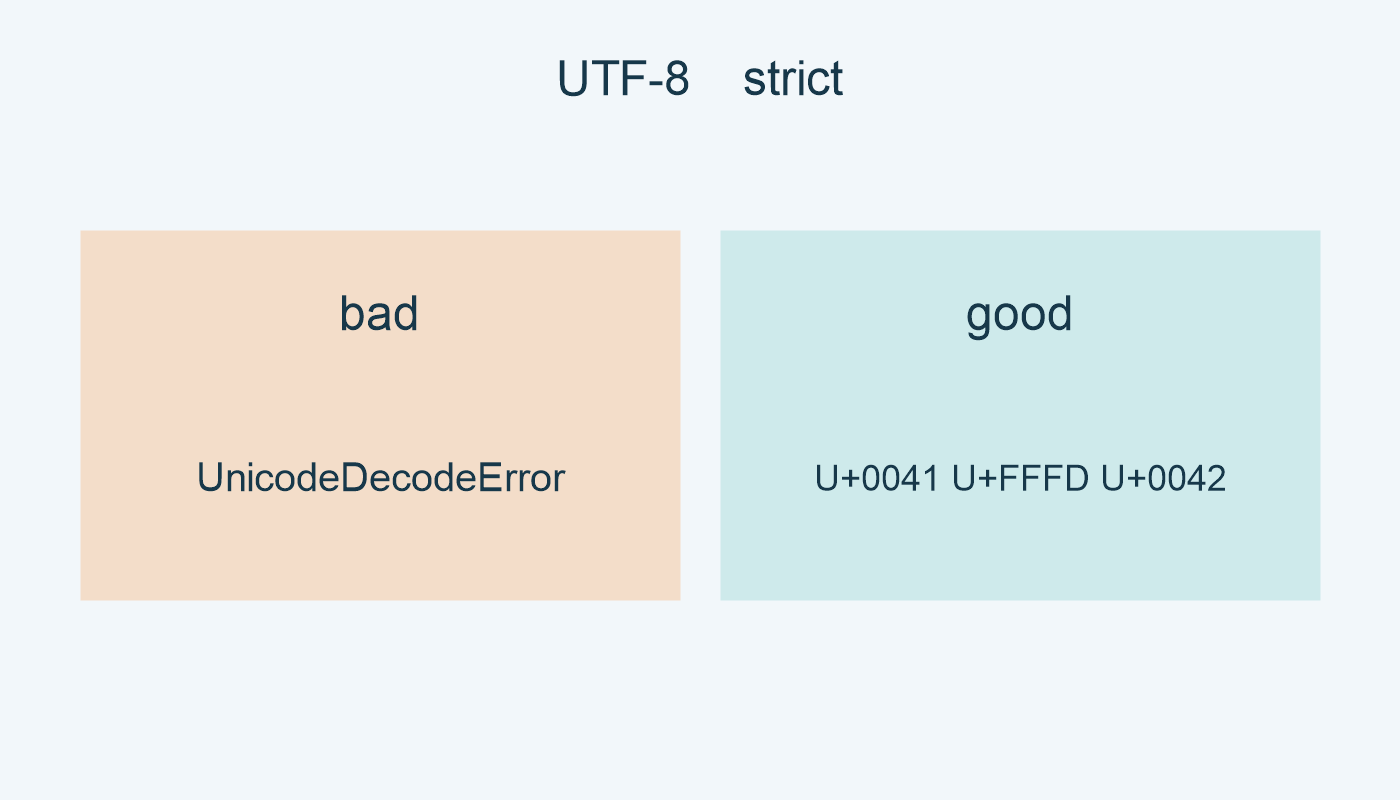
- تحكم strict: bad تثير UnicodeDecodeError؛ good تعيد النص نفسه. [1]
معالجة الخطأ
replace تعوض أخطاء فك الترميز بمحرف U+FFFD. [1]
حد الاستنتاج
ظهور U+FFFD وحده لا يثبت خطأ بايتات UTF-8. [1]
بايتات مختلفة
مثال مؤلف على CPython 3.12.14: import codecs؛ bad=bytes([65,255,66]) وgood=bytes([65,239,191,189,66]). [1]
a=codecs.decode(bad,"utf-8","replace"); b=codecs.decode(good,"utf-8","replace") [1]
نص واحد وتحكم
بـUTF-8 وسياسة replace، تعيد codecs.decode للمدخلين النص نفسه بنقاط [65,65533,66]؛ الوسط U+FFFD. [1]
codecs.decode(bad,"utf-8","strict") -> UnicodeDecodeError [1]
تحكم strict: bad تثير UnicodeDecodeError؛ good تعيد النص نفسه. [1]
المراجع
للتوسع: لغات البرمجة.
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.