
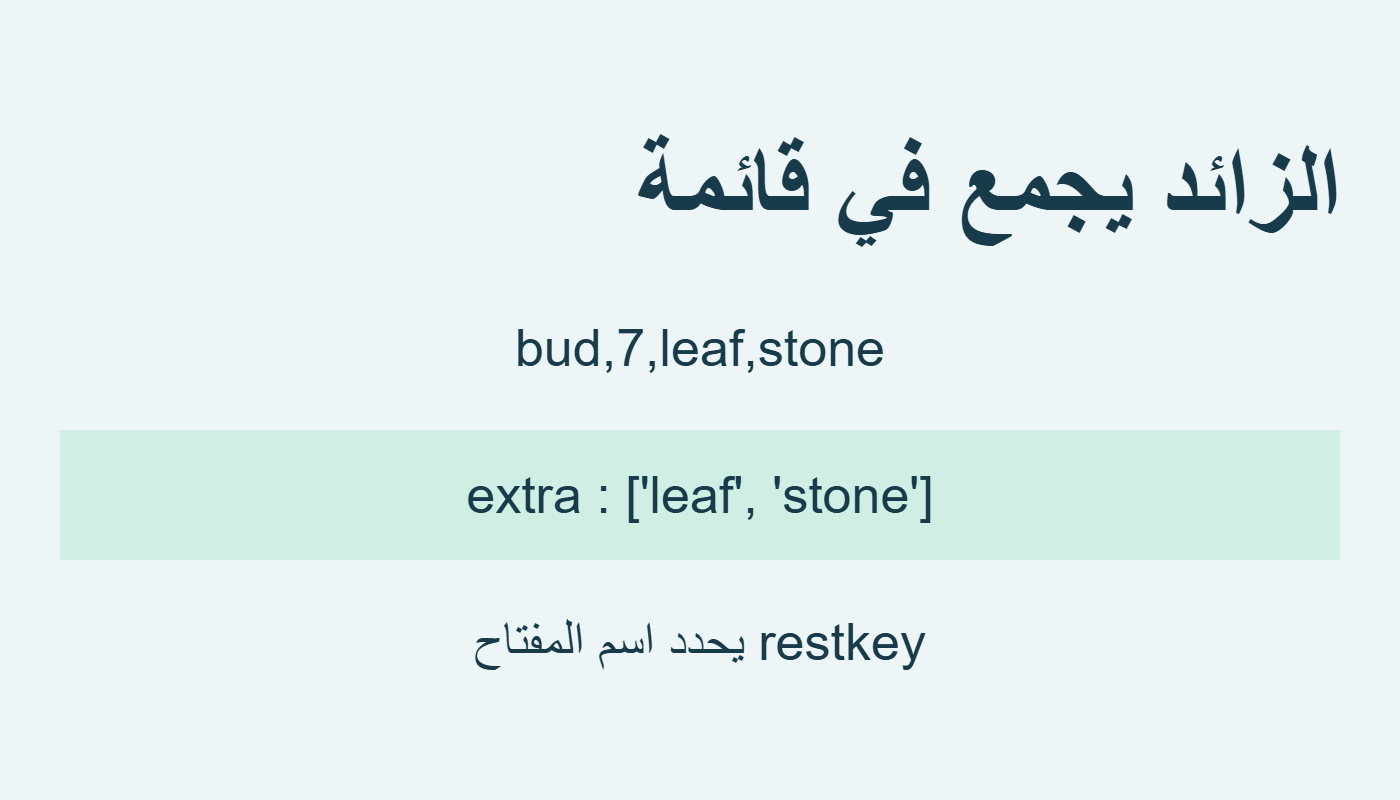
عدد الحقول قد يختلف عن عدد أسمائها. [1] [2]
الخلاصة السريعة
المثال
import csv
rows=['bud,7,leaf,stone','bud']
r=csv.DictReader(rows,
    fieldnames=['name','qty'],
    restkey='extra',
    restval='MISSING')
for row in r:
print(row)الزائد والناقص
المصدر هنا يربط الاسم بالقيمة، ثم يحفظ الباقي أو يملأ الغائب. حددنا الأسماء صراحة؛ لذلك السطر الأول بيانات، لا عنوان مستبعد. قيمة qty الأولى نص 7، والثانية MISSING. [1] [2]
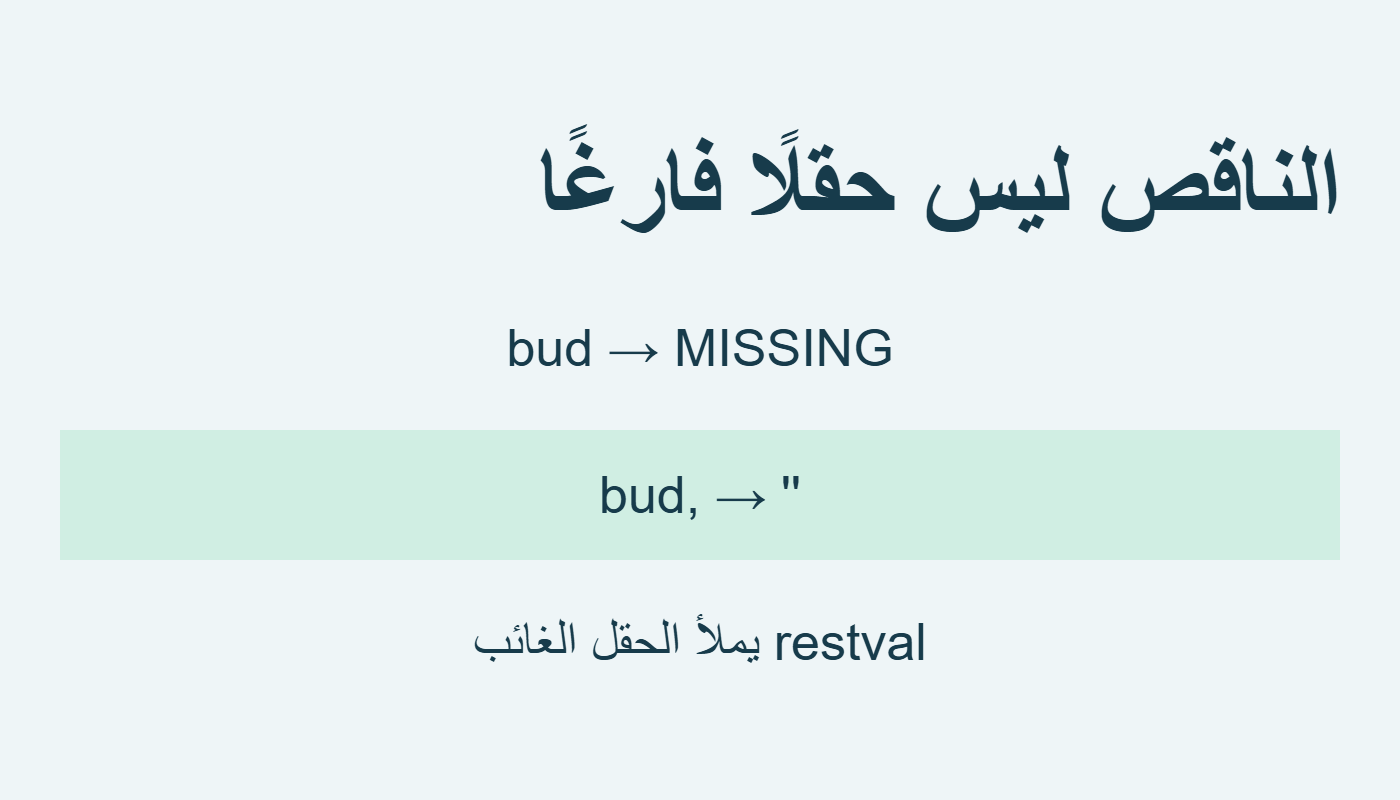
الفارغ والنطاق
لو استبدلنا السطر الثاني بـ bud,، تصبح qty نصًا فارغًا، لا MISSING: الحقل موجود. يستخدم المثال قوائم في الذاكرة؛ لا نستورد ملفًا ولا نعمم النتيجة على pandas. [1] [2]
المراجع
- Python 3.12: csv.DictReader
- CPython 3.12.14: csv.py
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.