
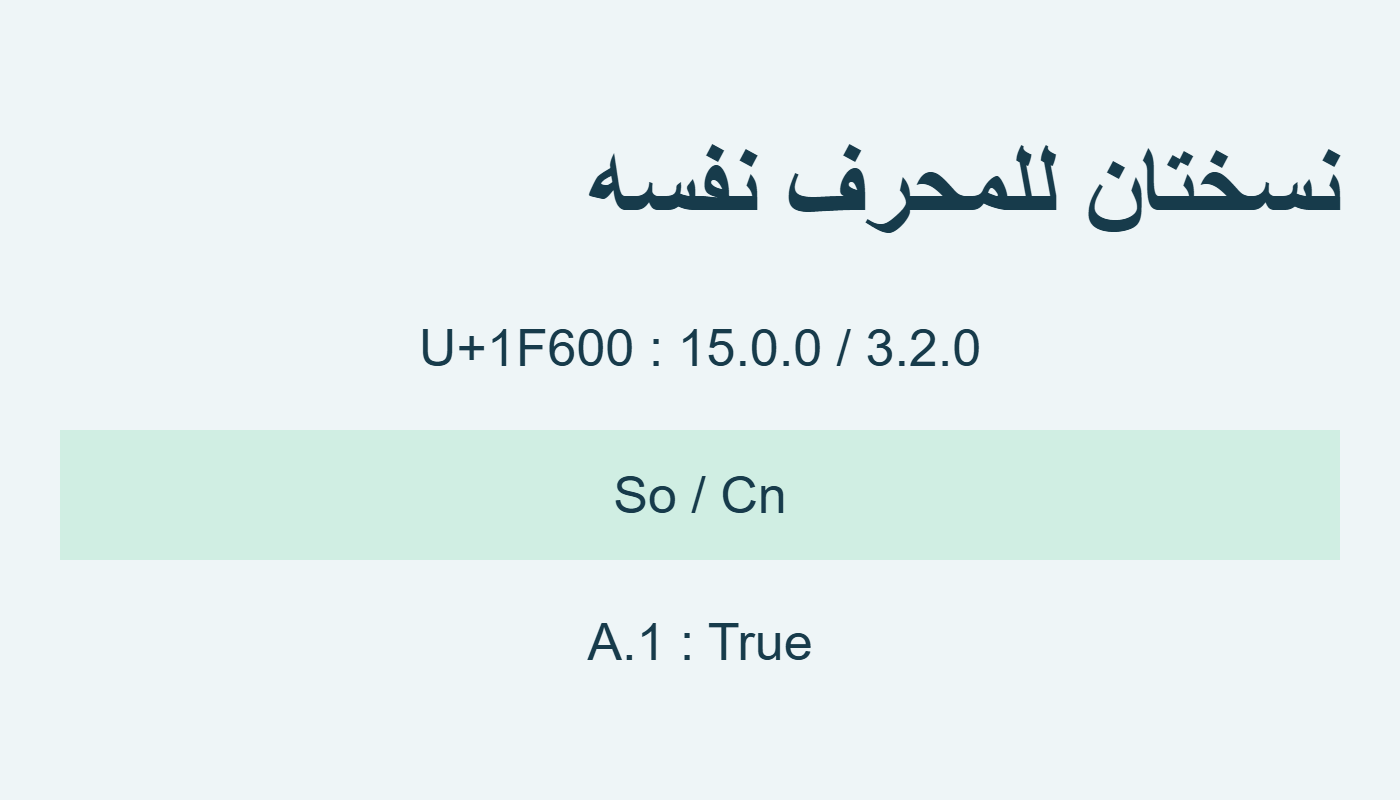
قد يختلف التصنيف باختلاف نسخة قاعدة البيانات. [1] [2] [3]
الخلاصة السريعة
جدول A.1 يحتكم إلى Unicode 3.2، لا قاعدة المحارف الأحدث. [1] [2] [3]
المثال
import stringprep as s
import unicodedata as u
c=chr(0x1F600)
print(u.category(c),
      u.ucd_3_2_0.category(c))
print(s.in_table_a1(c))أي قاعدة يستخدم الجدول؟
المصدر هنا يستورد قاعدة 3.2.0 صراحة. قاعدة unicodedata المعتادة في بيئتنا هي 15.0.0. لذلك لا يناقض تعيين المحرف فيها دخوله جدول النقاط غير المعيّنة قديمًا. [1] [2] [3]
لماذا لا نكتفي بفئة Cn؟
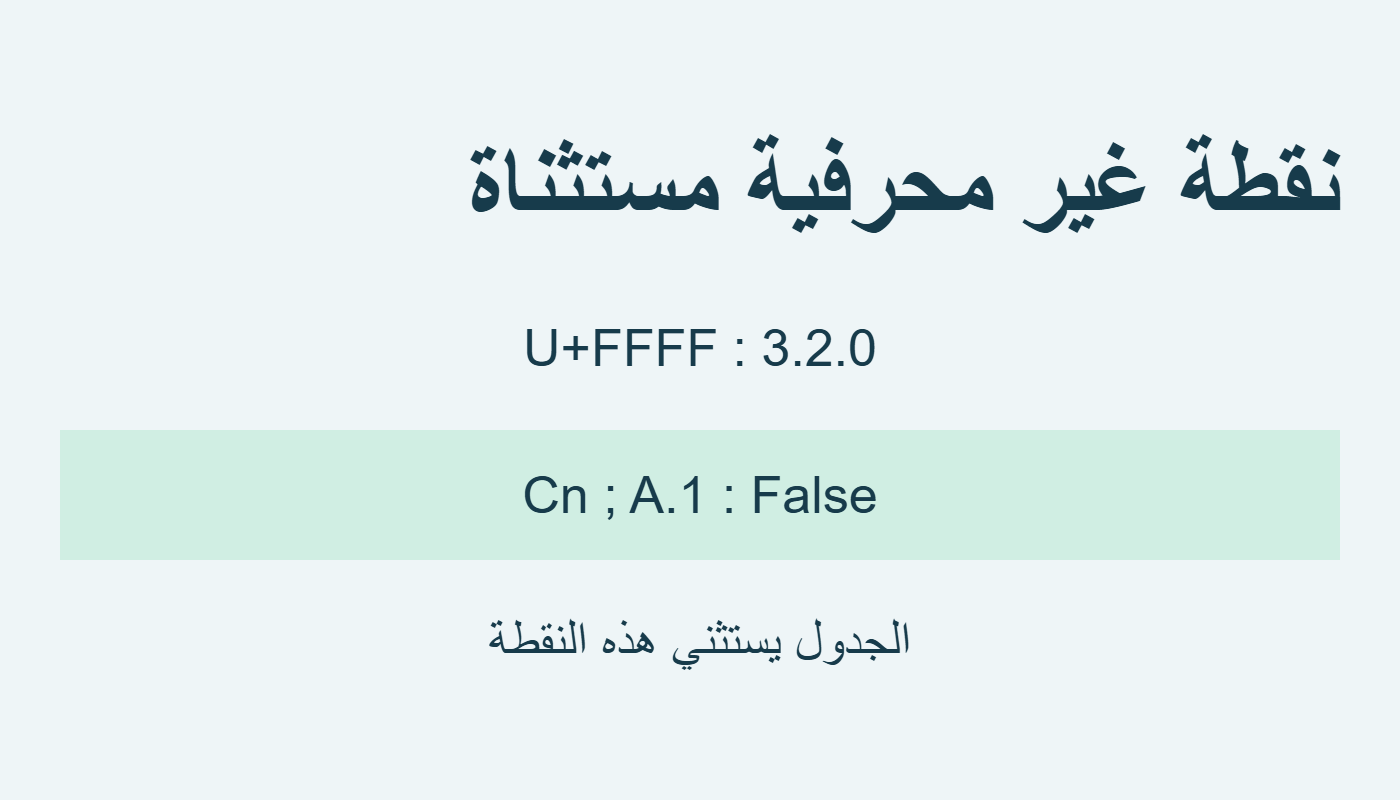
يستثني المصدر نقاطًا غير محرفية؛ لذا تعطي U+FFFF النتيجة False. لا نستنتج من رفضها أنها معيّنة؛ فئتها القديمة ما زالت Cn. هذا فحص نقطة واحدة، وليس حكمًا بصلاحية اسم نطاق. [1] [2] [3]
المراجع
- Python 3.12: stringprep A.1
- CPython 3.12.14: stringprep.py
- Python 3.12: Unicode databases
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.