
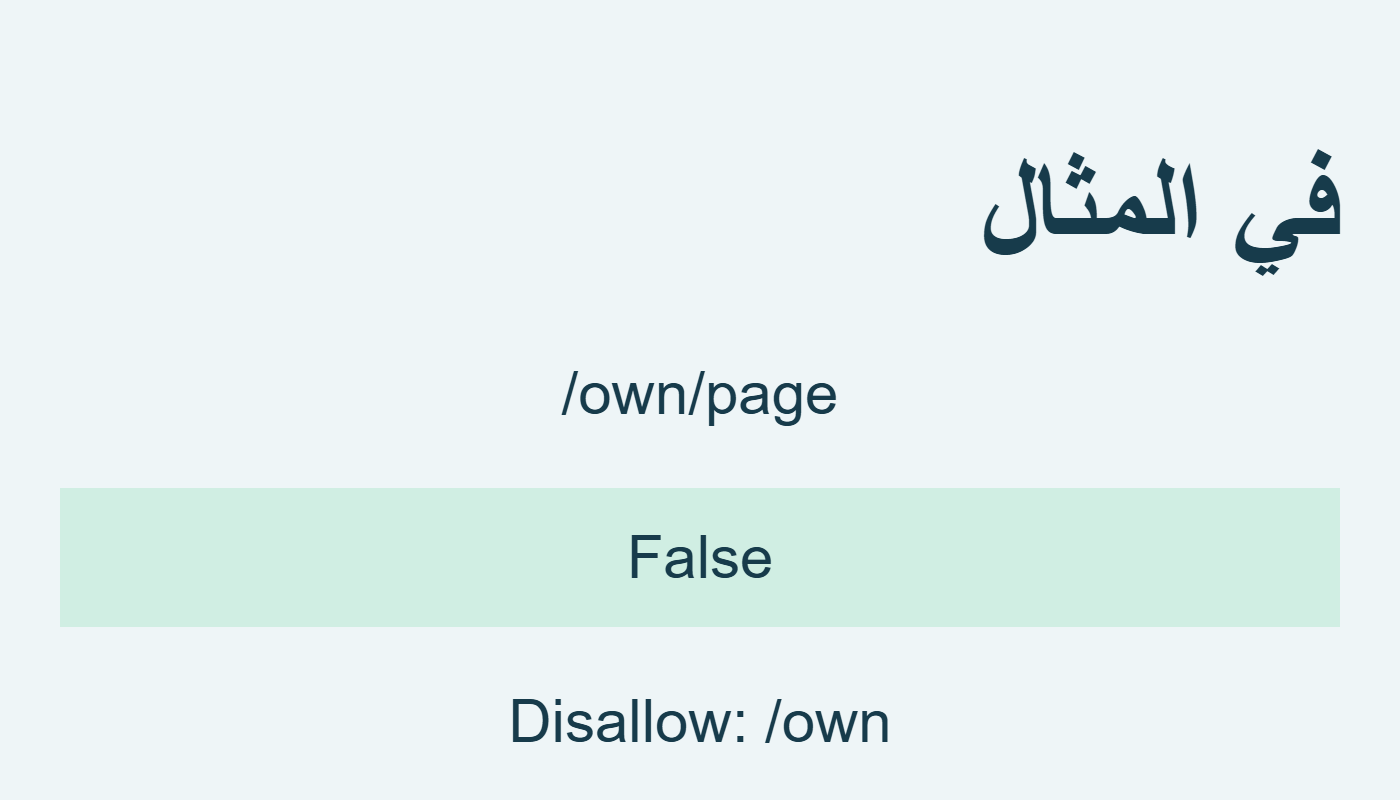
نحلل سطرين مؤلفين في الذاكرة، دون تنزيل. [1] [2]
الخلاصة السريعة
المثال
from urllib.robotparser import RobotFileParser
r=RobotFileParser()
r.parse(['User-agent: *','Disallow: /own'])
print(r.can_fetch('ownbot','https://own.invalid/own/page'))
print(r.can_fetch('ownbot','https://own.invalid/public'))القرار والصفحة
القيمة الأولى تطابق حظر المسار في مثالنا؛ الثانية لا تطابقه. لم نختبر وجود الصفحتين أو تنزيلهما. يتغير سجل زمن المحلل عند parse، فلا نصف العملية بأنها بلا تغير حالة. [1] [2]
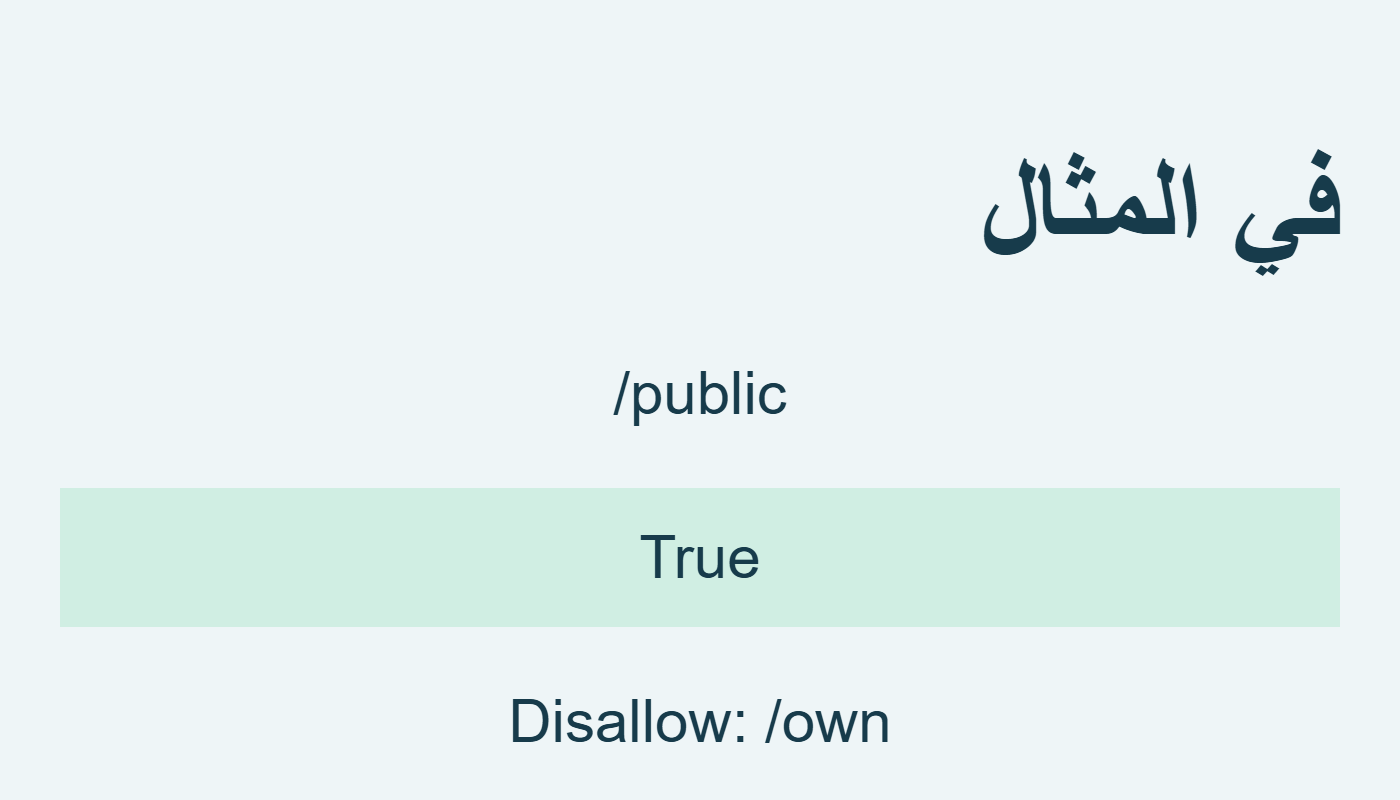
الحدود
نتيجتان لقواعد بسيطة، لا اختبار فهرسة أو ترتيب نتائج أو مطابقة كاملة لمعيار الزحف. قراءة قواعد حقيقية تحتاج خطوة منفصلة لم ننفذها. [1] [2]
المراجع
- Python: urllib.robotparser
- CPython3.12.14: robotparser
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.