
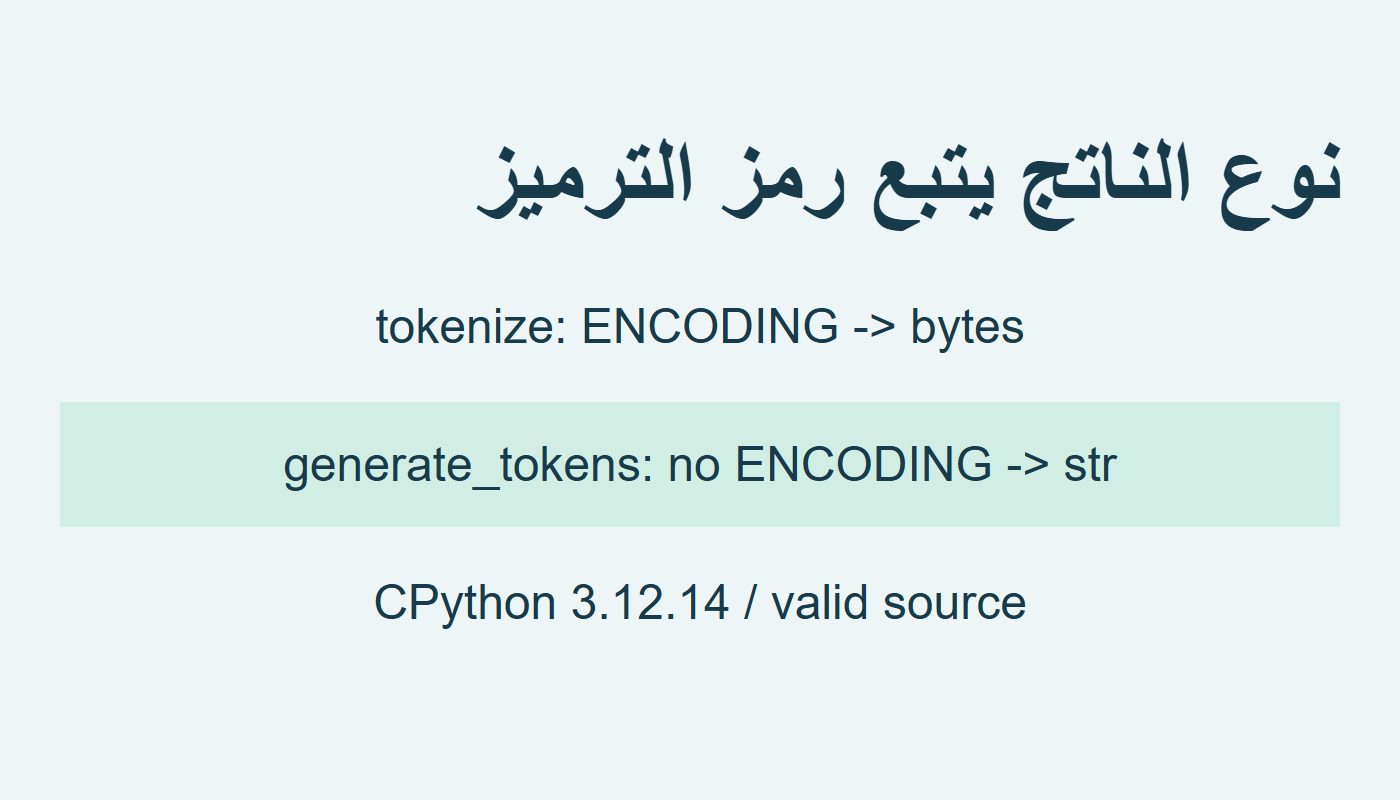
قارن نوع الناتج ورمز الترميز. [1] [2]
الخلاصة السريعة
مدخلان للمثال
tokenize تقرأ بايتات. generate_tokens تقرأ نصًا. [1] [2]
import io,tokenize as t
s="bud=7\n"
b=list(t.tokenize(io.BytesIO(s.encode()).readline))
u=list(t.generate_tokens(io.StringIO(s).readline))
print(any(z.type==t.ENCODING for z in b))
print(any(z.type==t.ENCODING for z in u))
print(type(t.untokenize(b)).__name__)
print(type(t.untokenize(u)).__name__)
رمز ونوع
الأولى تنتج ENCODING؛ الثانية لا تنتجه. [1] [2]
untokenize تعيد هنا bytes ثم str. [1] [2]
النتيجة: True، False، bytes، str. [1] [2]
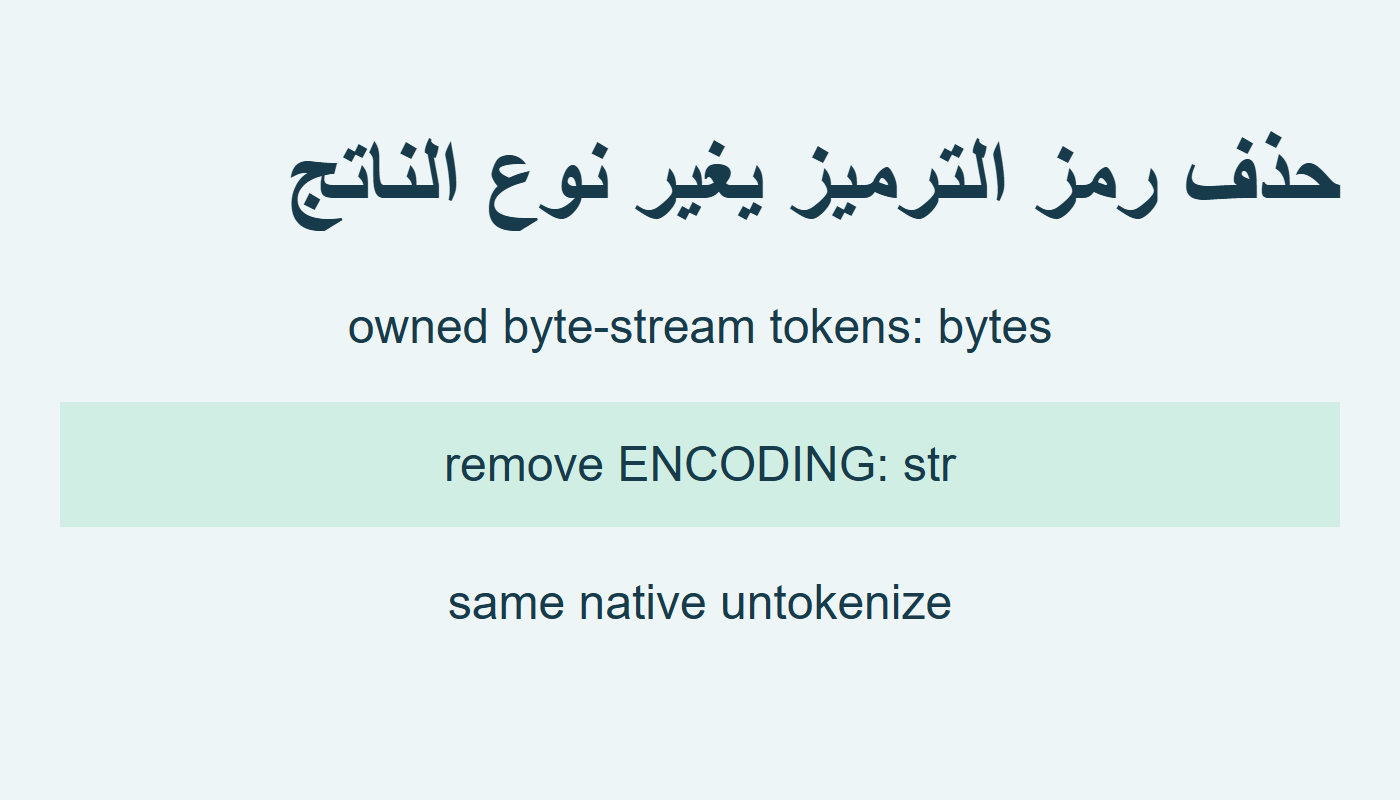
ضبط والنطاق
حذفنا ENCODING من قائمة البايتات في ضبط مستقل؛ صار الناتج str. [1] [2]
شيفرتنا صالحة؛ اختبرنا 3.12.14 في الذاكرة. [1] [2]
المراجع
- Python 3.12: ENCODING and output type
- CPython 3.12.14: tokenizer wrappers
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.