
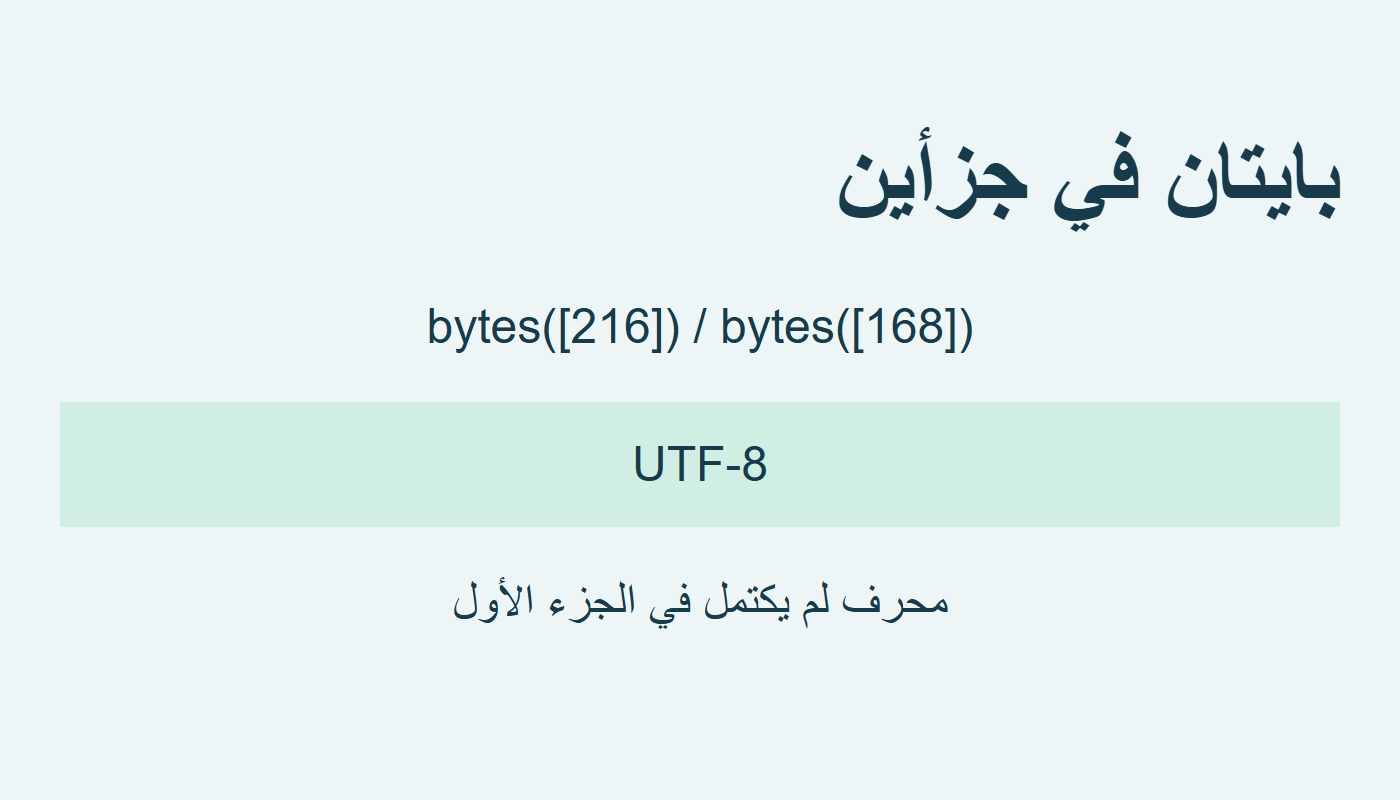
حد الجزء ليس بالضرورة حد المحرف. [1] [2]
الخلاصة السريعة
نعم، يعالج الفك التدريجي انقسام المحرف بين جزأين في مثالنا. [1] [2]
المثال
import codecs
parts=[bytes([216]),bytes([168])]
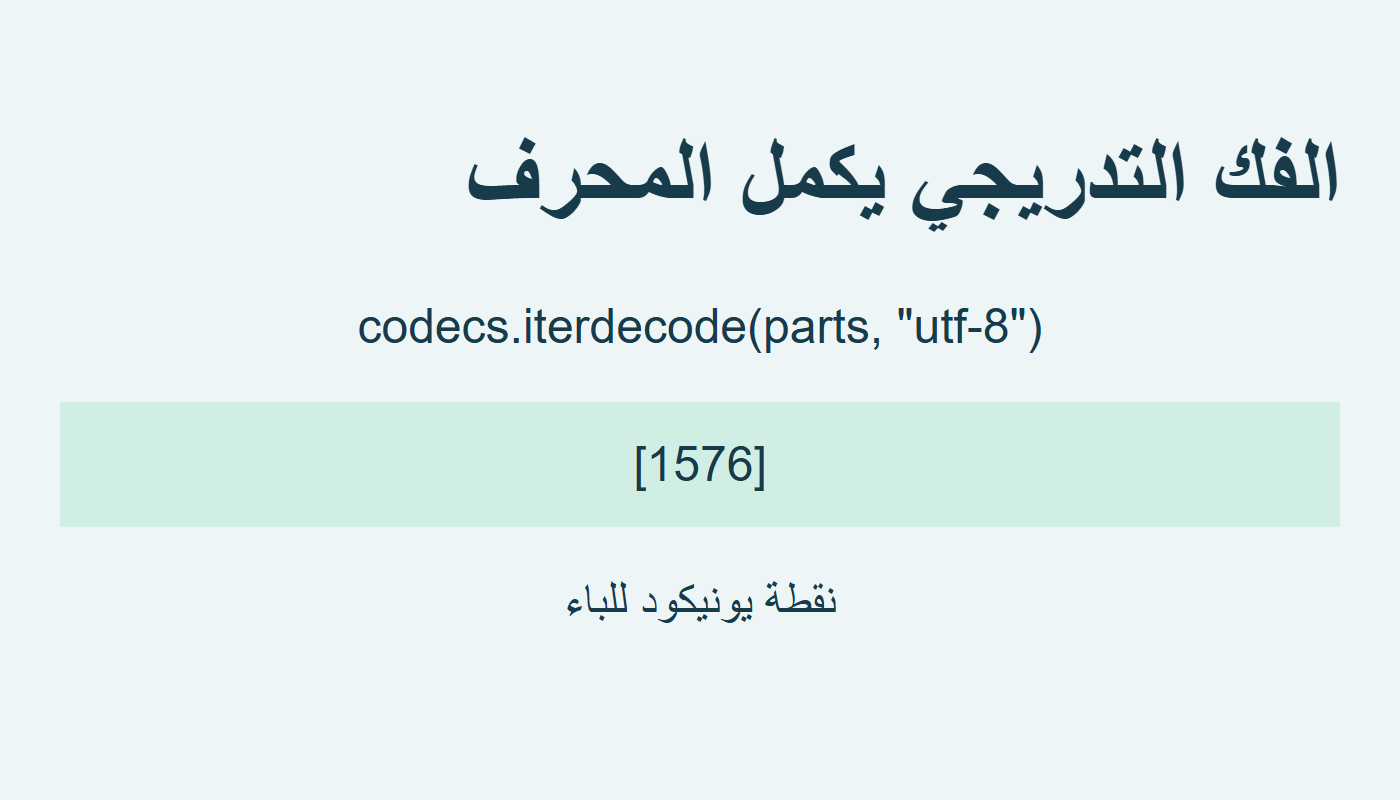
text=''.join(codecs.iterdecode(parts,'utf-8'))
print([ord(c) for c in text])
try:
    parts[0].decode('utf-8')
except UnicodeDecodeError:
print('incomplete')الأجزاء والمخرج
المصدر هنا يستخدم مفككًا تدريجيًا واحدًا ثم ينهي الفك عند انتهاء المدخل. المخرجان [1576] وincomplete. لا نطلب أن يعيد كل جزء محرفًا؛ لا يصدر الجزء الأول وحده نصًا في تجربتنا. [1] [2]
النهاية
إذا انتهى المدخل عند البايت الأول، يثير استكمال المولد خطأً بدل انتظار جزء غير موجود. التقسيم لا يصلح بايتات تالفة؛ المثال محرف صحيح مكتمل في جزأين. [1] [2]
المراجع
- Python 3.12: codecs.iterdecode
- CPython 3.12.14: codecs.py
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.