
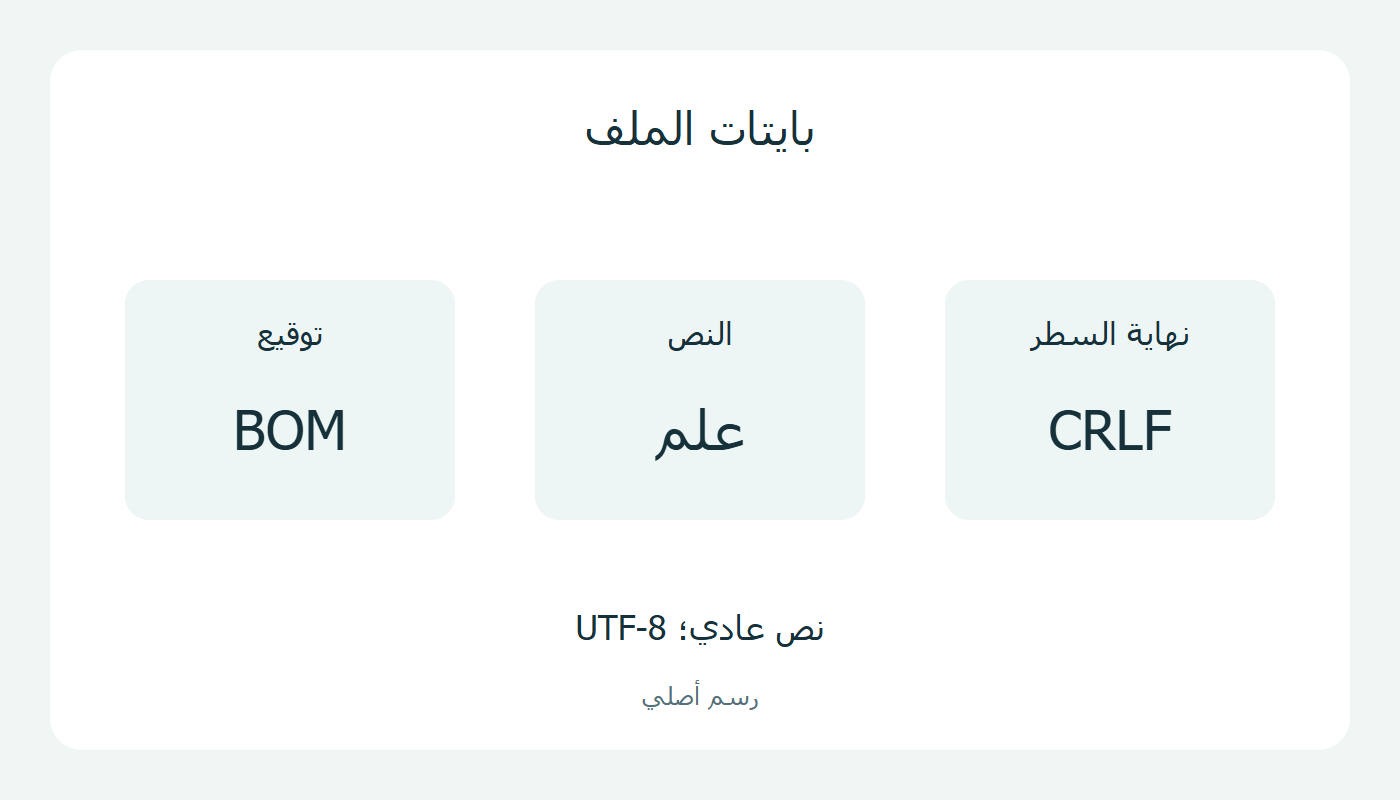
حجم ملف UTF-8 يُقاس بالبايتات. يحول Python النص إلى بايتات بالترميز المحدد. [2] سنقارن نسخاً من «علم» بنهايات سطر وتوقيع مختلفين.
الخلاصة السريعة
عدّ جميع البايتات: النص ونهاية السطر والتوقيع الموجود.
- المثال نص عادي بترميز UTF-8: «علم» دون تشكيل أو مسافات = 6 بايتات.
- مع LF يصبح 7 بايتات، ومع CRLF يصبح 8.
- BOM: 3 بايتات؛ مع «علم» وCRLF يصبح 11. راجع متطلبات البرنامج. [1]
- عدّ نتيجة encode أو read_bytes بـlen. [2][3][4]
- سجّل النص والترميز ونهاية السطر ووجود BOM؛ لا تعمم نتيجة النص العادي على ملف بتنسيق مختلف.
حدد الملف الذي تقارنه
نقارن هنا ملفاً نصياً عادياً يحتوي على «علم» فقط، بلا علامتي الاقتباس أو تشكيل أو مسافة أو سطر إضافي. ثم نضيف مكونات محددة إلى نسخ المثال. اخترنا الكلمة للتوضيح؛ ليست عينة من ملف سلّمه قارئ.
UTF-8 يمثل نقطة يونيكود ببايت واحد إلى أربعة. لذلك لا توجد قاعدة عامة تقول إن كل حرف يساوي بايتاً. [1]
لا تستخدم نتيجة هذا المثال لتقدير حجم وثيقة منسقة أو صفحة HTML؛ يجب أن تحدد جميع البيانات الموجودة في الملف الذي تقصده.
أضف نهاية السطر الفعلية
القراءة النصية الافتراضية قد توحّد نهايات السطور. [3]
في مثالنا: 6 بايتات للنص، وبايت واحد لـLF أو بايتان لـCRLF؛ الناتج 7 أو 8.
حددنا النهايتين صراحة؛ لم نفترض ما يختاره محرر النص تلقائياً.
احسب توقيع BOM مرة واحدة في البداية
BOM في UTF-8 هو EF BB BF: ثلاثة بايتات لتوقيع الترميز؛ بعض البرامج لا تتوقعه. [1]
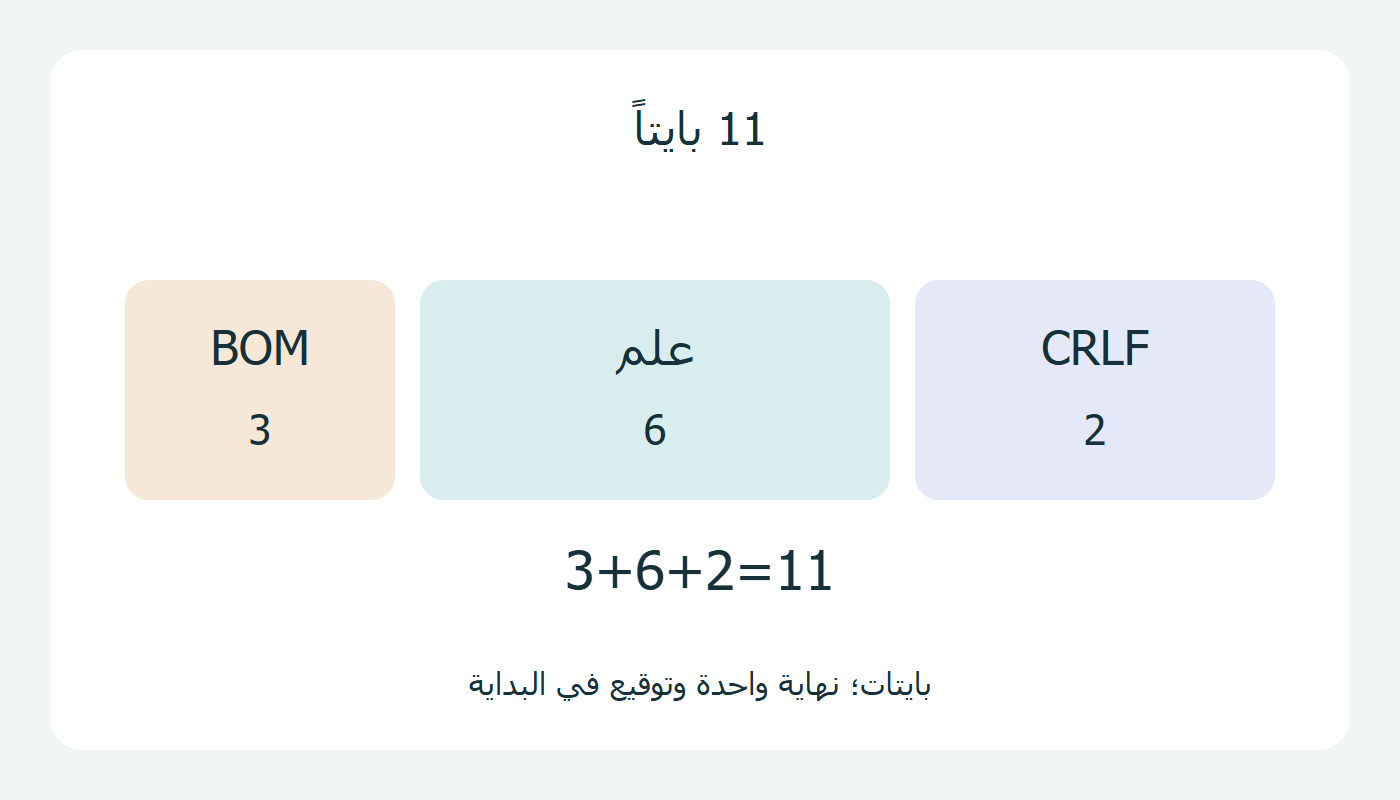
نسختنا مع BOM وCRLF: 3 + 6 + 2 = 11 بايتاً.
هذا وصف لبنية اخترناها للحساب؛ راجع متطلبات البرنامج قبل اختيار إعداد الحفظ.
الجدول التالي يفصل أثر كل إضافة. المقصود نهاية سطر واحدة بعد الكلمة، لا سطراً جديداً يحوي كلمة أخرى.
| نهاية السطر | بلا BOM | مع BOM |
|---|---|---|
| لا توجد | 6 | 9 |
| LF | 7 | 10 |
| CRLF | 8 | 11 |
تحقق بالبايتات في Python
المثال يحول الكلمة إلى bytes ويعدّها بـlen. [2][3]
لملف موجود، تعيد read_bytes محتواه الثنائي. عدّ هذه البايتات يفحص الملف الفعلي دون تحويل نهايات السطور أثناء قراءة النص. [4]
استبدل اسم العينة باسم الملف المقصود، واقرأ نسخة محفوظة قبل تغيير إعدادات محرر النص. المثال القصير مناسب لملف صغير؛ لا يتضمن كتابة فوق الملف.
payload="علم".encode("utf-8")
print(len(payload))
bom=b"\xef\xbb\xbf"
end=b"\r\n"
print(len(bom+payload+end))
الناتجان: 6 ثم 11 بايتاً.
import pathlib
p=pathlib.Path("sample.txt")
print(len(p.read_bytes()))
اجعل النتيجة قابلة لإعادة الحساب
اكتب مع النتيجة: النص المختار، والترميز، ونهاية السطر، ووجود BOM. استخدم سجلاً فارغاً: «النص: ____؛ الترميز: ____؛ النهاية: ____؛ التوقيع: ____؛ عدد البايتات: ____». املأه من النسخة التي تقصدها.
إذا اختلف قياس ملفك، قارن بايتاته بمكونات المثال قبل افتراض خطأ العد. قد تكون النسخة التي تقرأها مختلفة عن النص الذي قصدته. احتفظ باسم النسخة وإعداداتها مع النتيجة، ولا تعتمد على شكل الكلمة وحده.
اقرأ أيضًا: ترميز CSV وفاصل الأعمدة.
المراجع
- Unicode: ترميز UTF وعلامة BOM
- Python: تحويل النص إلى بايتات
- Python: الدوال المدمجة
- Python: قراءة بايتات الملف باستخدام pathlib
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.