
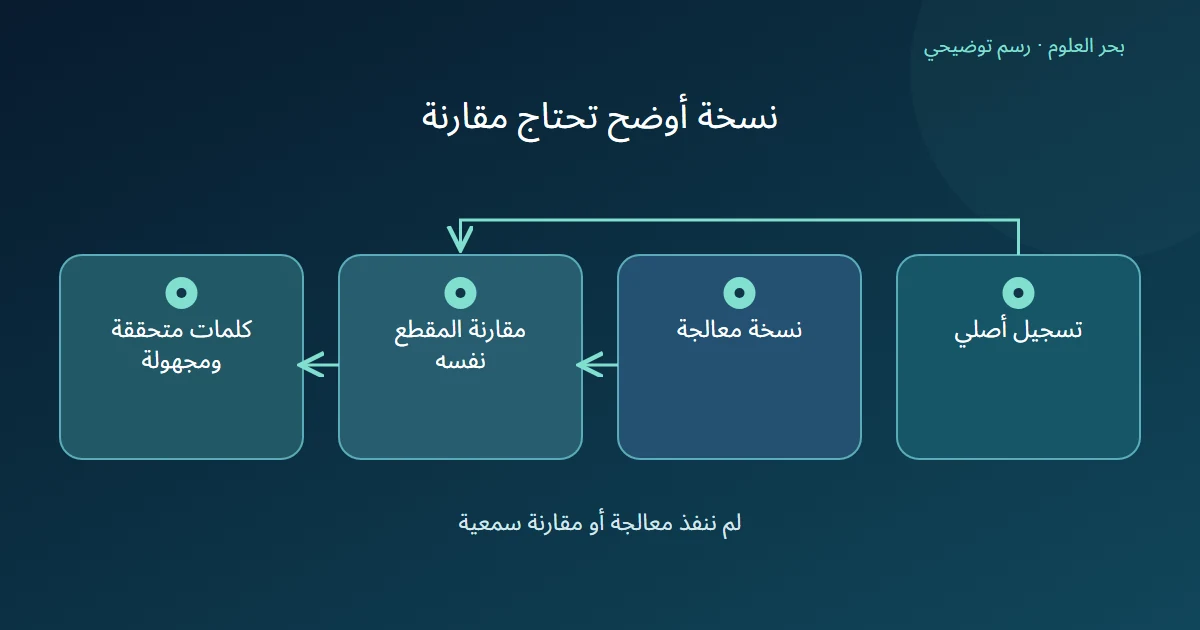
تنقية صوت التسجيل قد تجعل نسخة أسهل للاستماع، لكنها لا تجعل كل كلمة فيها أقرب إلى ما قيل بالضرورة. السؤال الذي نراجعه هو حفظ الكلام في النسخة المعالجة، لا انخفاض الضجيج وحده. مثالنا خطة مراجعة مكتوبة؛ لم ننق ملفا أو نسمع نتيجة مولدة بالذكاء الاصطناعي.
الخلاصة السريعة
احفظ الأصل وراجع المقاطع المهمة في النسخة المنقاة؛ الانطباع بوضوحها لا يكفي لإثبات بقاء الكلمات أو حسم ما كان غير مسموع.
- يعرض DeepFilterNet تحسين الكلام بالتصفية العميقة؛ هذا وصف لمهمة النظام، وليس شهادة بأنه استعاد كلمات تسجيل لم نفحصه. [1]
- ينبه دليل تقليل الضجيج في Audacity إلى أن المعالجة قد تزيل أجزاء من الصوت المراد حفظه؛ هذا أثر موثق لبرنامج محدد، وليس معدل خطأ لكل أداة ذكاء اصطناعي. [2]
- في تمريننا نقارن المقطع نفسه من الأصل والنسخة المعالجة، ونبقي كلمة «لا» أو إسنادها غير محسوم إن لم يتضح الصوت؛ لا نملأها من جملة أسلس.
- ثبت حدود المقطع ونسخة الملف وأي قص أو تغيير للسرعة؛ احفظ النسخة المعالجة كمشتق، ولا تستبدل بها الأصل أو تعد نجاح مقطع ضمانا للتسجيل كله.
ما الشيء الذي تحاول المعالجة تحسينه؟
يصف مشروع DeepFilterNet نفسه إطارا لتحسين الكلام يعتمد على التصفية العميقة. [1]
في المراجعة التي نقترحها نعلن غرضا محدودا: تسهيل الاستماع إلى تعليمات داخل تسجيل مع الاحتفاظ بمصدرها. «أقل ضجيجا» حكم على جانب من الصوت، و«يحفظ الكلام» سؤال آخر. لا نقرر من اسم المنتج أيهما تحقق، ولا ننقل نتائج تجارب منشورة إلى ملف لم نسمعه.
هل كل ما يختفي من النسخة ضجيج؟
في إرشادات Audacity، زيادة تقليل الضجيج أو الحساسية قد تضر بالصوت المراد الاحتفاظ به. ويتيح البرنامج الاستماع إلى الجزء الذي سيزال لفحص ظهور أجزاء من الصوت المطلوب فيه. [2]
نستخدم هذا المثال لفهم خطر الخلط بين إزالة شيء غير مرغوب وإزالة جزء نحتاجه؛ لا ندعي أن Audacity هنا نموذج ذكاء اصطناعي، أو أن أدوات التصفية العميقة تعرض الخيار نفسه. عند استخدام أداة أخرى نقرأ وظائفها الفعلية قبل اقتراح خطوة خاصة بواجهتها.
كيف تقارن المقطع بدلا من الانطباع العام؟
نفترض تعليمات عن إرسال مسودة، وفي جزء قصير يحتمل أن تكون العبارة «لا ترسلها اليوم» أو «أرسلها اليوم». هذه احتمالات مكتوبة لا كلمات سمعناها. لو بدت النسخة المعالجة أنعم، لا نحول الاحتمال الثاني إلى تفريغ معتمد لأن الجملة أكثر سلاسة.
نقارن الجزء المقابل من النسختين، ثم نكتب ما استطعنا التحقق منه وما بقي ملتبسا. إذا لم يحسم الأصل والنسخة موضع النفي، يظل القرار معلقا؛ توافق النص الذي يقترحه مساعد مع توقعنا لا يعوض المعلومة الصوتية المفقودة. وقد نفهم باقي الجملة بينما تظل الكلمة المؤثرة وحدها مجهولة.
أي نسخة تحفظ وأي حدود تسجل؟
نسمي الملف الأصلي ونسخة المعالجة بوضوح، ونحفظ وصف الإجراء الذي طبق فعلا إذا كانت لدينا تجربة لاحقا. وإذا قصصنا بداية الملف أو غيرنا سرعته، نراجع علاقة الموضع الجديد بالأصل قبل القول إننا نقارن الثانية نفسها. التعديل في الزمن غير التعديل في وضوح الصوت.
ولا نعرض تسجيلنا المشتق بوصفه نسخة خاما التقطها الميكروفون. نجاح المراجعة في مقطع واحد لا يغطي مقاطع أضعف أو مختلفة في بقية الملف. هنا لم نجر مقارنة سمعية أو اختبار دقة؛ حددنا كيف نتجنب أن تتحول جاذبية النسخة المنقاة إلى ادعاء باستعادة كلام غير متحقق.
المصادر ومتابعة القراءة
- DeepFilterNet: Official project README (يفتح في نافذة جديدة)github.com
- Audacity Manual: Noise Reduction (يفتح في نافذة جديدة)manual.audacityteam.org
أُعدّ هذا المقال بصياغة عربية أصلية بالاستناد إلى المصادر أعلاه، وهو مدخل تمهيدي إلى الموضوع. اقرأ منهجية المحتوى وحدوده.