
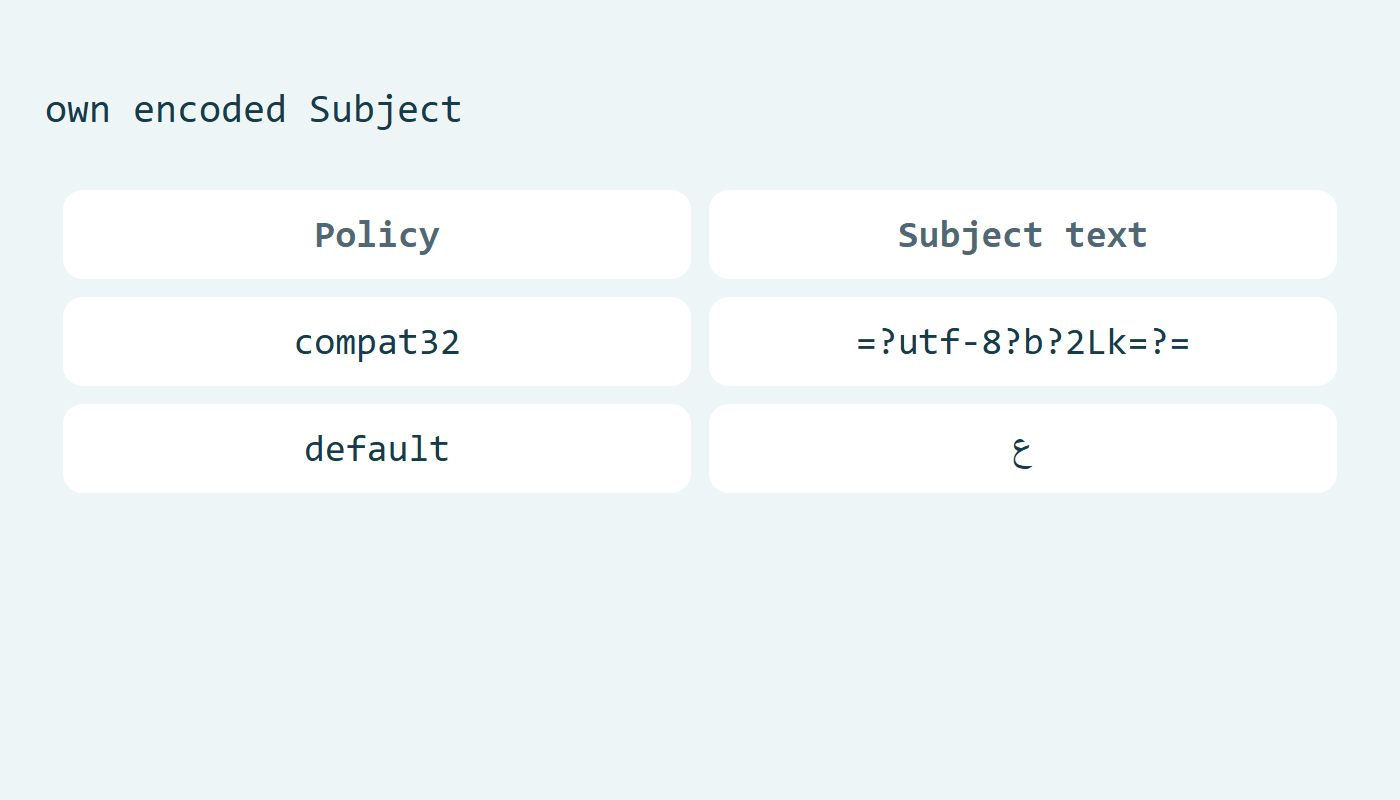
نقرأ رأسًا مشفرًا من رسالة مؤلفة. [1] [2] [3]
الخلاصة السريعة
المثال
from email.parser import (
 BytesParser as B)
from email import policy as p
t='=?utf-8?b?2Lk=?='
m=('Subject: '+t+'\r\n\r\n').encode()
print(B().parsebytes(m)['Subject'])
r=B(policy=p.default).parsebytes(m)
print(str(r['Subject']))الناتجان =?utf-8?b?2Lk=?= ثم ع. [1] [2] [3]
القيمة والسياسة
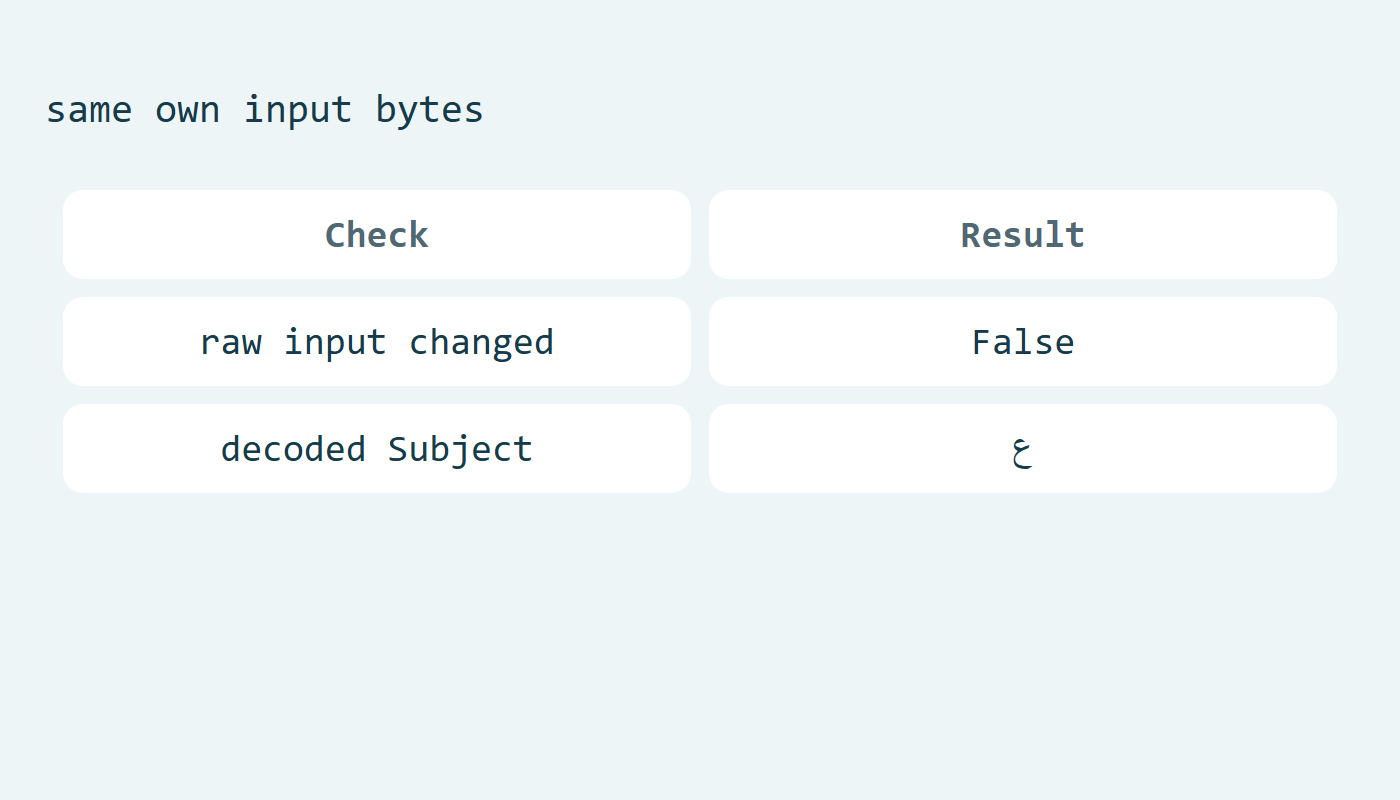
السياسة تؤثر في القيمة عند قراءة الرأس. يعطينا الاختيار الحديث نصًا مفكوك الترميز؛ تبقى بايتات رسالتنا الأصلية كما هي. [1] [2] [3]
حدود المثال
رأس قصير بترميز محدد. لم نفحص المرفقات أو الرؤوس المعطوبة، ولا نضمن النتيجة لكل إصدار. [1] [2] [3]
المراجع
- Python: email.parser
- CPython 3.12.14: email/parser.py
- Python: email.policy
- موضوع تك: لغة بايثون — مفردات
- موضوع تك: تطبيقات بايثون — مفردات
أُعدّ هذا المقال بمساعدة الذكاء الاصطناعي، وخضع لمراجعة ذاتية بالأداة نفسها. لا يُنسب إلى مراجع بشري أو خبير مستقل. منهجية المحتوى.